觀點 · 資訊分享
OpenAI 推出 GPT-Live:ChatGPT 語音改成「邊聽邊說」,難題還能交給 GPT-5.5 在背景處理
OpenAI 在 7 月 8 日推出新一代語音模型 GPT-Live:採用能同時聽與說的全雙工架構,讓 ChatGPT 語音能自然插話、等你思考;遇到搜尋或複雜問題,會交給 GPT-5.5 在背景處理。API 版本官方說「很快」。
- 發布
- 2026-07-08
- 篇幅
- 約 4 分鐘 · 1,877 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
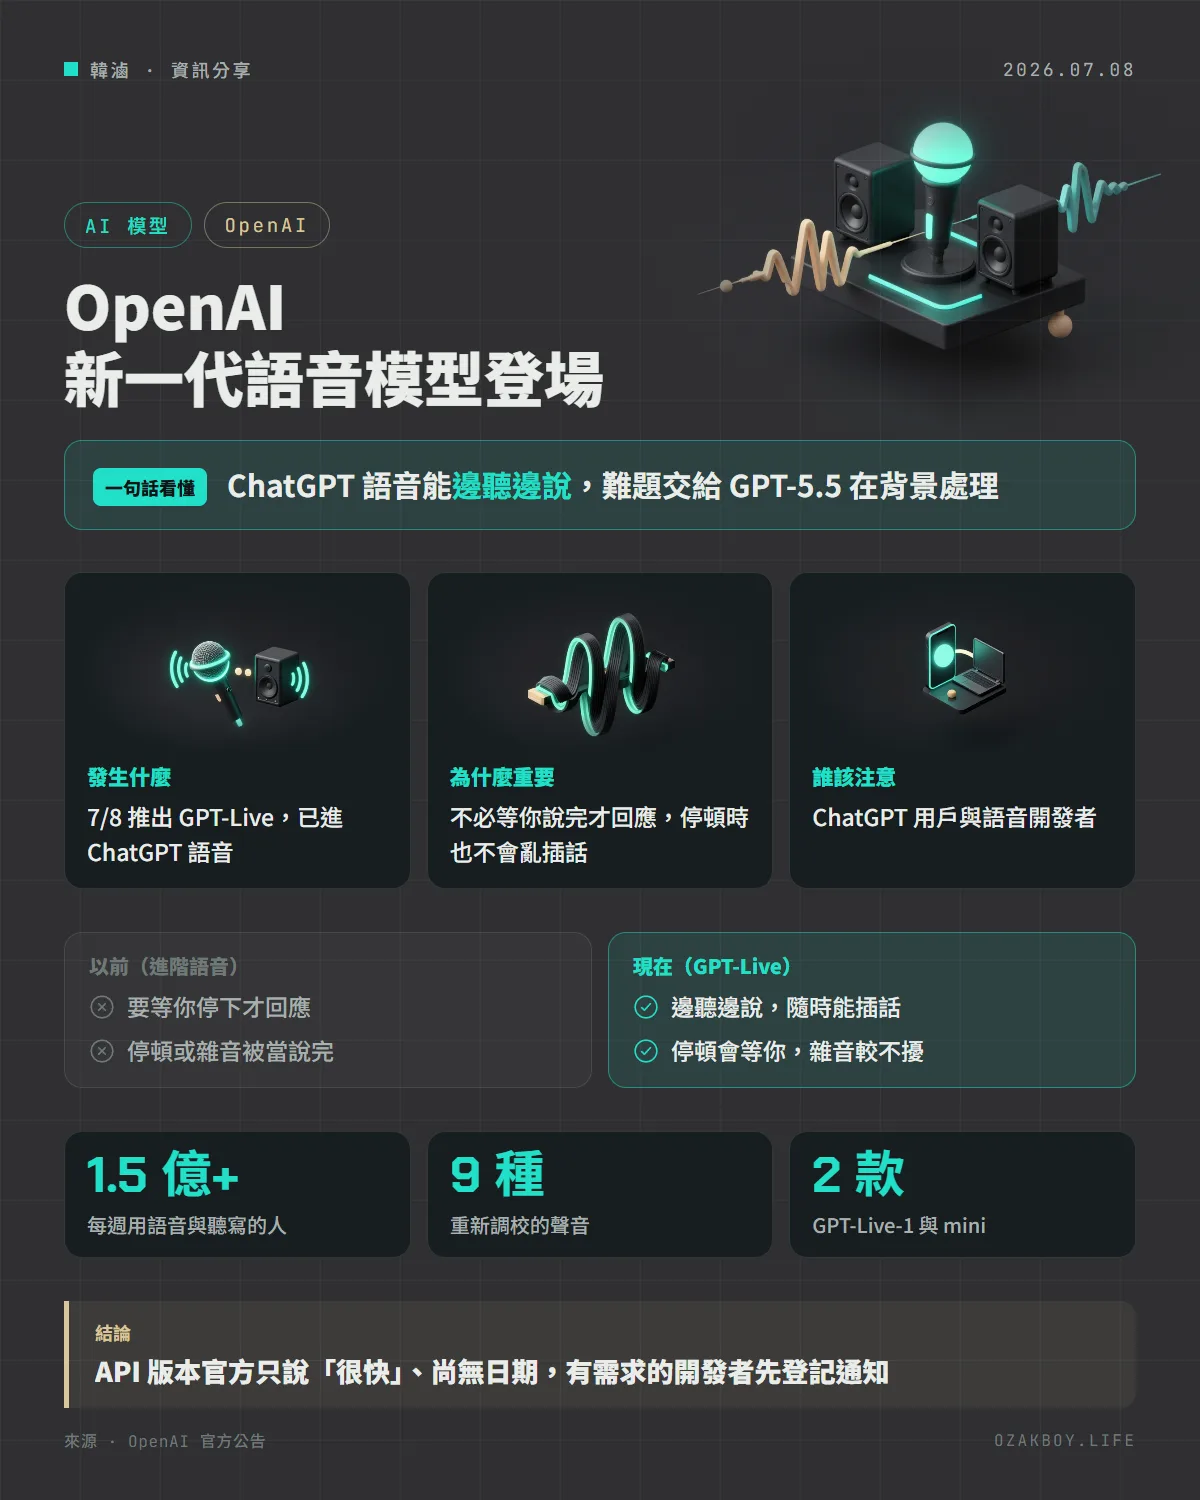
一句話看懂:OpenAI 的新語音模型 GPT-Live 能「邊聽邊說」,已經用在 ChatGPT 語音,遇到難題會交給 GPT-5.5 在背景處理,API 版官方說「很快」。
先用白話講:以前的語音 AI 差在哪?
你和朋友講電話,對方會一邊聽一邊「嗯、對」,你停下來想一想,他也會等。但過去的語音 AI 比較像用對講機:你說完按下結束,它才開始回答。
OpenAI 在公告裡把過去的做法分成兩代:
- 串接式:原本的 ChatGPT 語音,是三個模型接力:語音轉文字、語言模型想答案、文字轉語音。資訊會在接力中流失,回應也慢且生硬
- 回合制:進階語音模式把處理合在一個模型裡,變快變順,但還是要等你說完才回應,而且用「靜音」判斷你說完沒,一個短暫的停頓或背景雜音,就可能被誤判成說完而亂插話
發生什麼事
OpenAI 在 2026 年 7 月 8 日推出 GPT-Live,這是新一代語音模型,已用在 ChatGPT 語音。兩個關鍵的設計:
- 持續互動(全雙工):不再一段一段處理,而是持續聽、同時持續說,每秒可以多次決定:要說話、繼續聽、暫停、打斷,還是呼叫工具。因此能自然地插話、維持時間感,甚至做即時翻譯
- 把深度工作外包:負責互動的 GPT-Live 和負責深度思考的模型分開。遇到搜尋、推理或複雜任務,就交給另一個模型(上線時是 GPT-5.5),自己繼續陪你聊,等結果好了再帶回對話
ChatGPT 語音有什麼變化
| 項目 | 說明 |
|---|---|
| 更自然的對話 | 可以隨時插話、請它放慢;會用「嗯哼」「了解」表示在聽;九種聲音都重新調校 |
| 更聰明的回答 | 可選推理程度:即時(Instant)、中(Medium)、高(High) |
| 更好的聆聽 | 你停下來思考時它會等;請它安靜聽就會安靜;背景雜音下更能專注在你的聲音 |
| 視覺卡片 | 對話中可顯示天氣、股價、運動等視覺卡片;仍支援搜尋、記憶、圖片與檔案上傳 |
供應範圍與限制
- GPT-Live-1 與 GPT-Live-1 mini 從公告當天開始,推送給全球 ChatGPT 用戶(iOS、Android 與 ChatGPT.com);Go、Plus、Pro 用戶預設是 GPT-Live-1,免費用戶預設是 mini
- 官方針對 ChatGPT 中較熱門的語言做最佳化;部分語言可能有非母語口音或流暢度不足
- 上線時不支援語音搭配視訊或螢幕分享,仍可使用舊版(標準與進階語音模式)
- 官方公告引述,每週有超過 1.5 億人使用語音與聽寫功能
- 安全面:新增音訊原生的安全評測,並設計可在模型說話當下介入的防護;只使用預先設定的聲音,並防止模仿真人聲音;家長可透過家長控制決定青少年能否使用語音
後續:官方在 2026 年 7 月 31 日更新,說明透過 ChatGPT 語音與 OpenAI API 以 GPT-Live 產生的支援音訊,現在帶有 SynthID 浮水印,並提供驗證工具與 API 讓開發者檢查來源訊號。
給開發者的技術細節
- API 版還沒開放:官方只說計畫很快帶到 API,並提供登記通知的表單
- 想先做語音產品原型,可以參考官方同期的即時語音模型(7 月 6 日更新的 GPT-Realtime-2.1 系列),但那是另一條產品線,不等同 GPT-Live
- 官方評比提到 GPT-Live-1 在 GPQA(專家級科學推理)、BrowseComp(網頁搜尋)與電信客服的語音代理評測上,明顯勝過進階語音模式;評測細節與數字沒有逐項公開在公告內文,這裡不引用
我的看法
「邊聽邊說」是這一代語音 AI 最重要的轉折,因為它解的是語音介面最根本的不自然:不是聲音不夠像人,而是對話節奏不像人。如果真的做到「等你想、會插話、不被雜音騙」,語音就有機會從噱頭變成日常工具,特別是開車或雙手忙碌的時候。
對想做語音產品的開發者,目前最實際的是兩件事:先看官方什麼時候開 API,以及關注它對繁體中文與台灣口音的表現。官方自己也承認不同語言有口音與流暢度的落差,這部分一定要自己測,不能只看英文的展示影片。
名詞小辭典
- 全雙工(Full-duplex):雙方可以同時傳送與接收,像電話;對比的是對講機式的輪流說話。
- 串接式語音系統:用語音轉文字、語言模型、文字轉語音三個模型接力處理的做法。
- 委派(Delegation):負責對話的模型把需要深度思考或搜尋的工作交給另一個模型。
- SynthID:一種內容浮水印技術,用來標示音訊或影像是 AI 產生的。
資料來源
常見問題
「全雙工」是什麼意思?
像電話一樣,雙方可以同時說話、同時聽。傳統語音模型多半是「你說完、我才說」的回合制,用靜音來判斷你說完沒,所以一停頓或有雜音就可能被誤判。GPT-Live 則是持續處理輸入,同時產生輸出。
它比以前的 ChatGPT 語音好在哪裡?
依官方說明:可以隨時插話或請它放慢;會用「嗯哼」「了解」這類回應表示在聽;你停下來思考時它會等;背景有車聲或旁人說話時更能專注你的聲音;還能在對話中顯示天氣、股價、運動比分等視覺卡片。官方也說在配對的 5 到 10 分鐘對話評比中,使用者明顯偏好 GPT-Live 勝過進階語音模式。
開發者現在能用 API 嗎?
還不行。官方說計畫「很快」把 GPT-Live-1 與 mini 帶到 API,開發者與企業可以填表單登記通知,沒有給具體日期。
接著讀
全部觀點 →OpenAI 推出 GPT-Realtime-2.1 與 mini 版:語音 AI 更聽得懂英數字與雜音,mini 輸入價 0.6 美元OpenAI 在 7 月 6 日的 API 更新日誌釋出 GPT-Realtime-2.1 與更快、更便宜的 mini 版:改善英數字辨識、靜音與雜音處理、被打斷時的反應,適合做語音客服與語音助理。閱讀 →OpenAI Decisions API 正式上線:專答「是不是、選哪個」的小決策,輸入每百萬 token 0.1 美元OpenAI 在 10 月 22 日讓 Decisions API 正式上線。它把 GPT-6 Luna 專門用來回答有固定答案的判斷題,官方說最快比 Responses API 快 10 倍,輸入每百萬 token 只收 0.1 美元,輸出不收費。閱讀 →OpenAI API 推出 12 小時提示快取:同一段話重複問 AI,用越多次越便宜OpenAI 讓 API 可以把重複使用的提示詞「記住」12 小時(原本只有 30 分鐘)。第一次要多付一點,但同一段內容用到第 3 次就開始省錢,用 12 次大約省下 7 成。閱讀 →