觀點 · 資訊分享
Amazon DynamoDB 正式支援向量搜尋:不用再多養一套向量資料庫,單位數毫秒就能查出意思相近的資料
AWS 在 8 月 5 日宣布 DynamoDB 向量搜尋正式上線,可以把 embedding 和原本的資料放在同一張表,官方稱延遲是個位數毫秒、召回率 99% 以上。
- 發布
- 2026-08-06
- 篇幅
- 約 4 分鐘 · 1,912 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
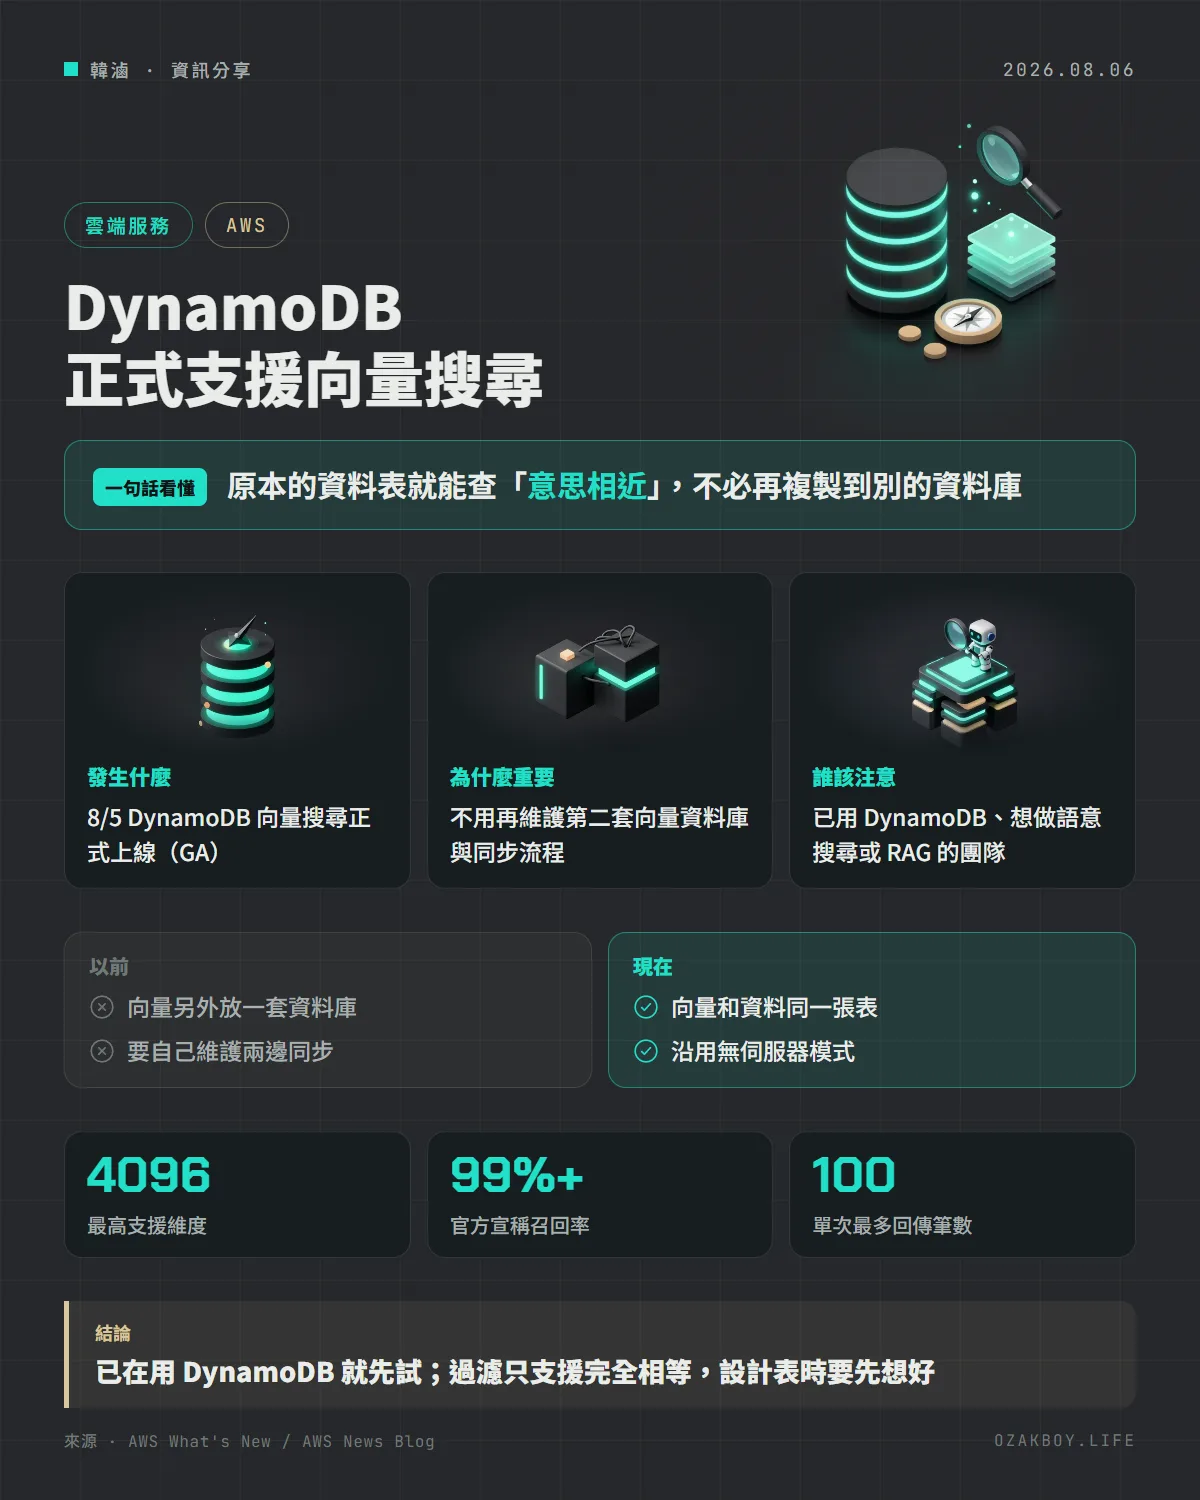
一句話看懂:AWS 讓 DynamoDB 正式支援向量搜尋,商品、文件的「意思相近」查詢可以直接在原本的資料表裡做,不必再把資料複製到另一套向量資料庫。
先用白話講:向量搜尋是什麼?
想像你在大賣場找「夏天穿的輕便跑鞋」。傳統搜尋像是比對標籤,商品名稱沒有「輕便」兩個字就找不到。向量搜尋則像一位懂你意思的店員:他不看字面,而是把每樣商品的描述都轉成一串數字(稱為 embedding,可以想成「意思的座標」),意思越接近的商品,座標就越靠近。你一問,他就帶你走到座標最近的那一區。
這串座標要有地方存、有辦法快速比對,所以過去很多團隊會另外架一套專門的「向量資料庫」。
發生什麼事
AWS 在 8 月 5 日宣布,Amazon DynamoDB 的向量搜尋正式上線(GA)。官方的說法有幾個重點:
- 查詢延遲是個位數毫秒,召回率(找回真正相近結果的比例)在 99% 以上
- 設計上能撐到兆級的向量數量,向量索引沒有儲存空間上限
- 完全無伺服器:沒有要自己維護的機器、沒有維護時段、不停機
- 計費沿用 DynamoDB 的「用多少付多少」模式
- 所有商業 AWS 區域與 GovCloud(美國)區域都能用
以前和現在差在哪
| 項目 | 以前 | 現在 |
|---|---|---|
| 資料放哪 | 營運資料在 DynamoDB,向量另外放一套向量資料庫 | 向量跟原本的資料放在同一張表 |
| 同步 | 要自己維護兩邊的同步流程 | 不需要同步流程 |
| 維運 | 兩套系統各自管 | 沿用 DynamoDB 的無伺服器模式 |
官方也提到,原本就拿 DynamoDB 存 AI 代理(agent)記憶的人,現在可以直接在那份記憶上做語意檢索。
給開發者的技術細節
做法是三步:
- 用你選的模型(官方舉例有 Amazon Bedrock 的 Titan Text Embeddings、Cohere Embed、OpenAI 的 embedding 模型)把文字轉成向量,用一般的
PutItem或UpdateItem存成數字清單,不需要新的資料型別 - 在表上建立「向量索引」,指定維度數、距離函數,以及要拿來過濾的屬性
- 呼叫
SearchVectorsAPI,丟入查詢向量與要回傳的筆數(最多 100 筆),就會依相似度排序回傳
幾個限制要先知道:
- 最多支援 4096 維;距離函數可選 Euclidean、Cosine、Dot product
- 過濾條件只支援「完全相等」,不支援
BETWEEN、BEGINS_WITH這類範圍條件 - 向量索引可以指定一個分區鍵,每次搜尋只會在單一分區鍵值內進行;資料量大、查詢量高時官方建議設定
- 相似度分數的意思看距離函數而定:Cosine 與 Euclidean 是數字越小越相近,Dot product 則是越大越相近
- 官方沒有在公告中說明價格細節,請看 DynamoDB 定價頁,上線前先試算
我的看法
我自己接案時最常碰到的情況,是中小企業的系統已經有一張商品或文章的表,老闆突然想要「用講的就能搜到」。以前這個需求往往卡在要多養一套向量資料庫,維運與費用都讓人猶豫。如果資料本來就在 DynamoDB,這次的更新確實把門檻降低不少。
不過我會提醒兩件事。第一,「過濾只能完全相等」和「一次搜尋限定在單一分區鍵值」代表查詢方式要在設計表的時候就想好,不是隨便都能補救。第二,向量搜尋的好壞一大半取決於你選的 embedding 模型,換模型就得整批重算,這筆成本別忘了算進去。小專案先用少量資料試跑,確認結果符合預期再上線。
名詞小辭典
- Embedding(向量嵌入):把文字轉成一串數字,用數字之間的距離代表意思的遠近。
- 召回率(Recall):在所有真正相近的結果裡,系統實際找回來的比例,越高代表漏掉的越少。
- 無伺服器(Serverless):不用自己準備、維護主機,用多少算多少。
- RAG(檢索增強生成):讓 AI 回答前先去資料庫查資料,再根據查到的內容作答。