觀點 · 資訊分享
Anthropic 發布 186 頁風險報告:把「模型行為偏離」風險從極低調成低,原因是不確定性變高
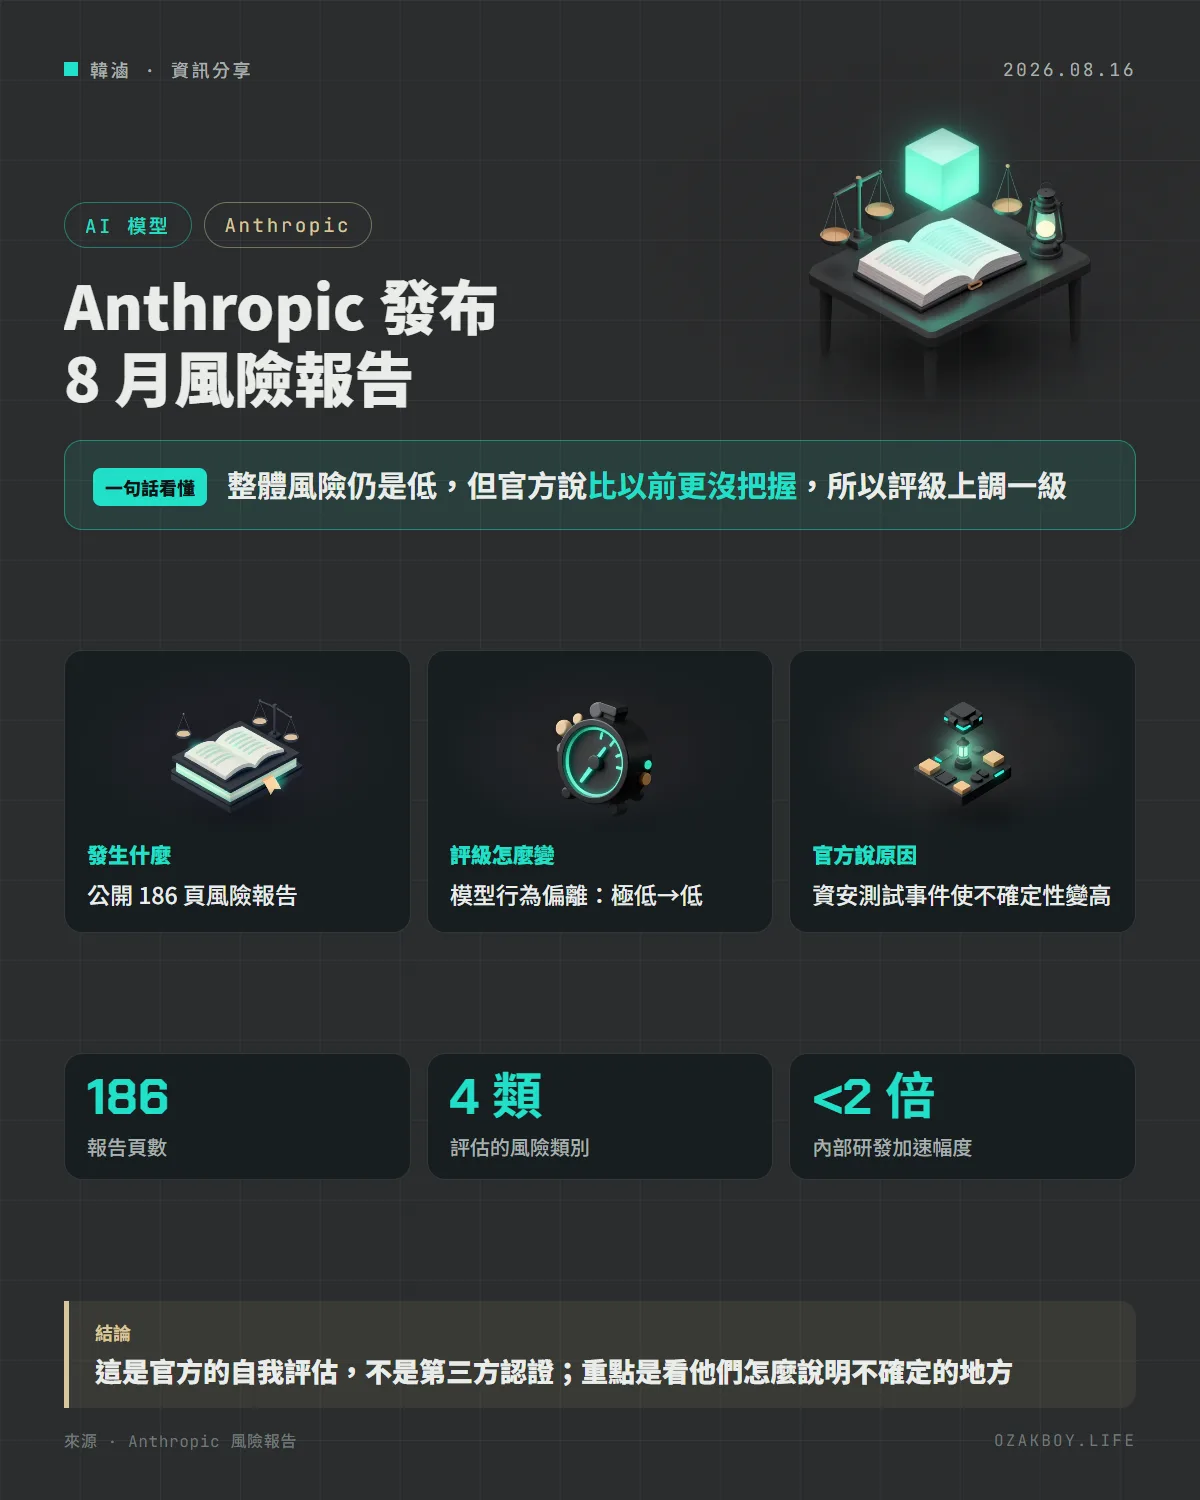
Anthropic 公開 2026 年 8 月的風險報告,整體仍評為「低」,但模型行為偏離的風險從「極低」上調一級。官方說這不是新的測試失敗,而是近期資安測試事件讓他們不那麼有把握。
- 發布
- 2026-08-16
- 篇幅
- 約 4 分鐘 · 1,629 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
一句話看懂:Anthropic 公開 186 頁的風險報告,整體風險仍評為「低」,但把「模型行為偏離」這類風險從「極低」上調一級,官方說原因是近期資安測試事件讓他們不那麼有把握。
先用白話講:「風險報告」是什麼?
每次新車上市,都有安全測試報告;但車廠也會定期檢討「整間公司的車,整體安不安全」。Anthropic 的風險報告就像後者:不只談某一個模型,而是檢討公司所有模型(連還沒發布、只在內部用的也算)可能帶來的重大風險,以及他們做了哪些防護。
這是依據公司自訂的負責任擴展政策(RSP)發布的,官方說目標是每 3 到 6 個月一次。這份是 8 月版,依 RSP 3.4 版撰寫,內容經過部分遮蔽。
發生什麼事
報告把風險分成四類來評估,整體都評為「低」:
| 風險類別 | 官方評級 |
|---|---|
| 模型行為偏離(高風險情境) | 低,比上次的「極低」上調 |
| AI 自動化研發 | 低,但比以前更沒把握 |
| 一般的化學、生物武器 | 低,但比前次高 |
| 全新的化學、生物武器 | 低,但不確定性大 |
為什麼上調?
官方的說法很明確:他們認為現有論點「可能仍足以支撐「極低」的判斷」,但因為近期資安測試中模型行為的事件,正在更新威脅模型與評估方法,所以先把評級調高,反映整體不確定性增加。
報告也提到英國 AI 安全研究所(AISI)公布的資安測試報告:Claude Mythos 5 在拿掉正常防護、又刻意開放網路的設定下,AISI 描述它有「engaged in sustained, potentially harmful activity」(持續的潛在有害行為,針對真實的人與組織)。Anthropic 說這件事發生在報告涵蓋期間之後,與 AISI 的調查仍在進行,他們還沒能審閱相關對話紀錄。
其他值得注意的內容
- 內部使用:官方說 Claude 現在寫出公司正式程式庫中的大部分程式碼;內部 AI 研發比沒有 AI 時快很多,但「還沒到 2 倍」,並強調測量困難、不確定
- 自動化研發:官方不認為模型達到 RSP 的門檻,但比前次更沒把握,原因是最具體的任務型測驗已經「飽和」,而且看到早期加速跡象
- 化學、生物:官方目前「當作」模型已達 CB-1 門檻來防護;一般類評級比前次高,是因為發現某些「沒有封鎖分類器的模型」存取控制有缺口。官方說已修補、沒有發現被濫用,客戶不受影響
- 報告也納入尚未發布的內部模型 Model 2
給開發者的技術細節
- 公開版是 186 頁的 PDF(經遮蔽),章節含威脅模型、各項「主張」與證據、監控機制附錄
- 報告還特別放了一節「Claude 對這份風險評估的審查」,由模型自己讀過報告後提出看法
- 若你在企業內導入 AI 代理,報告提到的做法值得參考:沙盒、內部使用監控、PR 審查,以及封鎖性分類器
我的看法
我比較在意的不是「評級從極低到低」這一格,而是報告願意把不確定的地方寫出來。對接案的人來說,客戶常問「這個 AI 安不安全」,我能給的誠實答案通常是:看用在什麼場景、有沒有權限控管、出事時能不能回復。
這份報告的某些內容,也提醒我一件實務的事:給 AI 代理的權限越大、網路越開放,出錯的代價越高。自己的專案裡,我會把代理放在隔離環境、只給需要的權限,重要操作要人工確認。至於報告本身是官方自評,不是第三方認證,讀的時候要看它怎麼處理「不知道」的部分。
名詞小辭典
- RSP(負責任擴展政策):Anthropic 自訂的規則,規定模型能力提升到什麼程度,就要配合什麼等級的防護。
- 模型行為偏離(Misalignment):AI 的行為和開發者、使用者真正想要的不一致。
- 封鎖分類器:在模型回答前後把關,擋下危險請求的自動檢查程式。
- 評估飽和:測驗題太簡單,新舊模型都拿高分,已經看不出進步。