觀點 · 資訊分享
OpenAI 預覽「私密安全處理」:不留客戶資料,也能把多次對話放在一起抓濫用
OpenAI 公布 Private Safety Processing 預覽:在「零資料保留」的前提下,讓自動系統跨多次對話找出可疑模式,員工依然看不到內容,只收到「是哪一類風險」的訊號。
- 發布
- 2026-08-20
- 篇幅
- 約 4 分鐘 · 1,602 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
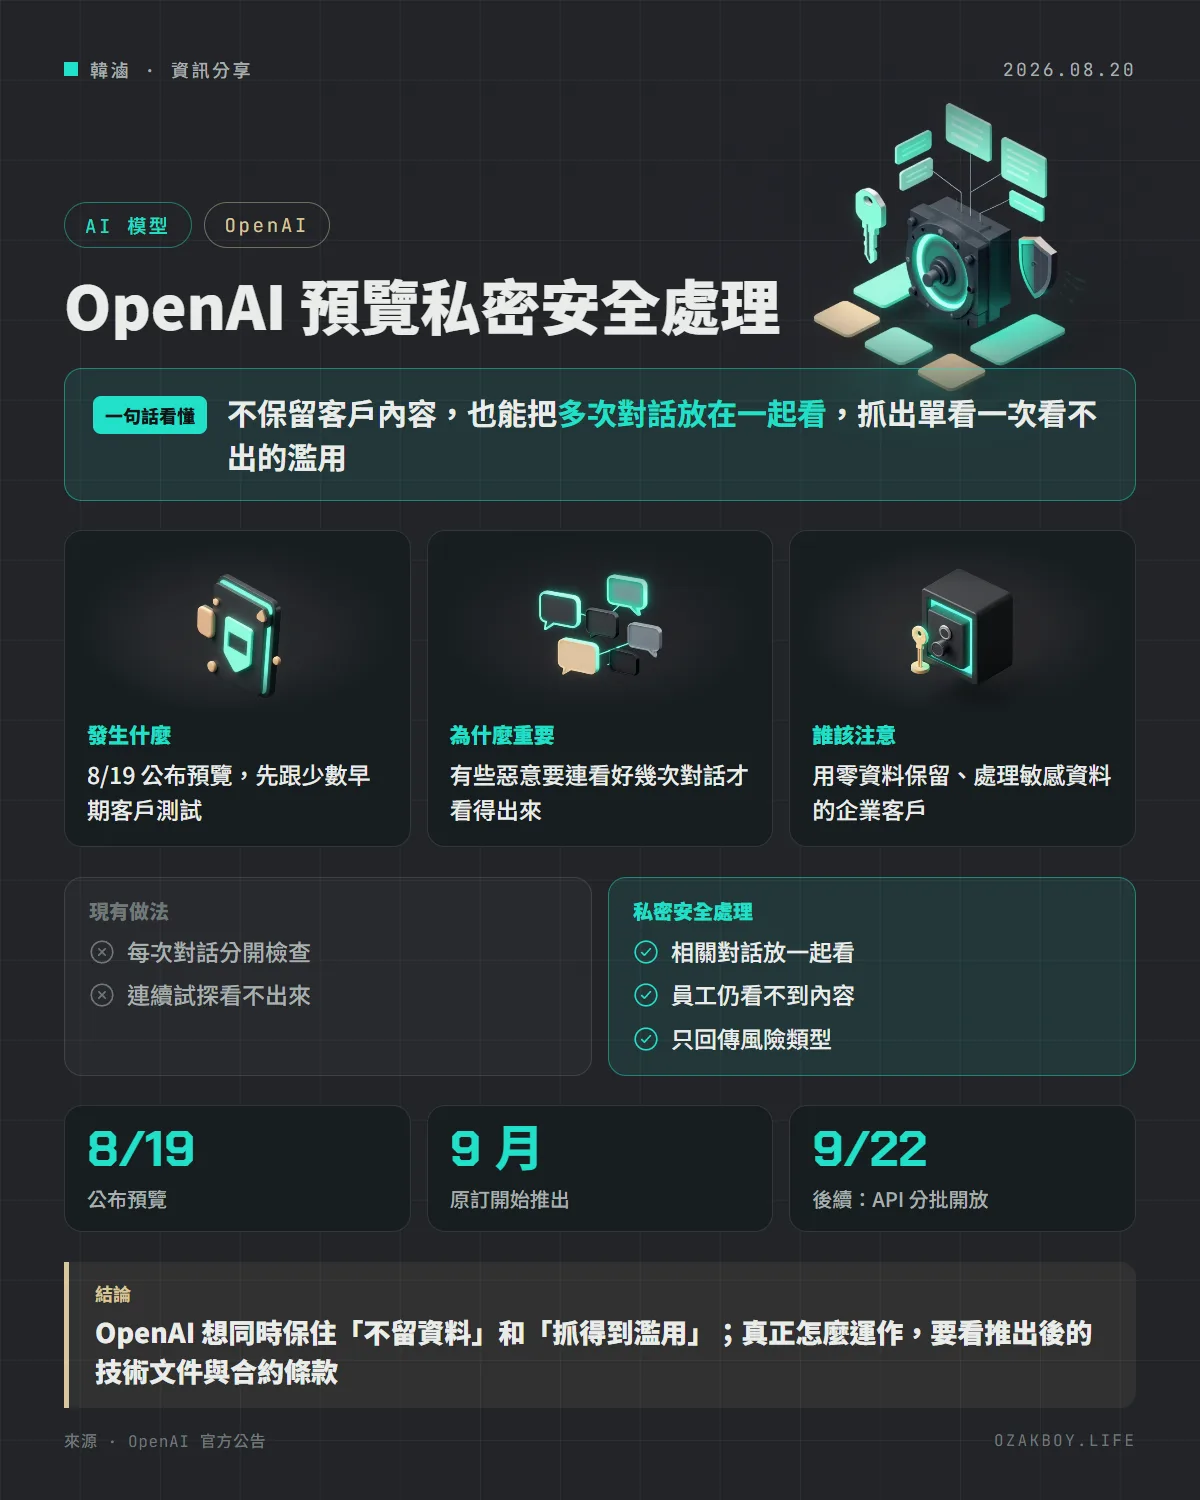
一句話看懂:OpenAI 想讓「完全不留客戶資料」的企業也能用最強的模型,做法是讓自動系統把多次對話放在一起抓濫用,但員工依然看不到內容。
先用白話講:零資料保留跟安全檢查有什麼衝突?
想像一間銀行的保全。如果保全只能看每位客人「單次」進門的畫面,那有人每天來一次、每次只問一點點金庫的事,保全永遠看不出異狀。要抓到這種人,保全需要把好幾天的畫面放在一起看。
AI 也有同樣的問題。很多企業用 OpenAI 的 API 時選擇零資料保留(Zero Data Retention,ZDR):請求處理完,提示詞和回答就不留下。這對隱私很好,但安全系統因此只能「一次看一筆」,有人分很多次慢慢試探,就不容易被發現。
發生什麼事
OpenAI 在 8 月 19 日公布 Private Safety Processing(私密安全處理) 的預覽,重點如下:
- 跨對話看模式:自動系統會把相關的多次互動放在一起分析,找出單看一次看不出的濫用
- 員工看不到內容:客戶內容放在客戶自己控制的設施裡;另一個開發中的選項是放在 OpenAI 的儲存空間,但用客戶掌握的金鑰加密,OpenAI 員工沒有這把金鑰
- 只回傳訊號:發現風險時,OpenAI 只收到「屬於哪一類活動」的有限訊號,用來判斷要不要處置;就算內容被標記,員工也看不到原文
- 客戶自己查:客戶可以用自己系統裡的資料調查警示;想申訴或說明時,再自行決定要不要提供資料給 OpenAI
公告當時,這套機制只跟早期客戶測試,OpenAI 表示預計 9 月開始推出,並公布技術白皮書。
後續(2026-09-22):OpenAI 在同一篇公告加註更新,表示已開始分批推給 API 客戶。
為什麼現在要做?
OpenAI 在公告裡講了兩個原因:
- 風險變得更長、更隱密:例如有人反覆試探防護、用多個帳號協調,或把危險意圖包裝成一般研究。AI 代理執行長時間任務時,也可能出現「叫它停了還繼續做」的偏差
- 企業不想交出資料:公告提到,近期有些前沿模型的部署要求客戶讓業者保留敏感內容做安全監控,這跟很多企業的資安義務衝突
更多細節
- 公告提到這套機制是和各產業客戶一起設計的,頁面上列出的客戶包括 Glean、Databricks、Abridge、Microsoft
- 一個例外:依法規要求,疑似兒少性剝削(CSAM)的圖片即使在零資料保留的部署中,仍會保留供人工審查與通報,這點跟以前一樣
- 公告沒有說明哪些模型、哪些方案會強制使用這套機制,細節要看後續的技術文件與合約
我的看法
接案時常遇到客戶問:「我把客戶資料丟給 AI,會不會被拿去看?」零資料保留一直是最容易說清楚的答案。OpenAI 這次的方向,是想在不打破這個承諾的情況下,補上安全檢查的漏洞,出發點我認同。
但要注意兩件事。第一,這是「預覽」,實際上「訊號」包含哪些資訊、誤判時怎麼申訴,公告都沒有講細。第二,如果你的系統要做跨對話分析,資料可能要放在自己的設施或用自己的金鑰加密,管理責任會回到你身上。處理醫療、金融資料的專案,等技術白皮書出來、合約條款寫清楚,再決定要不要依賴它比較穩。
名詞小辭典
- 零資料保留(ZDR):AI 服務處理完請求後,不保留你送出的內容與回答。
- API:讓程式跟程式溝通的窗口,企業透過它把 AI 接進自己的系統。
- 金鑰(Key):用來加密和解密資料的密碼,誰拿著金鑰,誰才能看到內容。
- AI 代理(Agent):會自己規劃步驟、連續執行多個動作的 AI 程式。