觀點 · 資訊分享
AWS Glue 6.0 上線費用降 3 成:Spark 升到 4.1,但舊工作換版本前要先看這份清單
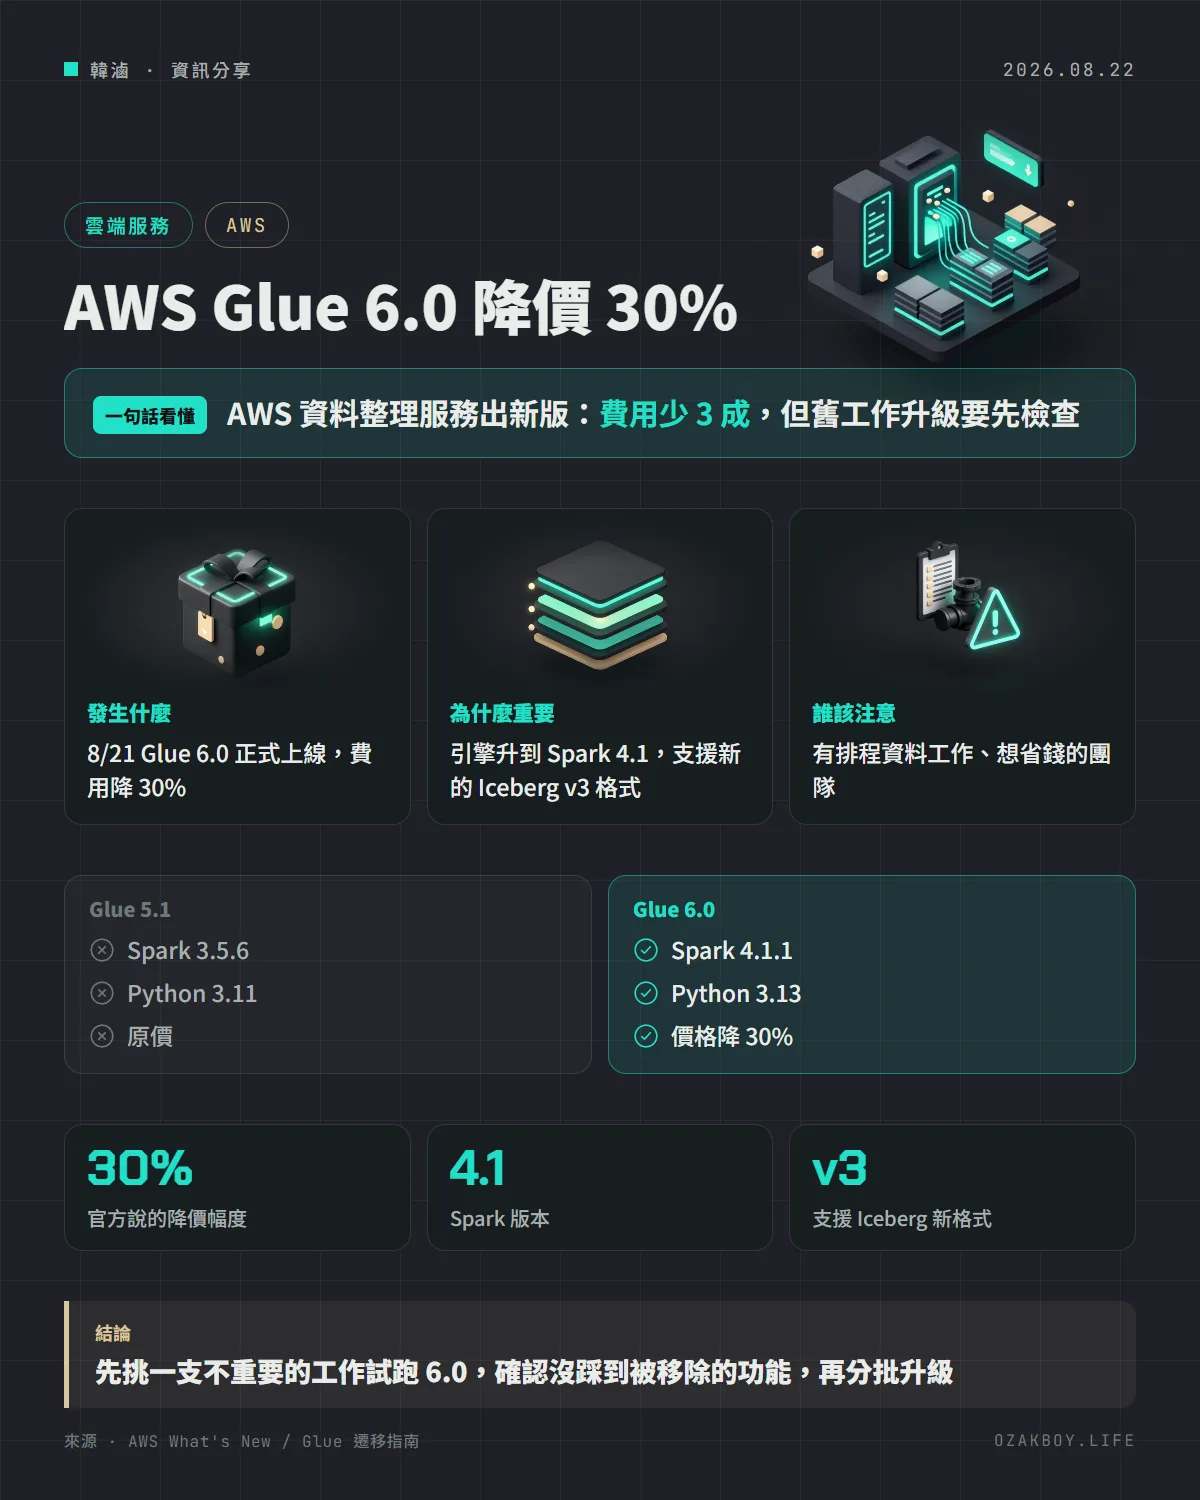
AWS 的資料整理服務 Glue 推出 6.0 版,官方說費用降低 30%,並支援 Iceberg v3、Spark 4.1 與 Python 3.13。不過 ANSI 模式預設開啟、EMRFS 被移除,舊工作直接換版本可能會報錯。
- 發布
- 2026-08-22
- 篇幅
- 約 5 分鐘 · 2,075 字
- 結構
- 8 節 + 4 題常見問題
- 標籤
一句話看懂:AWS 的資料處理服務 Glue 推出 6.0 版,同樣的工作費用少 30%,但引擎升級後規則比較嚴格,舊的工作不能無腦直接換版本。
先用白話講:Glue 是什麼?
想像公司每天都有一大堆亂七八糟的 Excel、紀錄檔、訂單資料,需要先整理成乾淨的表格,主管才能看報表。AWS Glue 就是 AWS 雇來專門做這件事的「資料整理工廠」:你寫好整理的規則,它幫你找機器、跑完就收工,按用到的時間計費。
工廠裡真正在幹活的引擎叫 Apache Spark。這次 Glue 6.0 的重點,就是把引擎從舊款換成新款,順便把價錢調低。
發生什麼事
AWS 在 8 月 21 日宣布 Glue 6.0 正式上線(GA),官方公告的重點有三個:
- 費用降低 30%
- 完整支援 Apache Iceberg v3(一種資料表格式),也更新了 Hudi 與 Delta Lake 這兩種同類格式
- 執行環境全面升級:Spark 4.1、Python 3.13、Scala 2.13
所有 AWS 商業區域、GovCloud(US)與中國區域都能用。
跟 5.1 版差在哪?
| 比較 | Glue 5.1 | Glue 6.0 |
|---|---|---|
| Spark | 3.5.6 | 4.1.1 |
| Python | 3.11 | 3.13 |
| Scala | 2.12.18 | 2.13.17 |
| 價格 | 原價 | 官方說降 30% |
新功能裡,開發者最有感的是三個:
- VARIANT 資料型別:把格式不固定的 JSON 類資料直接塞進一欄,還會自動拆開,讀取更快。
- Spark Declarative Pipelines:只描述「我要什麼結果」,不用再寫一大堆「先做 A 再做 B」的串接程式。
- 即時模式串流:處理即時資料的延遲可以降到亞秒等級。
升級前要小心的地方
官方遷移指南列了不少「換版本就會壞」的地方,這才是這篇最該看的部分:
- ANSI 模式預設開啟:以前數字溢位或轉型失敗會默默變成 NULL,現在會直接丟出錯誤。想維持舊行為要自己把
spark.sql.ansi.enabled設成false。 - EMRFS 被移除:讀寫 S3 一律走 S3A,舊的
fs.s3.consistent.*設定要拿掉。 - AWS SDK for Java v1 被移除:用
com.amazonaws.services.*的程式要改成 v2。 - Scala 2.12 的 JAR 不能用:自己編譯的套件要重編。
- Iceberg v3 不能回頭:表一旦升到 v3 就降不回 v2。而且文件寫明,Athena SQL 目前讀不了 v3 的表,會報「Cannot read unsupported version 3」。
給開發者的技術細節
升級方式有兩種:在 Glue 主控台或 SageMaker Unified Studio 建工作時,版本下拉選單選 6.0;或用官方的「Generative AI Upgrade Agent for Apache Spark」讓它幫你改舊工作的程式。
# 想暫時維持 5.1 以前「溢位變 NULL」的行為,可在工作裡加上這行
spark.conf.set("spark.sql.ansi.enabled", "false")
另外 6.0 的計費方式維持「按秒計費、最少 1 分鐘」。價格頁把 6.0 以上列成獨立一行,實際單價請以你所在區域的價格頁為準。這篇沒有引用具體單價,因為價格頁的數字是動態載入的,我沒辦法在原文裡逐一核對。
我的看法
「降 30%」很吸引人,但這種降價通常要你先換版本才拿得到。對有排程工作的團隊來說,真正的成本是測試時間,不是升級本身。
如果你手上有 Glue 工作,我會建議這樣做:先挑一支不重要、資料量小的工作換成 6.0 跑一次;重點檢查 ANSI 模式有沒有讓某些欄位突然報錯、自己寫的 JAR 能不能載入、Athena 有沒有讀不到新建的表。確認沒問題再分批換,別一次全換。
另外,Iceberg v3 看起來功能很多,但只要還有任何一個下游工具(例如 Athena)讀不了,就先別升表格式。降價是真的,但只要工作因為踩雷而重跑幾次,省下的錢很快就會被吃掉。
名詞小辭典
- ETL:把資料「取出、轉換、放進」另一個地方的過程,Glue 主要做這件事。
- Apache Spark:專門處理大量資料的運算引擎,可以把工作拆給很多台機器同時做。
- Apache Iceberg:一種管理大型資料表的格式,讓不同工具能一起安全地讀寫同一張表。
- DPU:Glue 計費的運算單位,用越多、跑越久就越貴。