觀點 · 資訊分享
OpenAI 自製推論晶片 Jalapeño 首度公布成績:每瓦處理量最多 1.9 倍、延遲少 3.6 倍,年底開始部署
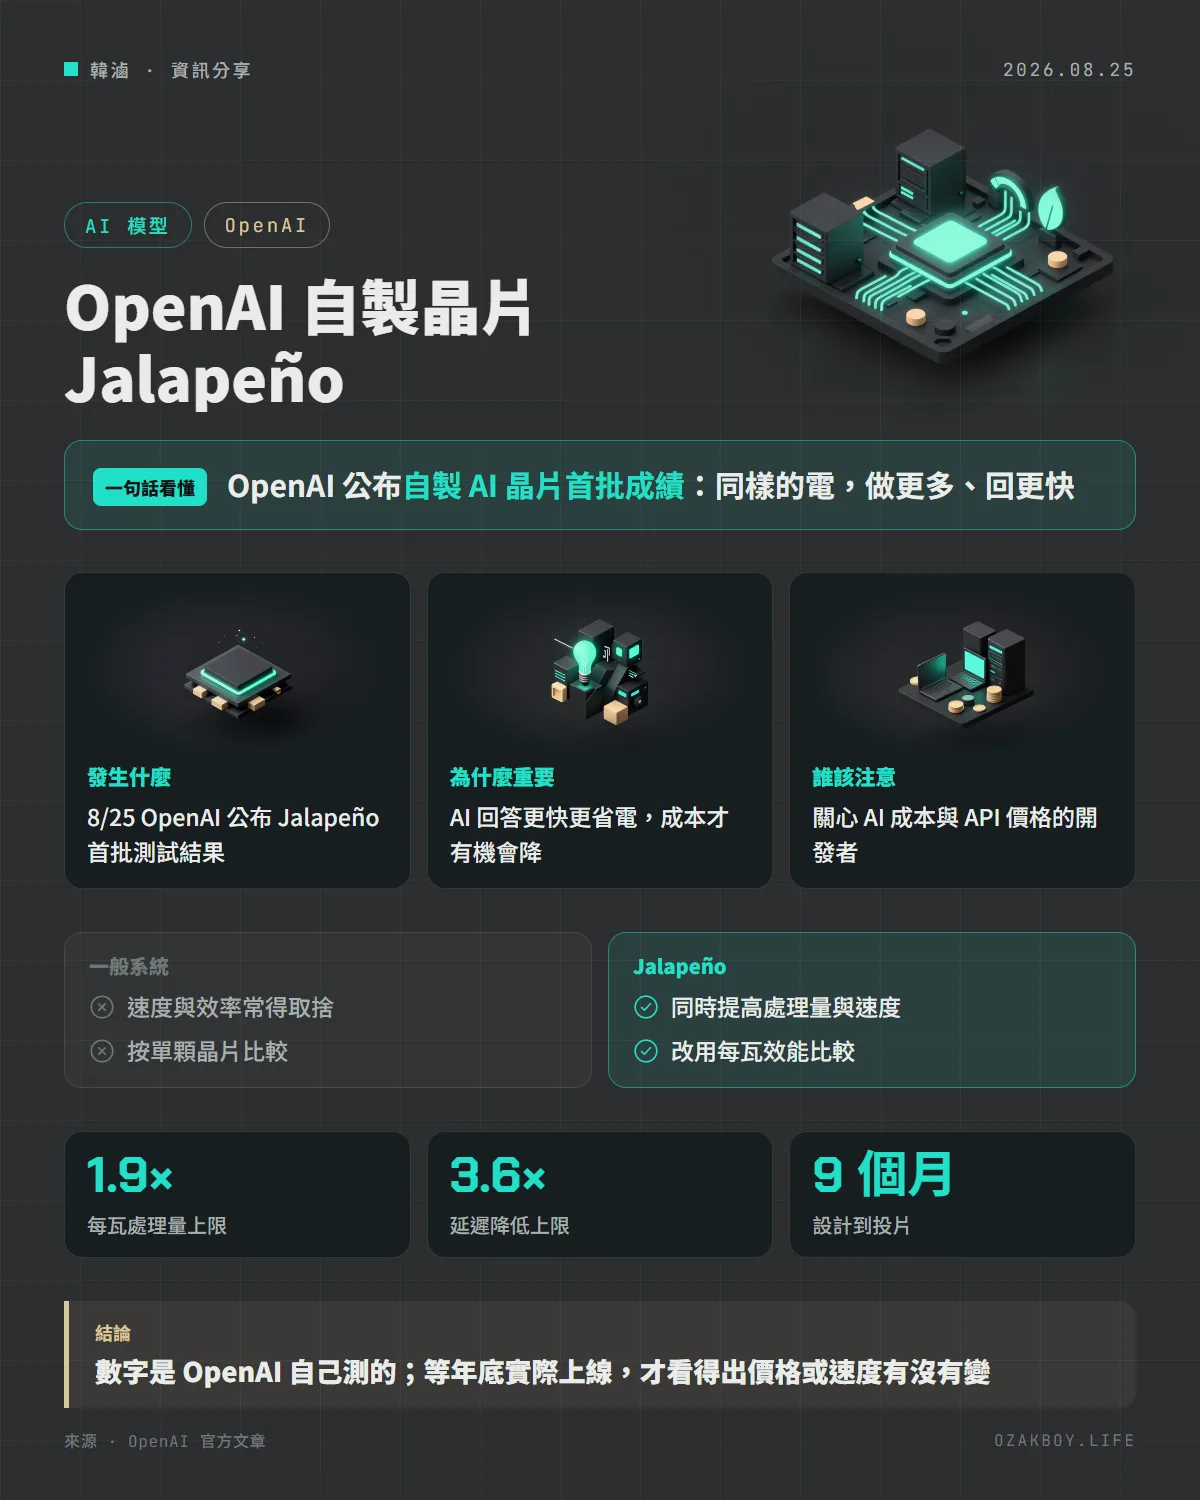
OpenAI 在 8 月 25 日公布自製 AI 推論晶片 Jalapeño 的首批測試結果。官方說在三個公開模型上,每瓦尖峰處理量高 1.5 到 1.9 倍,端到端延遲低 1.7 到 3.6 倍,數字為 OpenAI 自行測試。
- 發布
- 2026-08-25
- 篇幅
- 約 4 分鐘 · 1,860 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
一句話看懂:OpenAI 公布了自己設計的 AI 推論晶片 Jalapeño 的首批測試成績:同樣的用電量能做更多事、回應也更快;不過數字是 OpenAI 自己測的,年底才開始部署。
先用白話講:「推論」是什麼?
AI 的工作分兩階段。訓練像是廚師學做菜,花很久、很燒錢;推論像是客人點餐後,廚師實際把菜煮出來端上桌。我們每次在 ChatGPT 打字、呼叫 API,都是在做推論。
推論要用很多晶片和電,而且客人等越久體驗越差。所以大公司想辦法讓「煮菜」更快、更省電,OpenAI 的做法是自己設計一顆專門做推論的晶片,名字叫 Jalapeño。
發生什麼事
OpenAI 在 8 月 25 日發表文章,公布 Jalapeño(官方稱為首款自製推論晶片)開始測試後的第一批成果。官方的說法是:Jalapeño 在同一個架構下,同時提高處理量、降低延遲,而現有硬體系統常常得在兩者之間取捨。
他們用公開的測試平台 InferenceX(SemiAnalysis 提供)測了三個公開模型,包含 GPT-OSS 120B、DeepSeek R1 與 Kimi K2.5 1T,並與「市面上主流的商用 AI 系統」比較。官方整理的結果是:
- 每瓦處理量:高出 1.5 到 1.9 倍(尖峰處理量時)
- 端到端延遲:低 1.7 到 3.6 倍
三個模型各自的成績
以下是 OpenAI 附錄的數字,括號內是它列出的比較對象:
| 模型 | 每瓦尖峰處理量 | 端到端延遲 | 比較對象 |
|---|---|---|---|
| GPT-OSS 120B | 約 1.9 倍 | 1.03 秒對 1.80 秒 | GB200 |
| DeepSeek R1 670B | 約 1.7 倍 | 1.65 秒對 5.99 秒 | GB300 |
| Kimi K2.5 1T | 約 1.5 倍 | 1.56 秒對 5.31 秒 | GB300 |
另外官方也說,在內部測試中,OpenAI 自家的前沿模型上優勢更大,但沒有公開數字。
看數字要留意什麼?
- 是 OpenAI 自己測、自己挑比較對象:雖然用公開的測試平台,但結果與圖表是 OpenAI 整理的
- 用「每瓦」比:官方採用各晶片公布的額定功率來換算,Jalapeño 額定 700 瓦,比較對象分別是 1,200 瓦與 1,400 瓦。官方也說 Jalapeño 實測持續功耗在 550 瓦以下;用什麼單位比,會影響看起來差多少
- 還沒有大規模使用:官方說,計畫在今年底前開始部署到自家的運算基礎設施;他們也強調會繼續大量採購 NVIDIA 等夥伴的加速器
給開發者的技術細節
這篇文章有幾個技術上有趣的點:
- 設計思路是讓晶片、記憶體、網路、軟體與機櫃系統一起針對語言模型工作負載設計,目標是減少資料搬動;官方特別提到 prefill(讀完整個提示詞,吃算力)與 decode(一個字一個字產生回答,吃記憶體頻寬)瓶頸不同
- AI 參與設計:官方說 AI 協助團隊在 9 個月內從初步設計走到投片(tapeout);用 Codex 搭配 GPT-Astra,兩個月內讓 3 個原本不在計畫中的開放權重模型跑出高效能
- 針對 GPT-OSS 部分注意力與專家混合(MoE)區塊,AI 產生的實作比人類專家寫的快 1.5 到 1.8 倍,但官方註明這只適用於選定的區塊,不是整個模型
- 官方還說,每支新模型家族仍需要新的 kernel 與模型專屬的最佳化
我的看法
對我這種用 API 的人來說,最值得注意的不是「晶片多強」,而是它背後的訊息:AI 的成本與速度,很大一部分取決於硬體。如果推論更省電,OpenAI 才有空間把價格壓低或把更快的模式開放給更多人。官方文章也提到,期望 Jalapeño 能讓更快的服務模式,做到以前較慢模式才有的效率。
但我不會因此預期 API 下個月就變便宜。官方說年底前才開始部署,而且還要做量產驗證、擴大運作;成績也是廠商自己的測試。比較實際的做法是:先把你的應用在目前的模型與價格下算清楚成本,等晶片真的上線、價格或速度有實際變化再重新評估。
名詞小辭典
- 推論(Inference):AI 模型實際回答問題的過程,和訓練相對。
- 延遲(Latency):從你送出問題到收到完整回答所花的時間。
- 處理量(Throughput):同一段時間內能處理多少工作量。
- 投片(Tapeout):晶片設計定案、送去製造的關鍵步驟。