觀點 · 資訊分享
Claude Code 新增 plugin eval:幫自己寫的外掛出考題,每題跑 3 次,還能比有裝沒裝差多少
Claude Code 2.1.269 新增 claude plugin eval 指令,可以替外掛寫測試案例、自動評分,並和「沒裝外掛」的結果對照。改了外掛或換了模型之後,不用再靠感覺判斷有沒有變好或變壞。
- 發布
- 2026-09-12
- 篇幅
- 約 4 分鐘 · 1,899 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
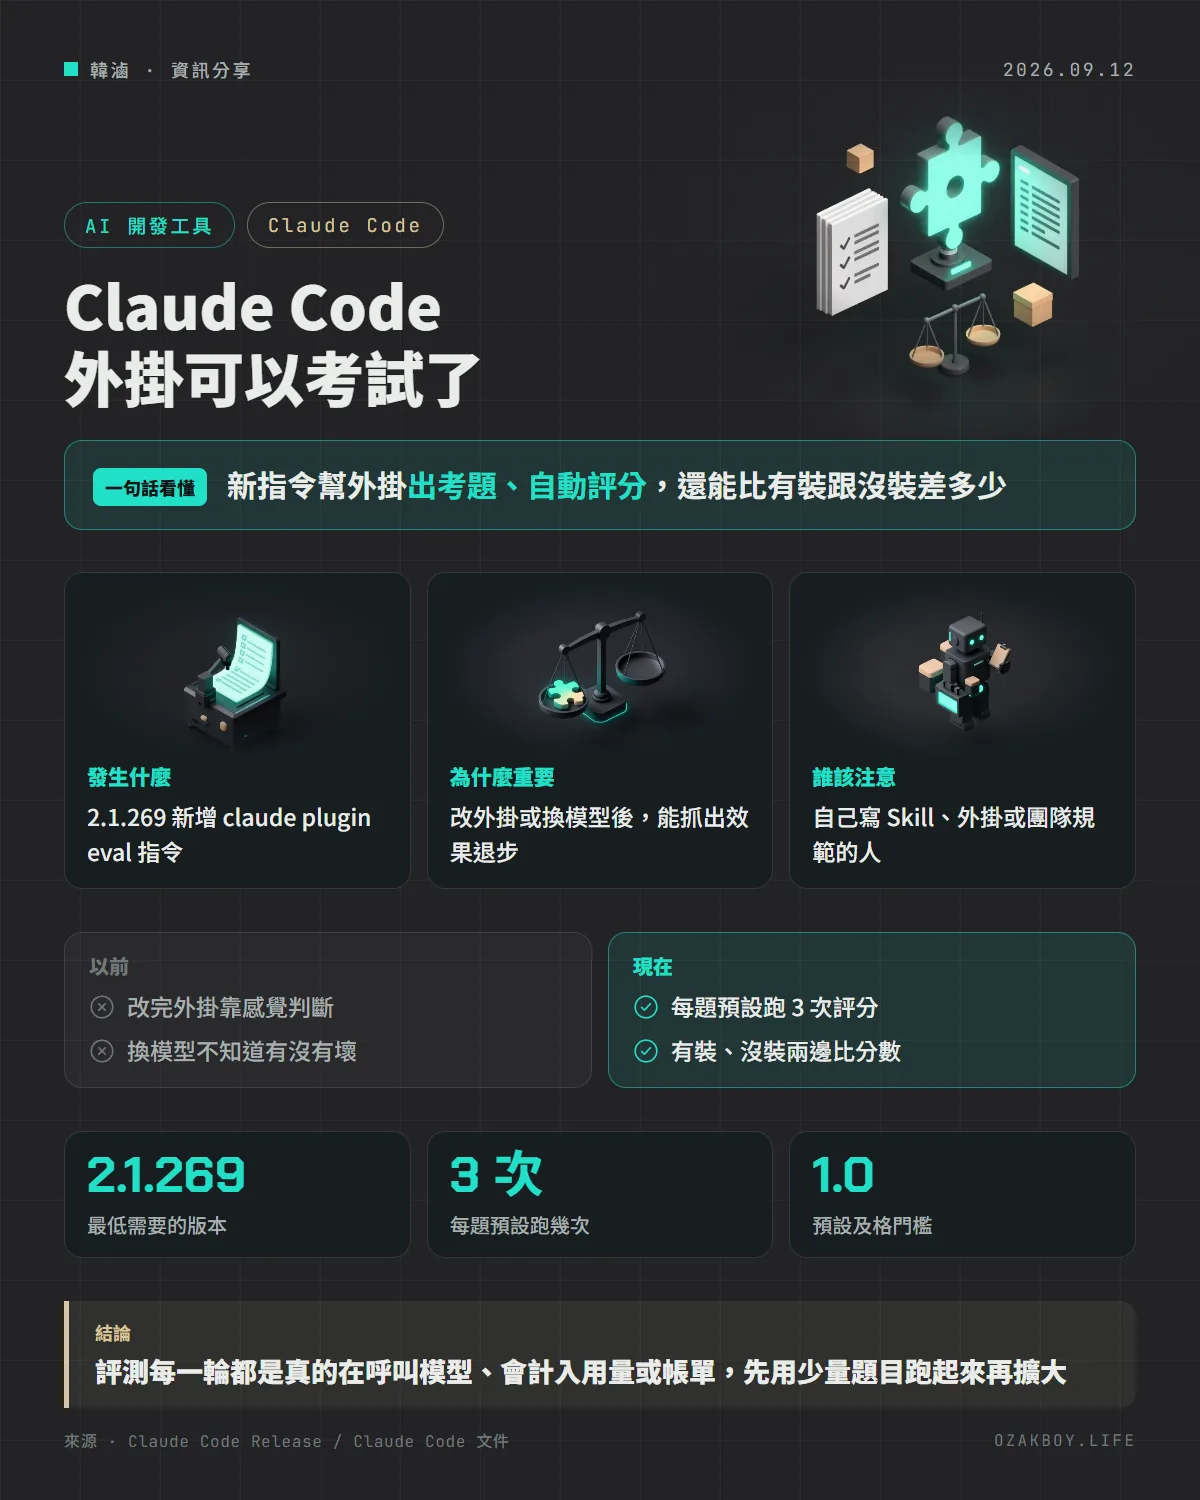
一句話看懂:Claude Code 新增
claude plugin eval指令,可以替自己寫的外掛出考題、自動評分,還能和「沒裝外掛」的結果比較,改了之後有沒有變好一目了然。
先用白話講:外掛為什麼需要「考試」?
外掛(plugin)和 Skill(技能),可以想成你寫給 AI 的「工作手冊」:遇到某類請求,照手冊的方式做事。問題是,手冊寫完之後,AI 到底有沒有照著做?改了一句話,結果是變好還是變差?以前多半只能自己試幾次、憑感覺判斷。
claude plugin eval 就是替這本手冊出「模擬考」:準備幾道題目、設定評分標準,自動考一輪,再告訴你幾分。
發生什麼事
Claude Code 在 2026 年 9 月 11 日(美國時間)發布 2.1.269 版,其中新增了 claude plugin eval:對外掛跑一組測試案例,並產出可重現的分數(JSON 與 HTML 報告)。同一版也新增了 /output-style 切換輸出風格、依專案標記 OpenTelemetry 指標等其他功能,這篇只談 eval。
一場考試怎麼跑?
- 一個案例 = 一道題:一段使用者會打的話,加上一個或多個評分器
- 每次都是乾淨環境:全新、隔離的非互動工作階段,只載入你的外掛
- 預設每題跑 3 次:AI 每次的表現會有差異,跑一次看不出什麼;分數是通過的評分器比例,3 次取平均
- 及格門檻預設 1.0:用
--threshold可以調整 - 自動做對照組:同樣的題目再跑一輪「沒裝外掛」的版本,得到
WITH(有裝)、W/OUT(沒裝)兩個分數,兩者的差距Δ就是外掛的貢獻。如果有沒有外掛都拿滿分,代表那題不是外掛的功勞
評分器共有 6 種:
| 類型 | 檢查什麼 | 要不要花錢 |
|---|---|---|
regex |
回覆或檔案內容是否符合某個樣式 | 不用 |
tool_used |
有沒有用到某個工具(例如某個 Skill) | 不用 |
tool_order |
工具使用的先後順序 | 不用 |
file_exists |
有沒有產生某個檔案 | 不用 |
llm |
請另一個模型依標準判斷好壞 | 要(多一次模型呼叫) |
baseline |
請模型判斷這次的表現是否不輸給一份參考紀錄 | 要(多一次模型呼叫) |
給開發者的技術細節
需要 Claude Code 2.1.269 以上;如果電腦有裝 git,版本要 2.31 以上。最快的上手方式:
# 在外掛根目錄,讓 Claude 讀你的外掛、提案題目並寫好檔案
claude plugin eval init

# 跑 evals/ 底下所有案例
claude plugin eval .

# 只調一個案例時,單輪、不跑對照組
claude plugin eval . --case <案例名稱> --runs 1 --ablation none
要放進 CI,官方範例會帶 --trust-plugin(避免卡在信任確認)、--json results.json、--threshold、指定模型,並用 --max-cost-usd 設花費上限。結束碼的意義:
| 結束碼 | 意思 |
|---|---|
| 0 | 每個案例都達到門檻 |
| 1 | 有案例低於門檻、案例檔載入失敗,或有執行因 API 錯誤中止 |
| 2 | 部分完成,例如碰到 --max-cost-usd 上限 |
要注意的地方:
- 每一輪都是真的呼叫模型,會計入方案用量或 API 帳單;一個案例預設就是 3 次有外掛加 3 次沒外掛,共 6 輪
- 預設不能用
Bash、Write、Edit等工具,要用--allow-tools另外授權;授權 Bash 時會在沙箱裡執行,原生 Windows 沒有沙箱後端,要改在 WSL2 跑 Δ只供參考,不會影響結束碼
我的看法
自己寫過 Skill 的人大概都有這種經驗:調了一下 description,覺得「應該比較好觸發了」,但沒有證據。plugin eval 的價值就在這裡:把「應該」變成分數,而且有沒有裝的對照組,能分辨到底是外掛的功勞,還是 Claude 本來就會。
不過它不是免費的午餐:每題至少 6 次模型呼叫,題目一多帳單會很快跟上來。我的做法會是先寫 3 到 5 題最重要的情境,用不花錢的評分器(regex、tool_used)當主力,llm 評分器只留給短輸出;換模型或大改外掛之前跑一次,當作安全網就好,不需要每次存檔都跑。
名詞小辭典
- Claude Code 外掛(plugin):把指令、技能(Skill)、設定打包在一起,讓 Claude Code 具備特定工作流程的擴充套件。
- 評測(eval):準備一批題目與評分標準,量化衡量 AI 做得好不好的方法。
- CI:持續整合,程式碼一有變動就自動跑檢查的流程。
- 沙箱(sandbox):把程式關在受限的環境裡執行,限制它能讀寫的檔案與網路,避免出事時影響整台電腦。