觀點 · 資訊分享
OpenAI 推出 GPT-6 Sol 與 Luna:Luna 每百萬 token 輸入只要 0.1 美元,大量分類摘要更便宜
OpenAI 在 GPT-6 家族補上兩款模型:Sol 負責日常寫程式與複雜工作,Luna 專做摘要、擷取、分類這類大量小任務。兩者都有約 105 萬 token 上下文,Luna 輸入價只要 Sol 的 1/20,AWS Bedrock 同步上架。
- 發布
- 2026-09-23
- 篇幅
- 約 4 分鐘 · 1,708 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
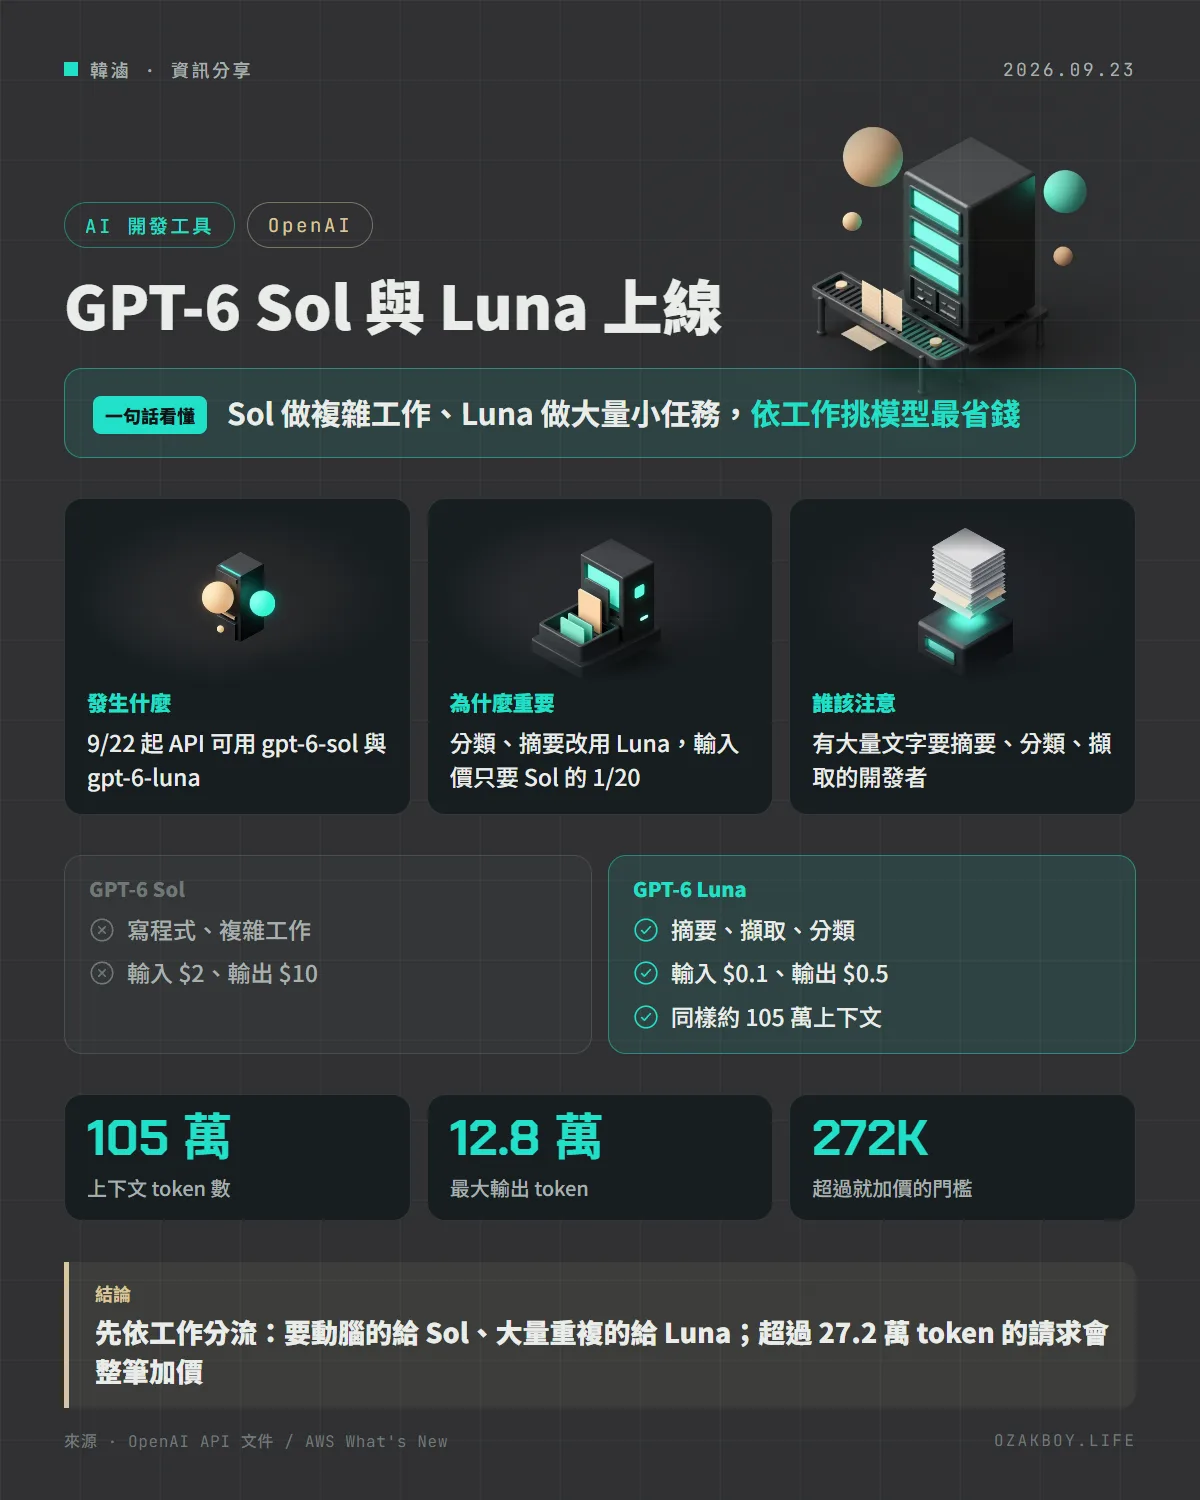
一句話看懂:OpenAI 推出 GPT-6 Sol 與 Luna 兩款模型,Sol 處理複雜工作、Luna 專做大量小任務,Luna 的輸入價只有 Sol 的 1/20。
先用白話講:為什麼要分兩款模型?
想像一間公司的客服部門。棘手的客訴要交給資深主管處理,他經驗豐富,但時薪高;每天幾千封「查詢訂單在哪」的信,交給工讀生按 SOP 回覆就好,又快又便宜。
把所有信都丟給主管,不但浪費錢,主管也忙不過來。AI 模型也是一樣:GPT-6 Sol 像資深主管,GPT-6 Luna 像訓練有素的工讀生。依工作性質分流,才是最省錢的用法。
發生什麼事
OpenAI 在 9 月 22 日推出 GPT-6 家族的兩款新模型,AWS 也在同一天宣布 Amazon Bedrock 上架:
- GPT-6 Sol(
gpt-6-sol):處理複雜寫程式與代理工作。AWS 公告引用 OpenAI 內部事實性評測,說它的錯誤大約是 GPT-5.6 Sol 的一半 - GPT-6 Luna(
gpt-6-luna):家族中最省的模型,適合摘要、擷取、分類、路由這類專注的大量任務 - 兩者都支援文字與圖片輸入、輸出文字,都能用 Responses API 與 Chat Completions
價格與規格
依 OpenAI API 文件(標準處理,每百萬 token、美元):
| 類別 | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| 輸入 | 2 | 0.1 |
| 快取輸入 | 0.2 | 0.01 |
| 快取寫入 | 2.5 | 0.125 |
| 輸出 | 10 | 0.5 |
| 上下文 | 1,050,000 | 1,050,000 |
| 最大輸出 | 128,000 | 128,000 |
| 知識截止 | 2026-04-20 | 2026-05-18 |
幾個計費細節:
- 快取輸入是一般輸入的 10%,快取寫入是 1.25 倍
- 單次請求輸入超過 272K token,整筆請求的輸入與快取價變 2 倍、輸出變 1.5 倍
- Batch 與 Flex 是標準價的一半;Fast 模式是 2 倍
- 部分地區處理另加 10%
給開發者的技術細節
reasoning.effort可設none、low、medium(預設)、high、xhigh、max- 內建工具與函式呼叫建議用 Responses API;Chat Completions 只有在
reasoning_effort設為none時才支援函式呼叫 - Responses API 支援的工具包括 web_search、file_search、code_interpreter、computer_use、mcp 等
用 Luna 做大量分類的簡單範例:
from openai import OpenAI

client = OpenAI()
resp = client.responses.create(
    model="gpt-6-luna",
    reasoning={"effort": "low"},
    input="把這則客服訊息分類成:訂單、退貨、帳號、其他。訊息:我的包裹三天都沒動",
)
print(resp.output_text)
我的看法
接案常遇到的 AI 需求,其實大部分不是「很難的推理」,而是「把一堆表單、留言、Email 分類整理」。這類工作如果一律用最強的模型,帳單會很難看。Luna 的定位剛好補上這塊,輸入每百萬 token 0.1 美元,拿來做 LINE 訊息分類、商品描述擷取都很合適。
要注意兩件事:一是 105 萬 token 的上下文看起來很大,但超過 272K 就整筆加價,長文件還是要先切段;二是換模型後,分類規則最好用幾十筆真實資料先測準確率,再決定能不能全面替換。
名詞小辭典
- 上下文(Context Window):模型一次能讀進的內容長度。
- 快取輸入(Cached Input):重複送出的相同內容,第二次之後用較低價格計費。
- Batch API:把大量請求一次送出、等一段時間再拿結果,價格比較便宜。
- 路由(Routing):先判斷一則請求屬於哪一類,再交給對應的流程或模型處理。
資料來源
常見問題
Sol 和 Luna 該選哪一個?
需要動腦的工作,例如寫程式、除錯、多步驟的代理流程,用 Sol。內容固定、量很大的工作,例如把客服訊息分類、從文件擷取欄位、做摘要,用 Luna 就好,輸入價只有 Sol 的 1/20(自行換算:0.1 ÷ 2)。
上下文 105 萬 token 可以放心塞滿嗎?
可以塞,但要注意價格。官方文件寫明,單次請求輸入超過 272K token,整筆請求的輸入與快取價格會變 2 倍、輸出變 1.5 倍。長文件最好先切段或先做檢索,不要每次都整份丟進去。
怎麼再省一點?
不急著要結果的工作可以用 Batch 或 Flex,官方價格是標準價的一半。固定的系統說明可以利用提示快取,快取輸入只收一般輸入的 10%,但寫入快取要付 1.25 倍。
接著讀
全部觀點 →OpenAI API 推出 12 小時提示快取:同一段話重複問 AI,用越多次越便宜OpenAI 讓 API 可以把重複使用的提示詞「記住」12 小時(原本只有 30 分鐘)。第一次要多付一點,但同一段內容用到第 3 次就開始省錢,用 12 次大約省下 7 成。閱讀 →OpenAI 新模型改寫 COBOL 正確率 97.9%:冷門老語言不再是 AI 的弱點OpenAI 公布兩項冷門程式語言測驗:GPT-6 Astra 在 20 種語言從零寫出 SQLite 相容引擎,平均通過率 87.4%;GPT-6.1 Sol 把 COBOL 程式搬到新語言,高推理強度下正確率 97.9%。測驗已在 GitHub 開源。閱讀 →OpenAI Agents API 沙盒可以先「熱機」:預熱免費,對話之間的閒置時間也不再收費OpenAI 讓 Agents API 的代管沙盒可以在使用者還在打字時就先準備好環境,等請求一來直接開工;預熱本身免費,沙盒運算也改成只在 AI 真正工作的回合計費。閱讀 →