觀點 · 資訊分享
OpenAI 開始替 AI 文字加隱形浮水印:歐盟 ChatGPT 先上,換掉 25% 用詞偵測率剩 17%
為了因應歐盟 AI 法案,OpenAI 推出文字浮水印技術 textGrain:歐盟的 ChatGPT 與 Codex 輸出將加入看不見的統計訊號,API 用戶可以自選開啟。但官方也坦白,文字一短、一改寫,偵測率就大幅下降。
- 發布
- 2026-10-05
- 篇幅
- 約 3 分鐘 · 1,472 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
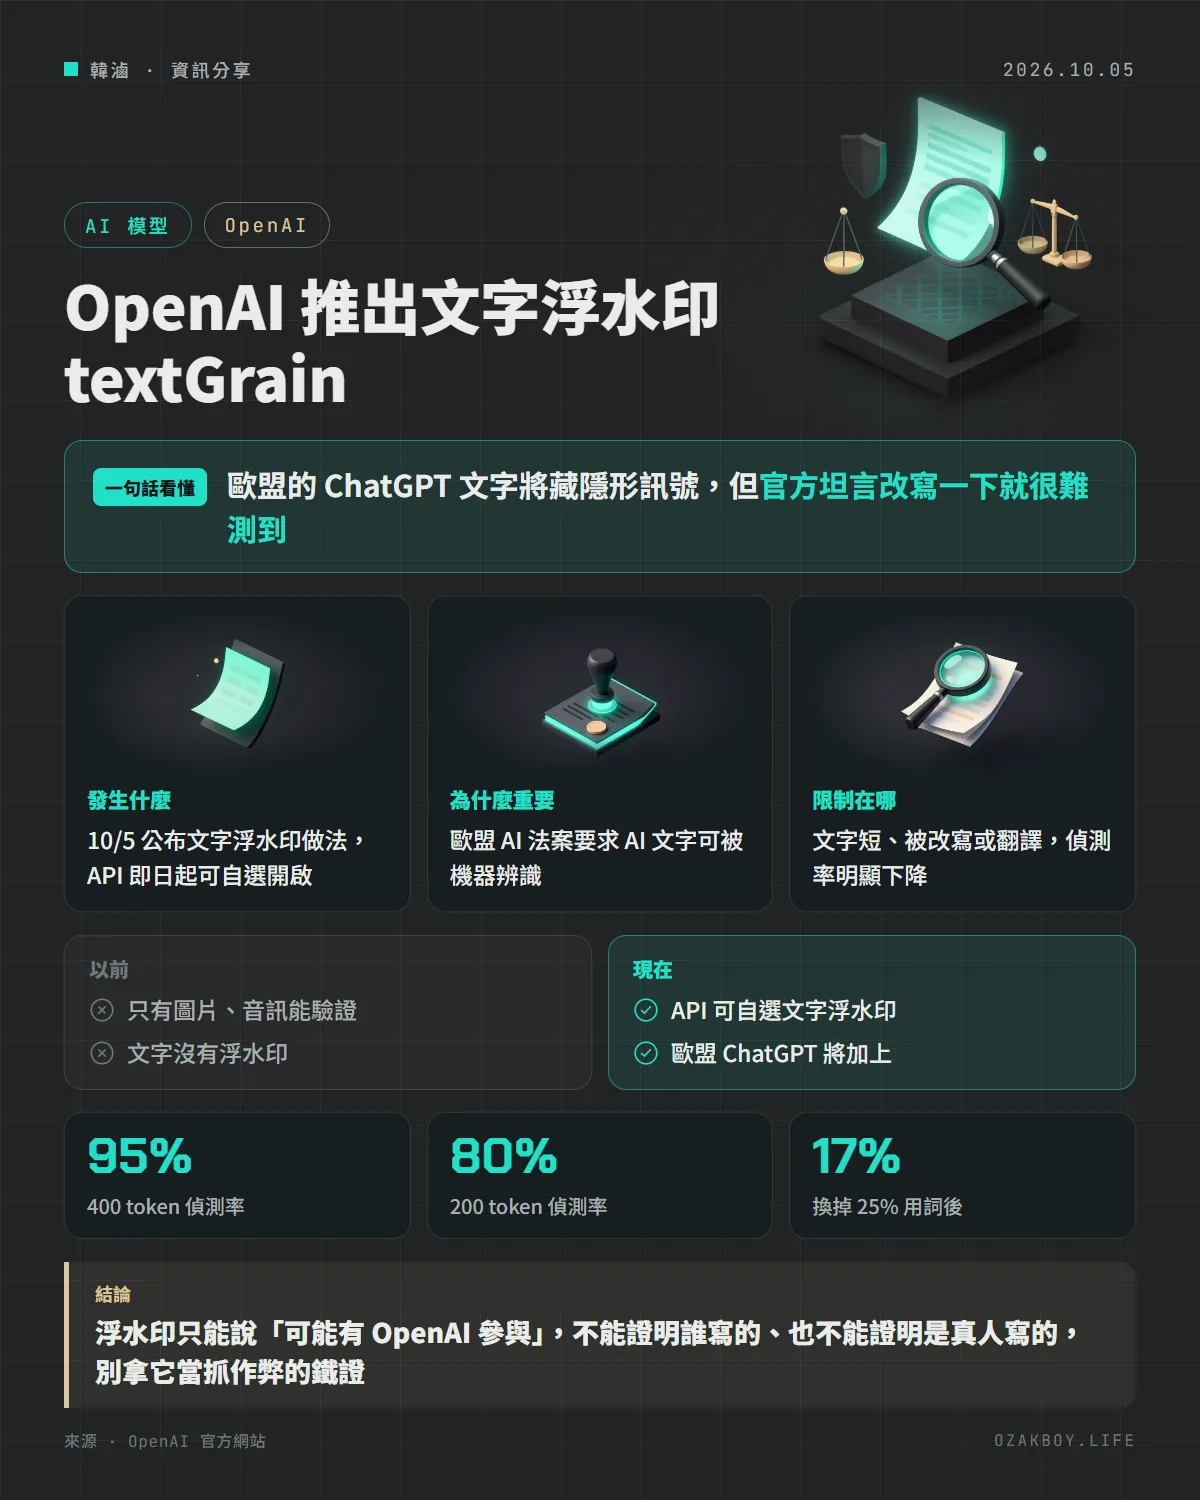
一句話看懂:為了符合歐盟 AI 法案,OpenAI 開始替 AI 產生的文字加上隱形浮水印,歐盟的 ChatGPT 先上;但官方也坦言,文字一短、一改寫,就很難測出來。
先用白話講:文字浮水印是什麼?
紙鈔上有浮水印,拿起來對著光才看得到,用來分辨真鈔。圖片的浮水印也類似,肉眼看不出來,但用工具一掃就知道是誰產生的。
文字的浮水印比較特別:文字沒辦法「藏圖案」,所以 OpenAI 的做法是在 AI 選字的時候動一點手腳。例如同樣意思可以用「開始」或「起初」,AI 會依照一套只有自己知道的規則偏好某些選擇。一兩個字看不出來,但一整段文字累積起來,偵測器就能從用字分布找出這個「隱形訊號」。
發生什麼事
OpenAI 在 10 月 5 日公布因應歐盟 AI 法案的文字浮水印做法。歐盟 AI 法案要求生成式 AI 業者,讓產生的文字可以被機器辨識:
- API:即日起,全球 API 用戶可以針對部分模型自選開啟文字浮水印,預設仍是關閉
- ChatGPT 與 Codex:未來幾週,只在歐盟替符合條件的文字輸出加入隱形浮水印,不會一開始就變成全球預設
- 偵測器:先只開放給通過審核的研究人員與專家機構申請,不對大眾公開
- 技術:名稱是 textGrain,官方表示之後會開源,並說在他們的測試中表現不輸包含 SynthID 在內的其他做法
偵測其實沒那麼準
OpenAI 自己公布的測試(目標誤判率 1%):
| 情境 | 偵測率 |
|---|---|
| 400 token 的心理學類文字 | 約 95% |
| 200 token 的心理學類文字 | 約 80% |
| 400 token,換掉 10% 用詞 | 從約 92% 降到 66% |
| 400 token,換掉 25% 用詞 | 降到 17% |
數學這類用字彈性小的內容,偵測率又更低。這也是官方決定先不公開偵測器的原因之一。
更多細節
OpenAI 特別列出浮水印不能告訴你的事:
- 不能衡量人投入了多少:只能說 OpenAI 的系統可能產生或處理過這段文字
- 不能決定著作權歸屬或責任
- 不能辨識是誰用的:不會連到帳號、提示詞或對話
- 不能證明內容正確
- 沒測到浮水印,不代表是真人寫的:可能太短、被編輯、被翻譯,或來自其他公司的模型
品質方面,官方比較了旗艦模型 Astra 加與不加浮水印的跑分,差異很小,例如 Artificial Analysis 智慧指數 49.57 對 49.76。
我的看法
這則新聞最值得記住的不是「AI 文字可以被偵測了」,而是 OpenAI 自己承認的那一句:浮水印是很有限的訊號。換掉四分之一的用詞,偵測率就剩 17%;台灣使用者常常會再翻譯、再潤飾,訊號只會更弱。
對做網站與系統的人來說,如果你的產品用 OpenAI API 產生內容、又有歐盟客戶,可以開始評估要不要開啟浮水印來符合當地規範。至於用「有沒有浮水印」來判斷學生作業、員工報告是不是 AI 寫的,現在既做不到,也不該這樣用。
名詞小辭典
- 歐盟 AI 法案(EU AI Act):歐盟規範人工智慧開發與使用的法律,其中要求 AI 產生的內容能被辨識。
- 浮水印(Watermark):藏在內容裡、肉眼不易察覺的標記,用來追溯來源。
- 誤判率(False Positive Rate):沒有浮水印卻被判定為有的比例。
- 內容溯源(Provenance):記錄內容從哪裡來、怎麼產生或被編輯過的資訊。