觀點 · 資訊分享
Cloudflare Workers AI 事故報告:GLM 5.3 有 155 次回應夾帶別人的對話,起因是一個沒對齊的設定
Cloudflare 公布 Workers AI 上的 GLM 5.3 模型曾在 8 月底到 9 月初之間,讓 155 次回應含有其他客戶的請求內容。原因是 KV 快取池比上下文長度小,加上推理引擎 SGLang 沒把塞不下的請求退回。官方同時給了自架推理引擎的人一份檢查清單。
- 發布
- 2026-10-26
- 篇幅
- 約 5 分鐘 · 2,201 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
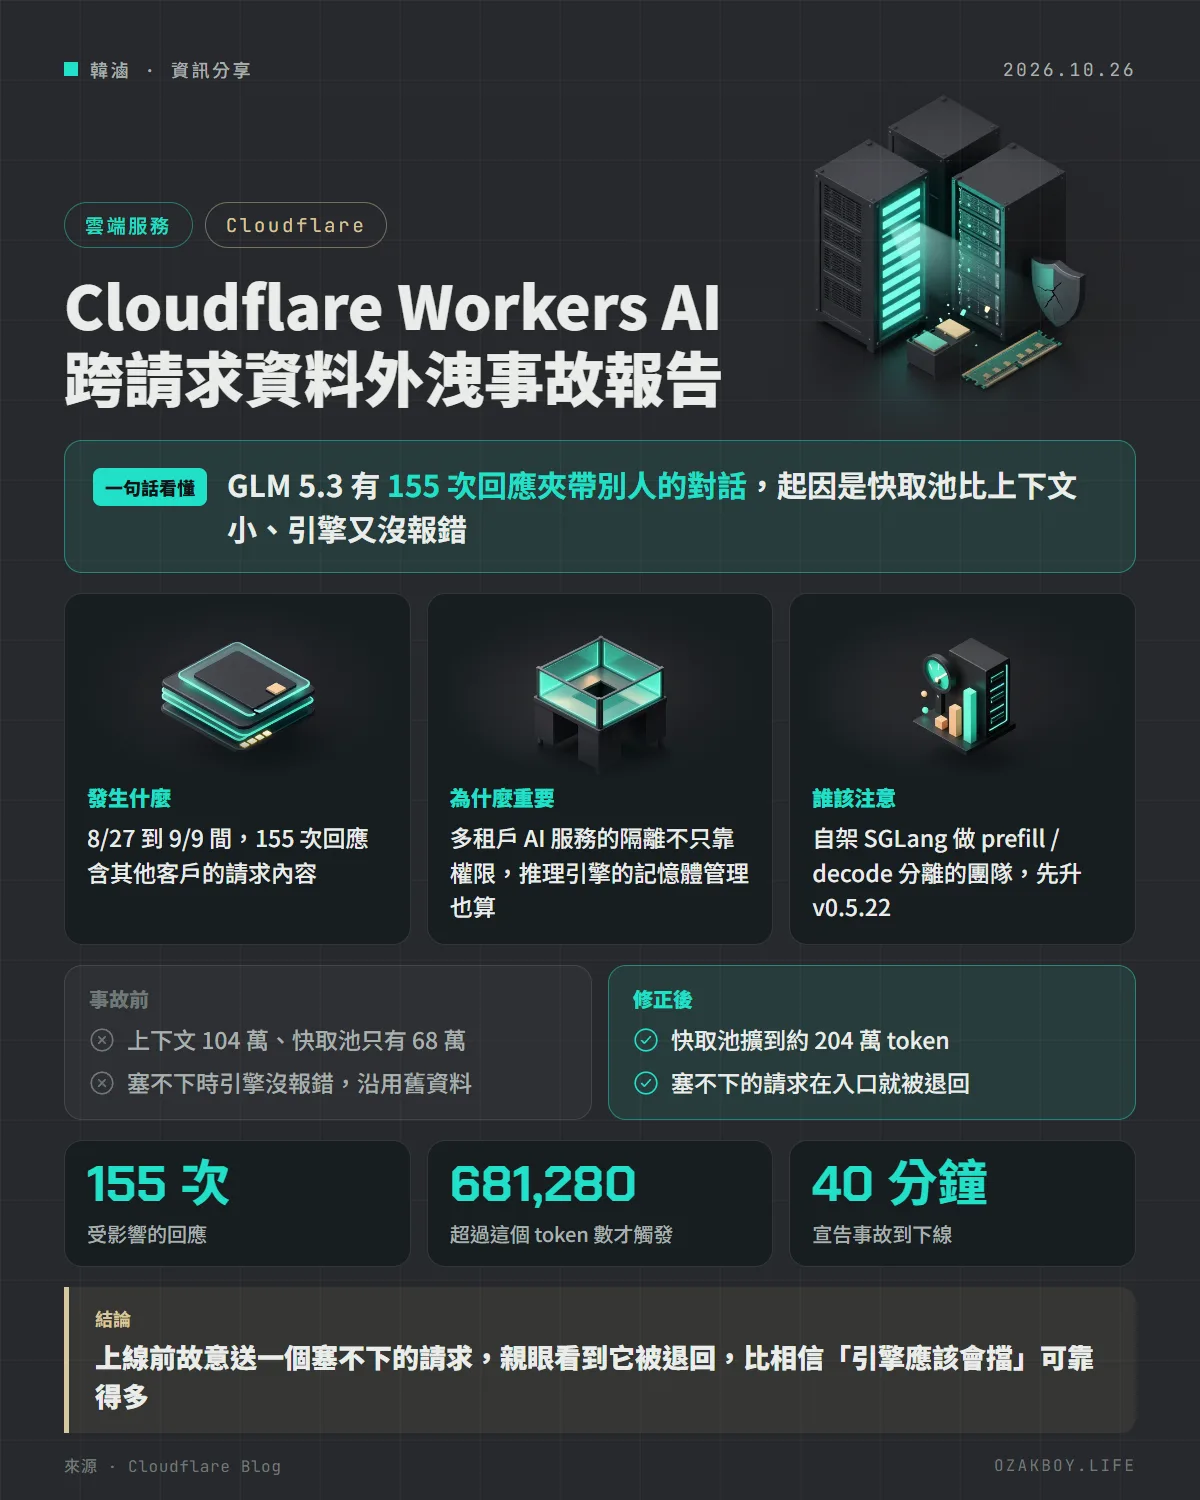
一句話看懂:Cloudflare 公布 Workers AI 上的 GLM 5.3 模型曾有 155 次回應夾帶其他客戶的對話內容,起因是「上下文長度」與「KV 快取池大小」沒對齊,加上推理引擎 SGLang 的一個 bug;已修復並與 SGLang 同步揭露。
先用白話講:KV 快取是什麼?
想像一間影印店,櫃台只有固定數量的托盤放客人的原稿。每位客人來,店員先把原稿放上托盤處理,印完就把托盤讓給下一位,但不會先把托盤清空,只是直接把新原稿蓋上去。平常沒問題,因為新原稿一定會蓋住舊的。
AI 模型在 GPU 記憶體裡的 KV 快取就是這些托盤:模型讀完你的提示詞後,會把中間結果暫存在固定大小的頁面裡,接著再產生回答。為了效能,這些頁面在請求之間一樣不會歸零,由推理引擎負責追蹤「哪一頁現在屬於誰」。
這次的事故,就是有一種情況下引擎追蹤錯了:新客人的原稿根本沒放上去,店員卻以為放好了,照著托盤上上一位客人的原稿印了出來。
發生什麼事
Cloudflare 在 10 月 26 日發布事故報告,重點如下:
- 影響範圍:2026 年 8 月 27 日 GLM 5.3 在 Workers AI 上線起,到 9 月 9 日修復為止,共 155 次回應含有其他客戶稍早送給同一模型的請求內容
- 觸發條件:只有提示詞超過 681,280 個 token 的請求會中獎;一般長度的請求不受影響
- 怎麼發現的:9 月 8 日資安研究員 Gadi Evron(Knostic)透過 HackerOne 回報,Cloudflare 隔天早上重現,宣告事故後 40 分鐘內把模型下線,當天晚上修好恢復
- 有沒有被惡意利用:官方排除自家與研究員的測試後,認為受影響的請求在時間與數量上都像一般的長文本使用,沒有發現刻意利用的證據
- Workers AI 上其他模型都沒有這個問題
兩個疊在一起的原因
| 問題 | 修法 | |
|---|---|---|
| 設定 | 模型上下文設成 1,048,576 token,但負責讀提示詞的 prefill GPU,KV 快取池只放得下 681,280 token。Cloudflare 上線前就知道這個落差,但以為塞不下的請求會被引擎直接退回 | 比照 GLM 5.2 的設定釋放 GPU 記憶體,快取池擴到約 204 萬 token,大約是上下文的兩倍 |
| 引擎 | SGLang 在 prefill / decode 分離模式下,塞不下的請求被內部標記為拒絕、換成一個 token 的佔位符,但沒有回錯誤給客戶端,反而照常把佔位符的快取送給 decode 節點;decode 以為整份快取都被覆寫,其實大部分還是上一個請求留下的 | Cloudflare 自己打補丁,讓帶有拒絕標記的請求在進入佇列前就以原本的錯誤退回,並把修法提交到上游 |
給開發者的技術細節
- 上游 SGLang 相關修正:#36988(9 月 6 日合併,原本是修另一個類似路徑)、#38935(提早拒絕超長請求)、#38704(Cloudflare 提案,decode 端核對收到的 token 數是否等於預留數)
- 修正已包含在 SGLang v0.5.21(10 月 2 日)與 v0.5.22(10 月 19 日),Cloudflare 建議所有自架 SGLang 的人升到 v0.5.22 以上
- 官方給自架 prefill / decode 分離模式的人四個建議:
- 從引擎啟動 log 量測每個節點的 KV 快取池大小,確認大於上下文長度;每次改量化、平行度、記憶體比例都要重量
- 不要靠前面的 proxy 擋長度,也不要假設引擎會自己拒絕塞不下的請求
- 開啟
--disaggregation-enable-kv-checksum與--kv-canary偵測快取被污染(目前還不是所有模型架構都支援) - 設定負載平衡器讓請求至少跑到第一個 token,避免觸發需要跨節點協調的中止
我的看法
這份報告最值得看的不是 bug 本身,而是 Cloudflare 坦白寫出「我們上線前就知道池子比上下文小,但以為引擎會報錯」。接案做系統時這種「應該會擋吧」的假設非常常見,而真正的防線應該是上線前故意送一個塞不下的請求,親眼看到它被退回。
對自架本地 AI 的人(包含我自己用 Ollama 和 ComfyUI 的場景)來說,單機單人用的話不會有跨租戶問題;但如果你用 SGLang 這類引擎開服務給多個使用者或客戶,這篇等於是一份免費的檢查清單,至少先把引擎版本升上去、把快取池大小和上下文長度對一遍。
名詞小辭典
- KV 快取(KV Cache):模型讀完提示詞後暫存在 GPU 記憶體裡的中間結果,讓後面每個字不用從頭重算。
- Prefill / Decode 分離:把「讀提示詞」和「逐字產生回答」拆到兩組 GPU 上跑,中間用高速網路把 KV 快取搬過去。
- SGLang:開源的大型語言模型推理引擎,Cloudflare Workers AI 用它來跑部分模型。
- 租戶隔離(Tenant Isolation):同一套服務同時服務很多客戶時,確保 A 客戶的資料不會出現在 B 客戶的回應裡。