觀點 · 資訊分享
Google TPU 首度進別家雲:Oracle OCI 2027 年起賣,第八代 12.6 PFLOPS、每瓦效能最高翻倍
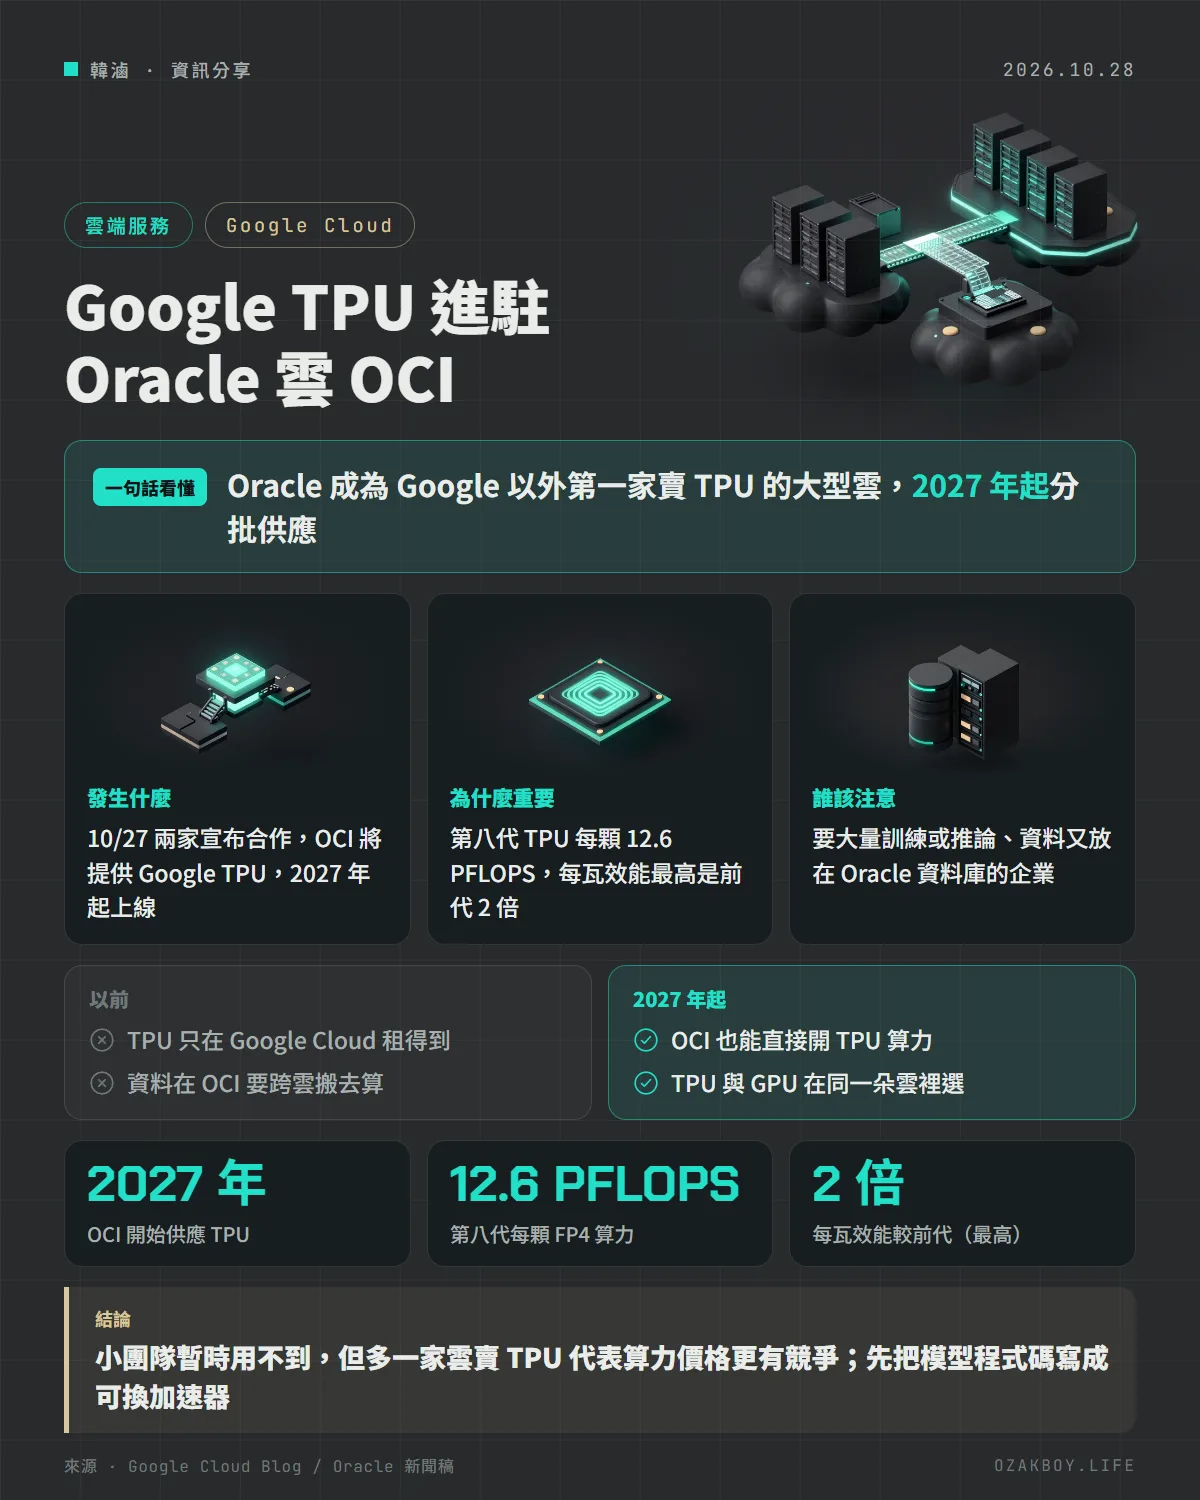
Oracle 與 Google 在 10 月 27 日宣布合作,Google TPU 將在 Oracle 雲 OCI 上提供,OCI 成為 Google 以外第一家賣 TPU 的大型雲,2027 年起分批上線。Google 同時公布第八代 TPU 數字:每顆 12.6 PFLOPS FP4 算力,每瓦效能最高是前代兩倍。
- 發布
- 2026-10-28
- 篇幅
- 約 5 分鐘 · 2,135 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
一句話看懂:Oracle 與 Google 宣布合作,Google 自家的 AI 晶片 TPU 將從 2027 年起在 Oracle Cloud Infrastructure(OCI)上提供,這是 TPU 第一次出現在 Google 以外的大型雲;Google 同時公布第八代 TPU 的數字:每顆 12.6 PFLOPS、每瓦效能最高是前代兩倍。
先用白話講:TPU 是什麼?為什麼「上別家雲」是新聞?
算 AI 模型需要特殊的晶片。大家最熟的是 NVIDIA 的 GPU,而 Google 十多年前開始自己設計一種專門算 AI 的晶片,叫 TPU。它一直是 Google 的「自家廚房」:訓練 Gemini、跑搜尋與 YouTube 的 AI 都靠它,外人只能透過 Google Cloud 租用。
這次的新聞是 Google 第一次把 TPU 放到別人的雲去賣。對客戶來說,以前「要用 TPU 就得搬去 Google Cloud」,之後多了一個選項:資料本來就在 Oracle 雲裡的企業,可以就地開 TPU 來算。
發生什麼事
- 10 月 27 日,Oracle 在拉斯維加斯的 Oracle AI World 發新聞稿;10 月 28 日 Google Cloud 部落格跟進說明
- OCI 將成為 Google 以外第一家提供 TPU 的大型雲(兩家都用了 hyperscaler 這個詞)
- 時程:2027 曆年開始供應,之後數年逐步擴充容量
- 分工:Oracle 負責電力、液冷與資料中心網路,用自家 Acceleron 網路把 TPU 叢集接到 Oracle 資料庫與儲存;Google 提供 TPU 系統與軟體生態
- 沒說的:價格、型號、哪些區域先有,兩篇都沒有公布
Google 這次公布的 TPU 數字
| 項目 | 數字 |
|---|---|
| 第八代 TPU 單晶片 FP4 算力 | 12.6 PFLOPS |
| 對比第一代 TPU(92 TFLOPS) | 超過 100 倍 |
| 每瓦效能(對比前代) | 最高 2 倍 |
| 訓練用 TPU 8t 每個 pod 效能(對比前代) | 接近 3 倍 |
| 大規模訓練的 goodput | 97% 以上 |
| 新互連拓樸的網路跳數 | 減少超過 50% |
| 低延遲推論的每美元效能 | 最高提升 80% |
第八代分成兩種:TPU 8t 給訓練,TPU 8i 給推論,後者是為「很多個專門代理反覆工作」的場景設計的。Google 也解釋為什麼不只看 FLOPS:訓練看的是 goodput(叢集真正在做有效運算的時間比例),推論看的是延遲與每個 token 的成本;它靠晶片上的互連與光路交換,在硬體出問題時即時繞路、不用重啟訓練任務。
給開發者的技術細節
- 軟體生態:Google 在 PyTorch Conference 宣布的 TorchTPU 已開源,vLLM、SGLang、llm-d、TorchTitan、Ray、TorchRec、Hugging Face、LiteRT 都能直接跑在 TPU 上,官方的賣點是「不改模型程式碼就能換加速器」
- 多架構選擇:OCI 上會同時有 GPU 與 TPU,可以依每個階段(訓練、微調、推論)選成本最合適的加速器
- 資料就近:Oracle 強調很多企業的系統紀錄本來就在 Oracle 資料庫,TPU 放在同一朵雲可以省掉跨雲傳輸費
- 現況:2027 年才開始,而且是分批;現在能做的是把訓練與推論程式寫在跨加速器的框架上
我的看法
我接的案子多半是中小企業網站與系統,AI 的部分用 API 或本機 Ollama 就夠,TPU 這種等級離我很遠。但這則新聞值得留意的地方是「算力市場的競爭」:以前想用 TPU 只有一家可選,現在多了 Oracle,長期來看對價格是好事,而且這種競爭最後會反映到我們平常用的 API 單價上。
另一個提醒是技術選型。Google 這次一直強調 vLLM、PyTorch 這些跨加速器的工具,意思很清楚:模型程式碼不要綁死某一家晶片。就算是小團隊自己微調小模型,用這些主流框架寫,哪天要搬去便宜的算力也不用重來。
名詞小辭典
- TPU(Tensor Processing Unit):Google 自行設計、專門算 AI 模型的晶片。
- hyperscaler(大型雲):規模最大的那幾家公有雲業者,例如 AWS、Azure、Google Cloud、OCI。
- PFLOPS:每秒千兆次浮點運算,算力單位;FP4 是精度較低但更省電的數字格式。
- goodput:叢集真正在做有效運算的時間比例,排除故障、等待與重啟的時間。