觀點 · 資訊分享
DynamoDB 新功能 bulk put items:S3 上的大量資料直接灌進線上資料表,1 億筆不到 1 小時
AWS 讓 DynamoDB 可以直接讀 S3 上的檔案、批次寫進正在服務的資料表,用的是獨立容量,不會拖慢 App。官方估計加速級寫 1 億筆 1 KB 資料不到 1 小時。
- 發布
- 2026-11-05
- 篇幅
- 約 4 分鐘 · 1,840 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
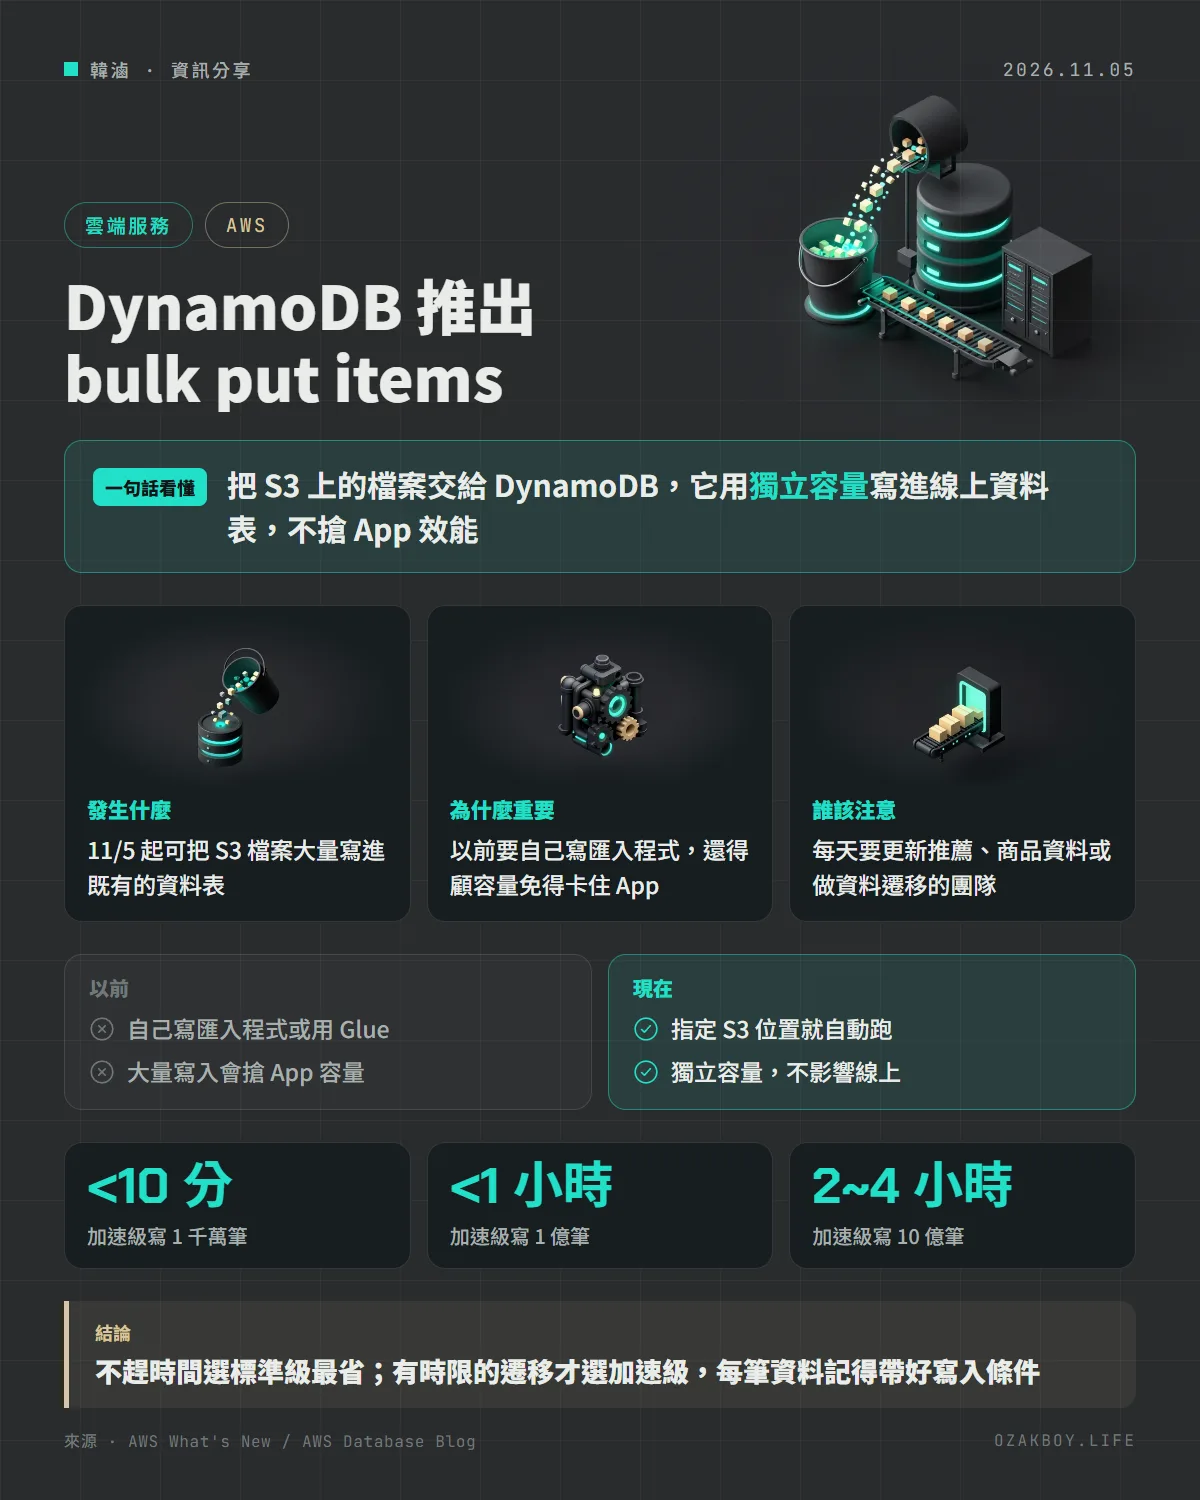
一句話看懂:AWS 讓 DynamoDB 可以直接讀 S3 上的檔案、在背景寫進正在服務的資料表,不必自己寫匯入程式,也不會拖慢 App。
先用白話講:bulk put items 是什麼?
想像一間 24 小時營業的便利商店,每天晚上都有一整車新貨要上架。以前店員得一邊結帳、一邊搬貨,客人一多,結帳就排長龍。
bulk put items 就像總公司另外派一組補貨人員,從後門把整車貨直接上架,櫃台照常結帳,完全不受影響。
這裡的「便利商店」是 DynamoDB(AWS 的雲端資料庫),「整車貨」是放在 Amazon S3(雲端檔案倉庫)上的大量資料。
發生什麼事
AWS 在 11 月 5 日宣布 DynamoDB 的 bulk put items 正式上線:
- 指定 S3 上的檔案位置,DynamoDB 會自己讀檔、檢查、寫進既有的資料表
- 寫入用的是獨立的系統容量,不跟 App 搶讀寫,也不算進 CloudWatch 的讀寫指標,原本的警報和自動擴充設定不用改
- 官方說價格比同樣數量的逐筆寫入低(公告沒有列出具體費率)
- 標準級在所有商用區域和 GovCloud 都能用;加速級只在部分區域提供
速度大概多快?
官方用 1 KB 大小的資料、加速級、資料表已經擴充好的條件估算:
| 寫入筆數 | 預估完成時間 |
|---|---|
| 1 千萬筆 | 10 分鐘以內 |
| 1 億筆 | 1 小時以內 |
| 10 億筆 | 2~4 小時 |
官方註明這只是起點參考,實際速度會依資料表與資料分布而不同。
給開發者的技術細節
輸入檔是一行一筆的 DynamoDB JSON 或 Amazon Ion,可以用 gzip 或 zstd 壓縮。用 AWS CLI 啟動的寫法大致如下:
aws dynamodb start-bulk-put-items \
  --table-name <資料表 ARN> \
  --input-s3-configuration '{"S3Bucket":"my-import-bucket","S3KeyPrefix":"daily/","InputFormat":"DYNAMODB_JSON"}' \
  --output-s3-configuration '{"S3Bucket":"my-report-bucket","S3KeyPrefix":"reports/","OutputType":["ERROR","CONDITION_CHECK_FAILURE"]}' \
  --performance-tier ACCELERATED
- 權限:要有帳號層級的
dynamodb:StartBulkOperation和資料表層級的dynamodb:BulkPutItems,加上讀輸入桶、寫報告桶的權限 - 每筆可帶條件:跟 PutItem 一樣的條件語法,例如
attribute_not_exists只新增不覆蓋,或比對版本號,只在新資料較新時寫入 - 四種結束狀態:COMPLETED、COMPLETED_WITH_ERRORS、FAILED、CANCELLED;寫不進去的資料會列在 S3 報告裡,含來源檔案與第幾筆
- 取消不會回復:已寫入的資料會留在表裡;作業紀錄保留 90 天,所有呼叫都會記進 CloudTrail
- 一開始要花幾分鐘準備;只有幾筆資料時,官方建議照用 PutItem 或 BatchWriteItem
- 匯入的資料一樣會出現在 DynamoDB Streams,下游消費者要預留處理量
我的看法
接案時常遇到一種需求:每天半夜從別的系統拿到一大包資料(價格表、庫存、推薦名單),要更新到正在線上服務的資料庫。以前最麻煩的不是寫程式,而是控制寫入速度,寫太快會把線上服務拖慢,寫太慢又跑不完。
這個功能把「控制速度」這件事交給 AWS 處理,對小團隊很省心。不過有兩點要先想好:第一,取消不會回復,所以匯入檔一定要帶寫入條件,讓重跑也安全;第二,公告沒有列出具體價格,大量使用前先在帳單試算一次,不要只看「比較便宜」就全面改用。
名詞小辭典
- DynamoDB:AWS 的雲端資料庫,速度快、不用自己管伺服器,常拿來存會員資料、購物車、商品目錄。
- Amazon S3:AWS 的雲端檔案倉庫,可以放任何大小的檔案。
- 容量(Capacity):資料庫每秒能處理多少讀寫,像收銀台的數量;被大量寫入佔滿時,App 就會變慢。
- 條件寫入(Condition Expression):寫入前先檢查一個條件,符合才寫,例如「這筆資料還不存在」。
資料來源
常見問題
bulk put items 跟以前的「從 S3 匯入」有什麼不同?
這次的重點是寫進「已經在服務中的資料表」。資料表照常接受 App 的讀寫,匯入在背景用獨立容量進行,不必先停機或另建一張新表。
標準級和加速級要怎麼選?
官方建議沒有截止時間就選標準級,比較省錢;遷移、災難復原這類有完成時限的工作才選加速級。加速級目前只在部分區域提供,使用前要查官方的區域清單。
匯入到一半發現資料有問題怎麼辦?
可以用 cancel-bulk-operation 停止,但已經寫進去的資料不會自動回復。所以建議每筆資料都帶寫入條件,讓同一份檔案重跑也不會蓋掉 App 期間寫入的新資料。
只有幾筆資料也適合用嗎?
不適合。每次作業一開始要花幾分鐘準備,官方也說幾筆資料、要在幾秒內寫完的情況,還是用 PutItem 或 BatchWriteItem。
接著讀
全部觀點 →AWS 公開 Prime Day 2026 數據:Lambda 一天被呼叫 2.3 兆次,資料庫每秒處理 1.92 億個請求AWS 每年都會公布撐起亞馬遜 Prime Day 購物節的後台數字。今年 Lambda 每天超過 2.3 兆次呼叫、DynamoDB 尖峰每秒 1.92 億個請求,故障演練次數更是去年的 6 倍以上。閱讀 →S3 Object Lock 新增「事件保留」:合約結束後才開始算 5 年,不必再猜一個遙遠的到期日Amazon S3 Object Lock 支援可變保留:先用事件鎖定保護檔案,等合約結束、稽核完成等事件發生,再放開鎖定,保留期才從那一刻起算。所有區域都能用,不另外收費。閱讀 →AWS Kinesis 資料流可以直接存進 S3 了:不用自己寫搬運程式,官方說最多省 6 成Amazon Kinesis Data Streams 新增資料送達功能,串流資料能直接存進一般 S3 儲存桶,或轉成 Iceberg 資料表。AWS 說跟自建搬運流程比,送達成本最多省 6 成。閱讀 →