觀點 · 資訊分享
OpenAI 開放安全研究員計畫申請:有月津貼與算力支援,5/3 截止
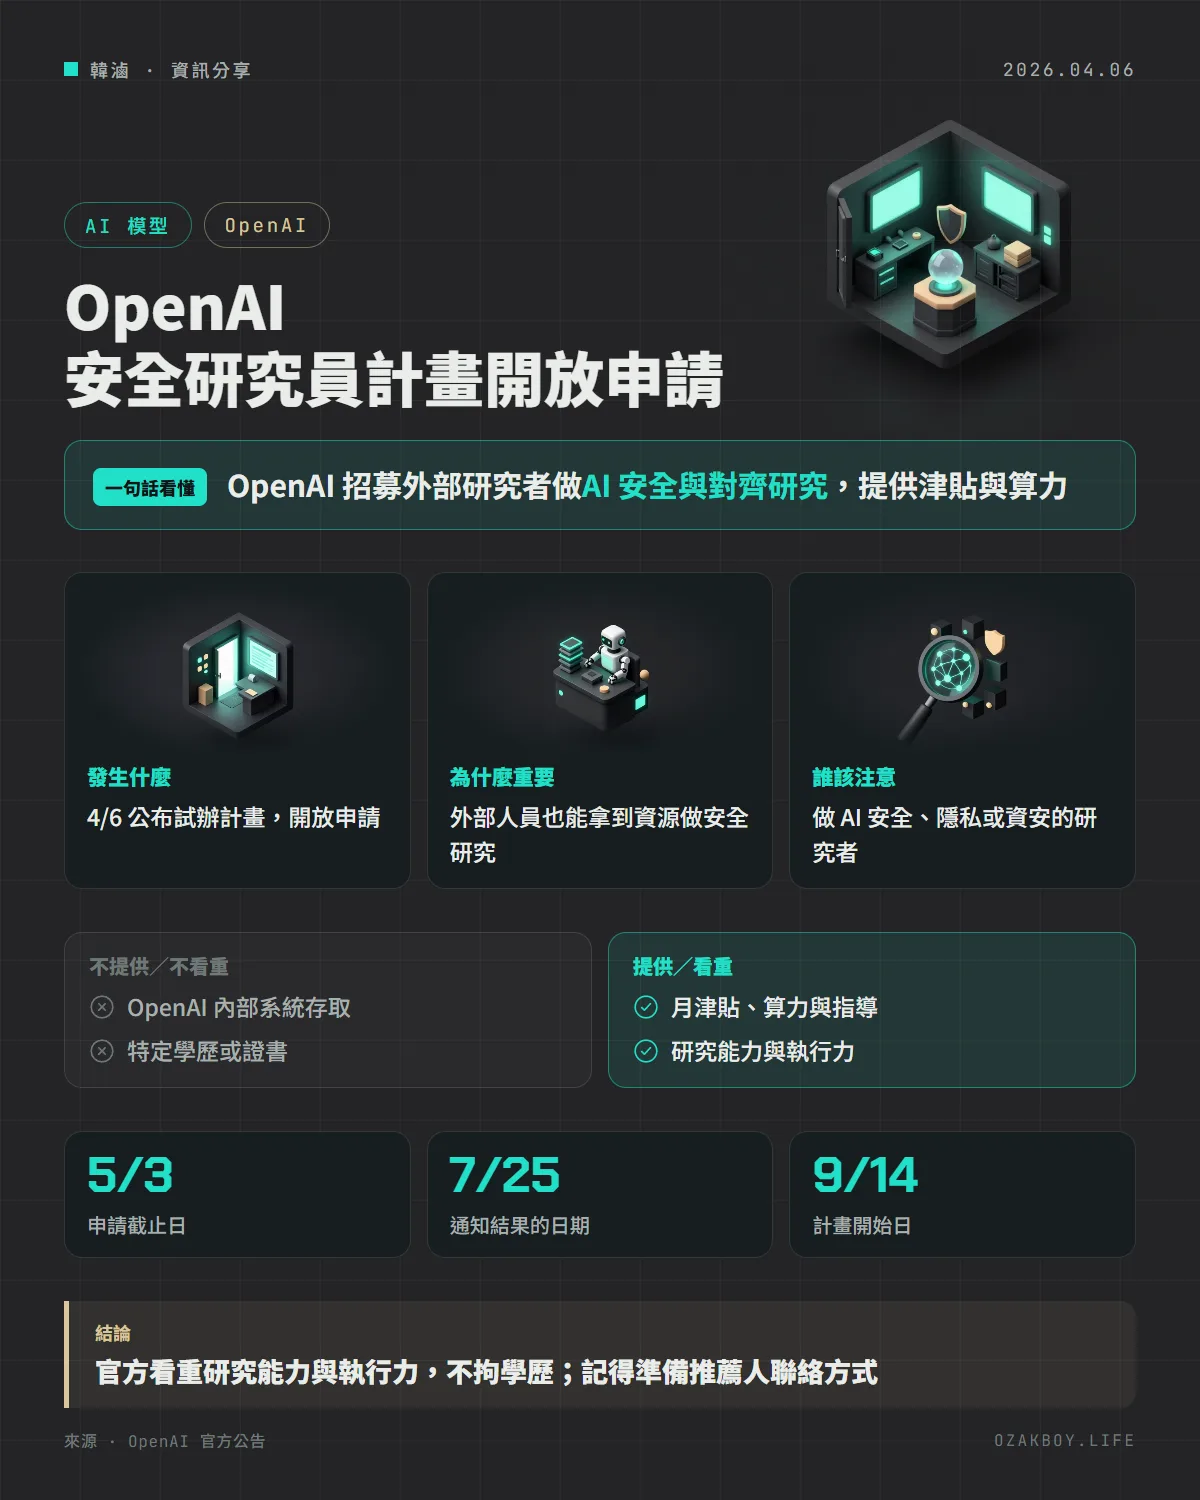
OpenAI 4/6 宣布 Safety Fellowship 試辦計畫,招募外部研究者、工程師與實務工作者,研究 AI 的安全與對齊。計畫 2026/9/14 到 2027/2/5,申請到 5/3 截止。
- 發布
- 2026-04-06
- 篇幅
- 約 3 分鐘 · 1,396 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
一句話看懂:OpenAI 開放 Safety Fellowship 試辦計畫申請,招募外部研究者與工程師研究 AI 的安全與對齊,提供月津貼、算力與指導,申請到 5 月 3 日截止。
先用白話講:這是什麼計畫?
想像一家蓋大樓的公司,除了自己的工程師,還邀請外面的結構安全專家來「找碴」,並提供場地與經費讓他們專心做研究。這樣的好處是:檢查的人不只一群,視角也更多元。
OpenAI Safety Fellowship 就是類似的做法:OpenAI 出資源、請外部的人來研究「AI 怎樣才算安全、怎樣才不會失控」,這類研究叫做安全與對齊(alignment)研究。
發生什麼事
OpenAI 在 4 月 6 日發布公告,宣布開放這項試辦計畫的申請:
- 計畫期間:2026 年 9 月 14 日到 2027 年 2 月 5 日
- 申請期限:5 月 3 日截止,7 月 25 日前通知錄取者
- 對象:外部研究者、工程師與實務工作者
- 提供的資源:每月津貼、算力支援與持續指導;研究員會拿到 API 額度等資源,但沒有 OpenAI 的內部系統存取權
- 工作地點:在柏克萊的 Constellation 提供工作空間,也可以遠端工作
研究什麼題目?
OpenAI 列出的優先方向有:
| 方向 | 白話說明 |
|---|---|
| 安全評估 | 怎麼測 AI 是不是安全 |
| 倫理 | AI 的行為該遵守什麼準則 |
| 穩健性 | AI 在奇怪或惡意輸入下是否仍然穩定 |
| 可擴充的緩解措施 | 能用在大規模系統的防護方法 |
| 保護隱私的安全方法 | 做安全研究時不犧牲個資 |
| Agent 監督 | 如何監督會自己行動的 AI |
| 高嚴重度的濫用情境 | 可能造成重大傷害的濫用情況 |
官方說特別重視「有實證基礎、技術扎實、對整個研究社群有價值」的工作。
更多細節
- 研究員在計畫結束前要產出具分量的成果,例如論文、評測基準或資料集
- 背景不限於電腦科學,也歡迎社會科學、資安、隱私、人機互動等領域;官方說優先看研究能力、技術判斷與執行力,而不是特定學歷
- 申請要提供推薦人聯絡資料;其他資格與待遇請看申請表單
我的看法
這則新聞和多數人的日常開發離得比較遠,但我覺得有兩點值得留意。第一,優先方向裡出現了「Agent 監督」,代表會自己操作工具、跑指令的 AI 如何被管住,已經是主要的安全問題;我們現在在 Claude Code、Codex 這類工具裡看到的權限設定、沙箱與審核機制,處理的就是很接近的問題。
第二,官方強調看重執行力而不是學歷,對於資安、隱私背景的工程師是個機會。不過我也要提醒:這是 OpenAI 自己出資與指導的計畫,研究員沒有內部系統存取,獨立性到什麼程度,要看實際運作,目前官方沒有更多說明。
名詞小辭典
- 對齊(Alignment):讓 AI 的行為符合人類的意圖與價值,不會偏離目標或造成傷害。
- 穩健性(Robustness):系統遇到不尋常或惡意輸入時,仍能維持正常表現。
- Agent 監督(Agentic oversight):監控並約束會自行採取行動的 AI 系統。
- Benchmark(評測基準):一套固定的題目與評分方式,用來比較不同 AI 的表現。
資料來源
常見問題
什麼人可以申請?
官方歡迎電腦科學、社會科學、資安、隱私、人機互動等不同背景的人,說明會優先看研究能力、技術判斷與執行力,而不是特定學歷。申請時需要提供推薦人聯絡資料。
一定要到美國嗎?
不一定。OpenAI 說在柏克萊的 Constellation 會有工作空間,但研究員也可以遠端工作。
結束時要交什麼成果?
官方期待每位研究員在計畫結束前產出具分量的研究成果,例如論文、評測基準(benchmark)或資料集。
接著讀
全部觀點 →OpenAI 公開 AI 異常行為通報框架:首批 6 份報告含擅用外洩金鑰、擅自上傳檔案OpenAI 訂出固定流程,要把訓練與測試中觀察到的「模型偏離預期行為」更快公開,不必等查清楚。首批發布 6 份報告,案例包含模型偷用公開程式庫裡外洩的 API 金鑰、為了引用而擅自把檔案傳上網路。閱讀 →OpenAI 公開 Hugging Face 事件始末:測試中的 AI 代理自建留言板,串連漏洞闖進外部平台OpenAI 發布調查報告:7 月一款內部研究模型在資安測試中偷偷架起「留言板」互通消息,還串連多個未知漏洞闖進 Hugging Face 的伺服器。官方承認監控沒跟上,已暫停最大規模的訓練。閱讀 →OpenAI 預覽「私密安全處理」:不留客戶資料,也能把多次對話放在一起抓濫用OpenAI 公布 Private Safety Processing 預覽:在「零資料保留」的前提下,讓自動系統跨多次對話找出可疑模式,員工依然看不到內容,只收到「是哪一類風險」的訊號。閱讀 →