觀點 · 資訊分享
OpenAI 發表 GPT-5.5:終端機任務準確率 82.7%,API 每百萬 token 輸入 5 美元、輸出 30 美元
OpenAI 推出 GPT-5.5,主打更會自己規劃、用工具、把多步驟任務做完。官方說它速度跟 GPT-5.4 相當、完成同樣任務用更少 token;ChatGPT 與 Codex 先上線,API 稍後跟進。
- 發布
- 2026-04-23
- 篇幅
- 約 3 分鐘 · 1,551 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
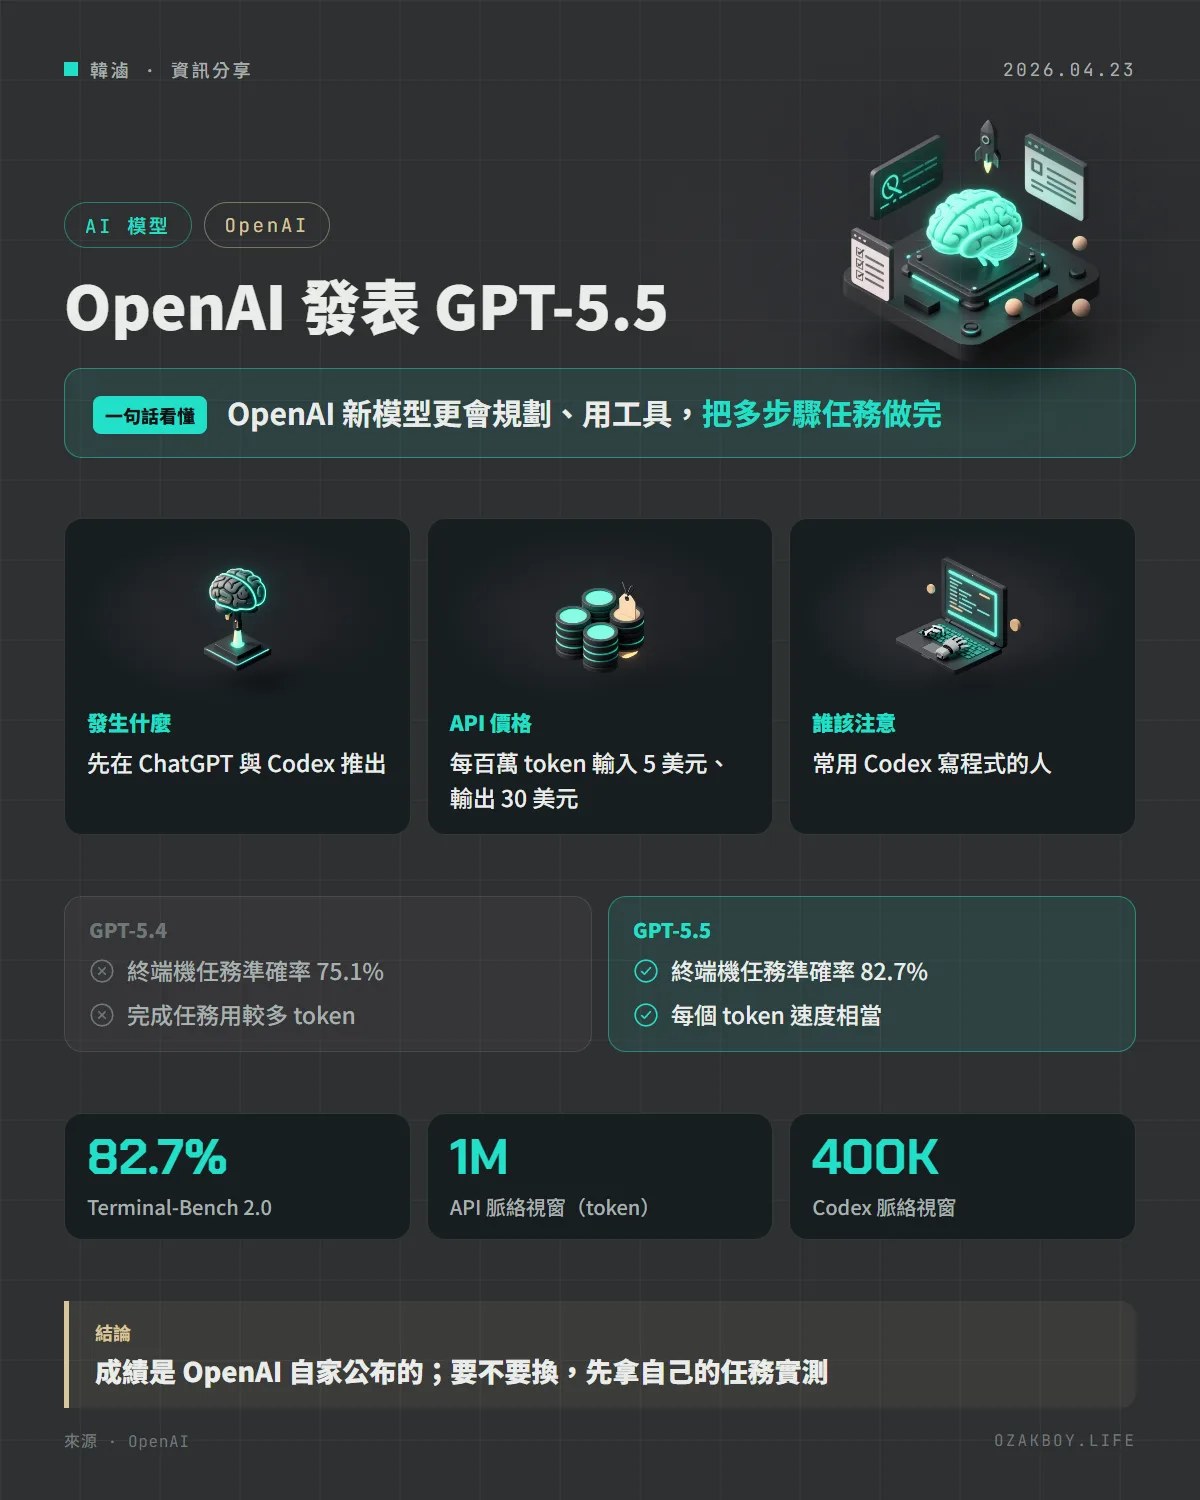
一句話看懂:OpenAI 發表 GPT-5.5,主打能自己規劃、用工具、把複雜任務做完;ChatGPT 與 Codex 先上線,API 稍後跟進。
先用白話講:這次的重點是什麼?
以前用 AI 像是帶實習生:每一步都要你交代清楚。OpenAI 說 GPT-5.5 想做的是讓你丟一個「亂七八糟、有好幾件事」的任務,它自己規劃、使用工具、檢查成果、遇到模糊的地方也能繼續往下做,不用你一步一步盯。
發生什麼事
OpenAI 在 2026 年 4 月 23 日發表 GPT-5.5:
- 擅長:寫程式與除錯、上網研究、分析資料、做文件與試算表、操作軟體
- 速度:官方說每個 token 的實際服務速度與 GPT-5.4 相當
- 效率:完成同樣的 Codex 任務,使用的 token 明顯更少
- 上線:ChatGPT 的 Plus、Pro、Business、Enterprise 用戶與 Codex 先開放;GPT-5.5 Pro 給 Pro、Business、Enterprise
官方也強調,GPT-5.5 是以他們目前「最嚴格的一套防護措施」發布:上線前做了完整的安全與風險評估,加入針對進階資安與生物能力的測試,並收集了近 200 位早期合作夥伴的真實使用回饋。也因為 API 需要不同的防護,所以 API 版本是稍晚才開放。
數字怎麼看
| 評測 | GPT-5.5 | GPT-5.4 |
|---|---|---|
| Terminal-Bench 2.0(命令列複雜流程) | 82.7% | 75.1% |
| SWE-Bench Pro(解 GitHub 真實問題) | 58.6% | 57.7% |
| OSWorld-Verified(操作電腦) | 78.7% | 75.0% |
要注意兩點:這些都是 OpenAI 自己公布的成績;而且官方在 SWE-Bench Pro 旁加註,有實驗室指出該評測可能有記憶化的證據。在同一張表裡,Claude Opus 4.7 在 SWE-Bench Pro 的成績(64.3%)還高於 GPT-5.5,所以「全面最強」並不成立。
給開發者的技術細節
- API 價格(預告):gpt-5.5 每百萬輸入 token 5 美元、輸出 30 美元,脈絡視窗 1M;Batch 與 Flex 為標準價的一半,Priority 處理是標準價的 2.5 倍
- gpt-5.5-pro:輸入 30 美元、輸出 180 美元
- Codex:脈絡視窗 400K;另有 Fast 模式,token 生成速度快 1.5 倍、價格是 2.5 倍
- 後續更新:官方在頁面加註,2026-04-24 起 GPT-5.5 與 GPT-5.5 Pro 已能在 API 使用
- 官方說價格比 GPT-5.4 高,但強調更聰明、更省 token,所以實際成本要看自己的任務實測
我的看法
接案常會碰到「AI 工具要不要換新模型」的問題。我的做法是:不看廣告上的最高分,拿自己手上最常做的 3、5 個真實任務各跑一次,比結果品質、花的 token 和重試次數。官方自己也說價格比前一代高,是否划算,只有實測才知道。
另外,一句「更省 token」不等於「更便宜」:單價變貴時,總花費還是可能上升。排程型、量大的工作,換之前先估算一輪。
如果你本來就在用 Codex 或 ChatGPT 付費方案,這次不需要多做什麼:官方說模型正在陸續開放給符合方案的用戶,等開放後就能試用;要整合進自己的產品,才需要看 API 的價格與限制。
名詞小辭典
- Token:AI 計算文字量的單位,API 依 token 數收費。
- 脈絡視窗(Context window):模型一次能「記得」的內容長度上限。
- Terminal-Bench:測試 AI 能不能完成命令列複雜流程的評測。
- Codex:OpenAI 的 AI 寫程式工具。