觀點 · 資訊分享
OpenAI 公開語音 AI 低延遲架構:在 WebRTC 前加一層只轉送封包的 relay,不用開上萬個 UDP 埠
OpenAI 工程部落格說明 ChatGPT 語音與 Realtime API 的 WebRTC 架構:用只轉送封包的 relay,加上負責連線狀態的 transceiver,讓媒體流量能在 Kubernetes 上跑,又不用對外開放大量 UDP 埠。
- 發布
- 2026-05-04
- 篇幅
- 約 4 分鐘 · 1,709 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
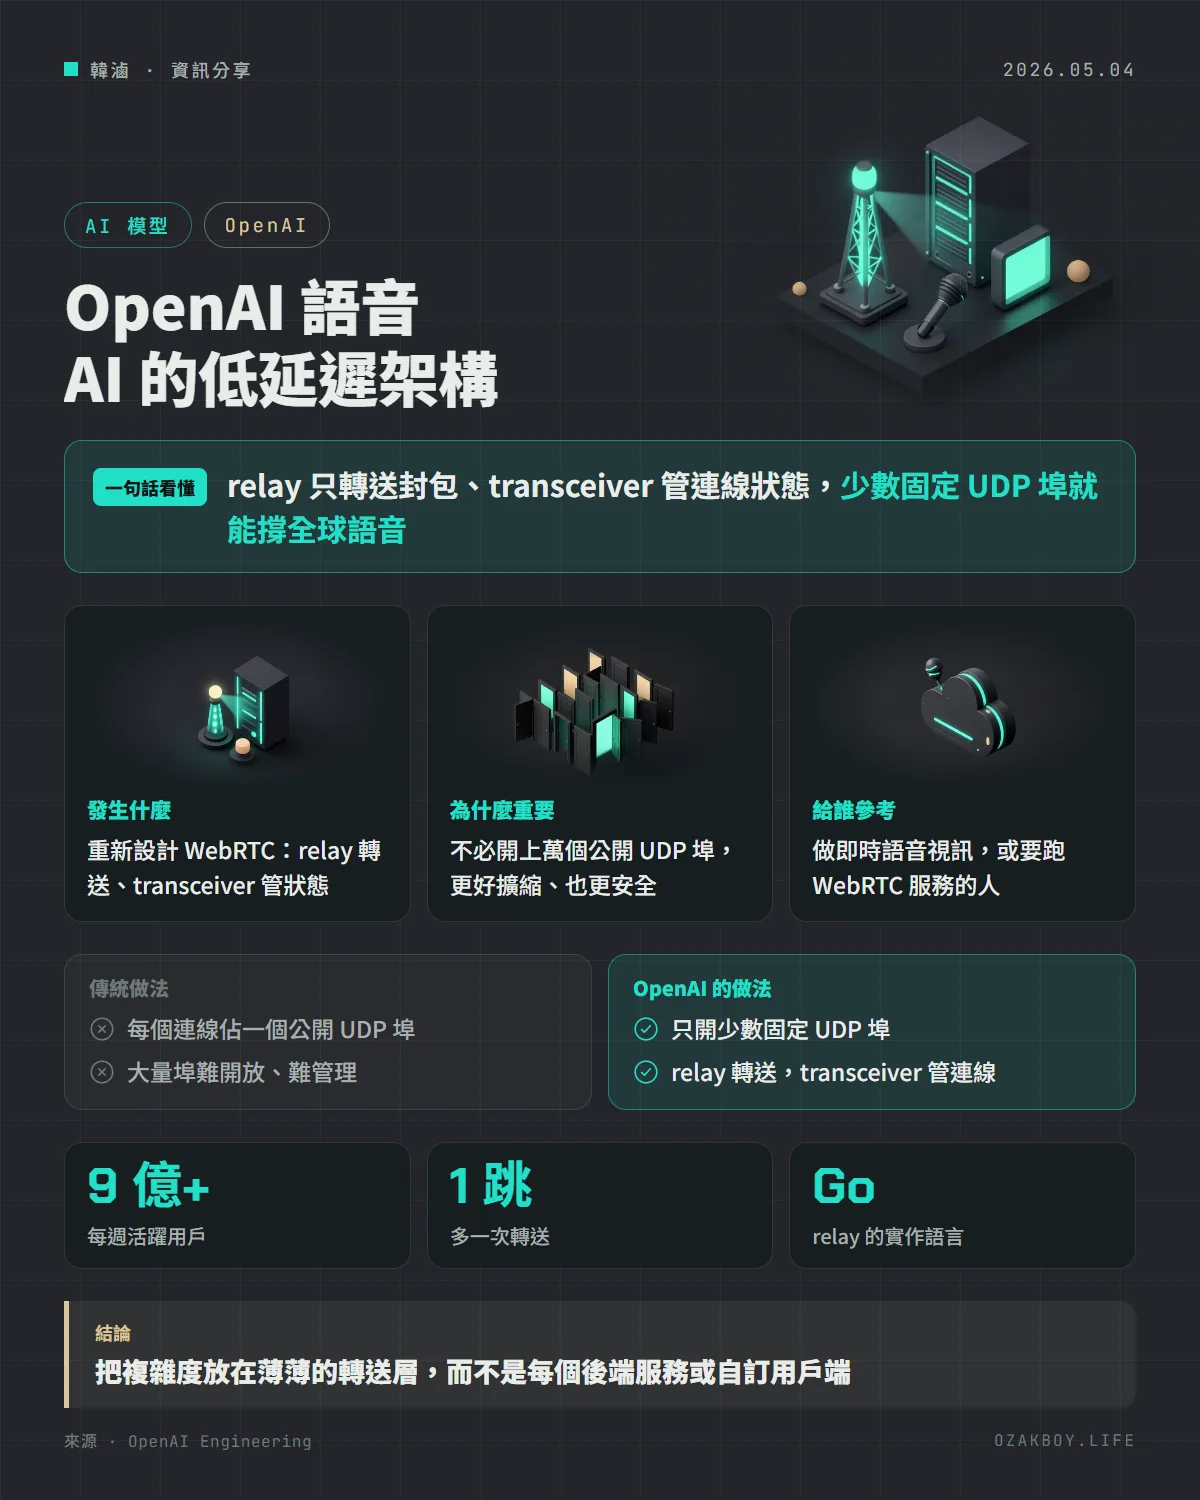
一句話看懂:OpenAI 為了讓語音 AI 聽起來像真人對話,把 WebRTC 拆成「只轉送封包的 relay」和「管連線狀態的 transceiver」,用少數固定的 UDP 埠撐起全球流量。
先用白話講:為什麼語音 AI 怕延遲?
你跟朋友講電話,如果每句話都慢半秒才傳到,就會一直搶話、冷場。語音 AI 也一樣:網路稍微卡一下,使用者就會聽到奇怪的停頓、被打斷的句子,或是插話後 AI 反應不過來。OpenAI 說,這件事對 ChatGPT 語音、使用 Realtime API 的開發者,以及需要邊聽邊處理的模型都很重要。
發生什麼事
5 月 4 日,OpenAI 發表工程文章,說明他們重新設計了 WebRTC 架構。WebRTC 是瀏覽器與 App 之間傳即時語音、影像的開放標準。官方列出他們要同時滿足三件事:
- 服務全球超過 9 億的每週活躍用戶
- 連線建立要快,一開始就能說話
- 媒體來回時間低且穩定,抖動與掉包少
他們遇到什麼問題?
| 問題 | 說明 |
|---|---|
| 埠號耗盡 | 傳統做法是每個連線用一個 UDP 埠,高併發時要對外開放龐大的埠範圍,負載平衡器、防火牆都難管理,也不適合自動擴縮 |
| 連線要有固定主人 | ICE 與 DTLS 都是有狀態的協定,同一連線的封包必須一直送到同一個處理程序,否則連線會失敗或斷線 |
| 全球路由 | 要讓使用者就近進入網路,縮短第一跳的延遲 |
他們怎麼解決?
OpenAI 把工作拆成兩層:
- Relay:輕量的 UDP 轉送層,只有少數對外位址。它不解密媒體、不跑 ICE 狀態機,只讀取封包中足夠的資訊來決定目的地,再轉送給負責的 transceiver
- Transceiver:真正的 WebRTC 端點,擁有 ICE、DTLS、SRTP 金鑰與連線生命週期
關鍵是 ICE 的 ufrag:連線設定時由伺服器產生,內含路由資訊。relay 只要解析第一個 STUN 封包,就知道要送去哪個叢集、哪個 transceiver。之後同一連線的 DTLS、RTP、RTCP 封包就依記憶體內的小型對應表轉送;若 relay 重啟,下一個 STUN 封包又能從 ufrag 重建對應。官方也提到另用 Redis 快取來更早復原路由。
給開發者的技術細節
- 實作:relay 用 Go 寫成,刻意保持精簡。用了
SO_REUSEPORT讓多個工作程序共用同一個 UDP 埠、runtime.LockOSThread把讀封包的 goroutine 釘在固定執行緒、預先配置緩衝區以減少記憶體配置;官方說沒有需要核心繞過(kernel bypass)技術 - 全球部署:Global Relay 是分布各地的 relay 入口;訊號交換(signaling)用 Cloudflare 的地理與就近導向,把請求送到附近的 transceiver 叢集
- 取捨:多了一次轉送,且 relay 與 transceiver 需要自訂協調;官方認為對他們的一對一工作負載值得
我的看法
我自己沒有做過這種規模的即時語音,但這篇有兩個觀念很值得學:一是「把複雜的狀態集中在一個地方,其他服務只做單純轉送」,二是「路由資訊塞在協定本來就有的欄位裡,省下額外的查詢服務」。
對做中小型專案的人來說,真正會碰到的多半是更簡單的情境,例如用現成的 Realtime API 或 LiveKit 之類的服務,不太需要自己架 relay。但如果你要在 Kubernetes 上跑 WebRTC,這篇可以幫你避開「開一大段 UDP 埠」這個常見的坑。
名詞小辭典
- WebRTC:瀏覽器與 App 傳送即時語音、影像的開放標準。
- UDP 埠(Port):網路連線的「門牌號碼」,UDP 是常用於即時傳輸的協定。
- ICE / STUN:幫雙方找到彼此並確認能連通的機制。
- Kubernetes:自動管理大量伺服器與服務的系統,服務會常常被新增、移除或搬家。