觀點 · 資訊分享
OpenAI 更新生命科學模型 GPT-Rosalind:官方測試中基因分析比 GPT-5.5 少用 31% Token
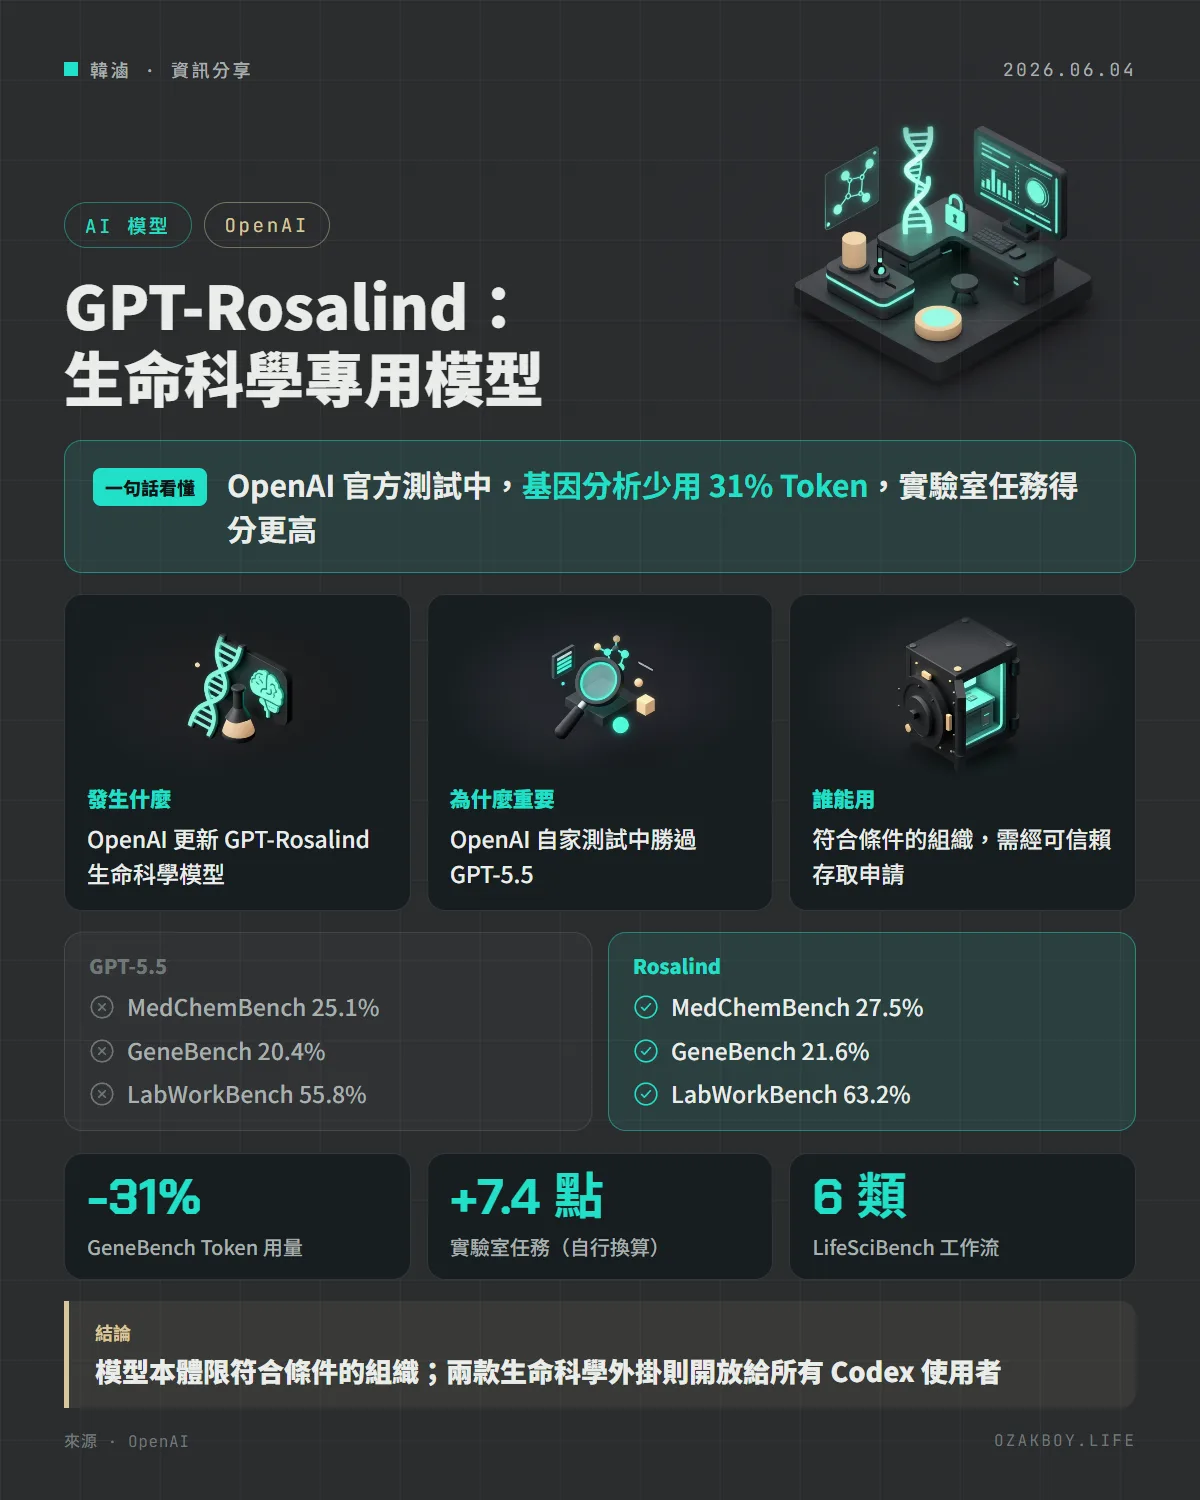
OpenAI 公布 GPT-Rosalind 系列的新模型更新,專攻藥物化學、基因組學等生命科學研究。官方測試中,它在三項評測的得分都高於 GPT-5.5;模型限符合條件的組織透過「可信賴存取」使用,另有兩款外掛開放給所有 Codex 使用者。
- 發布
- 2026-06-04
- 篇幅
- 約 5 分鐘 · 2,258 字
- 結構
- 8 節 + 4 題常見問題
- 標籤
一句話看懂:OpenAI 更新了生命科學專用的 GPT-Rosalind,官方測試中三項評測得分都高於 GPT-5.5,基因分析還少用 31% 的 Token;但模型本體只開放給符合條件的組織。
先用白話講:GPT-Rosalind 是什麼?
你可以把一般的 AI 模型想成「什麼都能聊的全科助理」,而 GPT-Rosalind 是 OpenAI 為生命科學研究(藥物研發、基因分析、濕式實驗室工作)訓練的「專科助理」。它要處理的是分子、基因、蛋白質這類很專業的資料,還要能在實驗做不出來時,幫忙推敲可能出錯的地方。
發生什麼事
OpenAI 在 2026 年 6 月 3 日發表 GPT-Rosalind 系列的新模型更新。官方說明,它結合 GPT-5.5 的代理式寫程式與工具使用能力,並在藥物化學、基因組學等核心領域加強模型本身的能力。
- 為企業規模打造:針對生命科學研究的企業使用情境。
- 限定使用對象:透過「可信賴存取」(trusted-access)提供給符合條件的組織。
- 合作案例:官方提到 Novo Nordisk 用它協助研究人員分析複雜資料、更快驗證假設。
官方測試成績:比 GPT-5.5 強在哪?
OpenAI 為這次更新設計了一組評測。其中 LifeSciBench 由外部專家評分,題目取自六類研究工作流:證據處理、分析、設計與最佳化、科學推理、驗證與營運、轉譯與溝通。以下是官方公布的三項專項評測,對手都是 GPT-5.5:
| 評測 | 測什麼 | GPT-Rosalind | GPT-5.5 | 差距(自行換算) | Token 用量 |
|---|---|---|---|---|---|
| MedChemBench | 藥物化學流程,如結構理解、藥效與毒性預測 | 27.5% | 25.1% | +2.4 個百分點 | 少 7.2% |
| GeneBench | 基因組學與定量生物的長流程分析(官方標示為準確率) | 21.6% | 20.4% | +1.2 個百分點 | 少 31% |
| LabWorkBench | 真實濕式實驗流程,從排錯到最佳化 | 63.2% | 55.8% | +7.4 個百分點 | 少 5.3% |
要注意兩點:第一,差距欄是用兩邊的分數相減算出的「百分點」,不是「成長了百分之幾」;第二,這些評測都是 OpenAI 自己設計並公布的,官方文章裡沒有提到第三方獨立重現的結果,所以建議把它當成「廠商自測」來看。
其中 LabWorkBench 是這次新介紹的評測,官方說它使用的是專有資料,因此不會有「題目早就被模型看過」的問題。
給開發者的技術細節:Codex 外掛與檢視器
- 兩款外掛:Life Sciences Research(取得有來源的證據、做生物學解讀)與 Life Sciences NGS Analysis(定序資料分析)。官方說所有使用者現在都能在 Codex 裡使用這兩款外掛;符合資格的 GPT-Rosalind 企業使用者,還可以讓 GPT-Rosalind 來驅動它們。
- 示範流程之一:把單細胞 RNA 定序(scRNA-seq)的矩陣檔,整理成經過品質控制(QC)的結果、註解與 UMAP 圖。
- 示範流程之二:把整批 RNA 定序(bulk RNA-seq)的樣本表、FASTQ 檔與參考檔,整理成通過品質檢查、可重複使用的計數結果,並附上 MultiQC、Salmon 矩陣與處理紀錄。
- 互動檢視器:Codex 新增了針對生物學檔案類型的檢視器,初期涵蓋序列、比對與結構三種,可以在檢視器裡直接接續提問。
- 管理方式:官方也提供由 OpenAI 代管的工作區,給沒有 Enterprise 帳號的合格組織。
後續更新(2026-09-11)
官方在原文加註:GPT-Rosalind 於 2026 年 9 月 11 日結束研究預覽,透過可信賴存取機制,對符合資格的組織全球開放;公布的定價將在 2026 年 10 月 5 日起生效。以上是本文發表日期之後的消息。
我的看法
這類模型有申請門檻,一般做網站與系統的接案者也不太會直接用到,所以這篇對我來說比較像是觀察趨勢。
第一,從這次更新看得出來,廠商開始把模型、工具外掛與檢視器包成一套「領域工作台」,不只是丟出一個更強的模型。對做軟體的人來說,這種做法值得參考:把領域資料格式、檢查步驟與可追溯的紀錄做進流程,比只換一個模型更實際。
第二,Token 用量是個有用的指標,不過官方這次的數字都來自自家評測,用量差異也沒有換算成金額,所以我不會直接把「少 31%」套用到自己的專案。要評估成本,還是得拿自己的資料與流程實測。
第三,這個模型走的是「先審核、再開放」的路線,對需要碰高風險領域資料的團隊來說,申請條件、治理與資安要求,會是比模型分數更先碰到的門檻。
名詞小辭典
- Token:AI 模型處理文字的最小單位,常是計費與延遲的基礎;用量少通常代表比較省,但官方這次沒有換算成金額。
- 代理式(Agentic):指 AI 不只回答問題,還能規劃步驟並使用工具(例如執行程式碼)來完成任務。
- NGS(Next-Generation Sequencing):次世代定序,一種能快速讀取大量 DNA 或 RNA 序列的技術,會產生很大量的資料,需要生物資訊軟體分析。
- 可信賴存取(Trusted-Access):OpenAI 對高風險或專業領域模型採用的開放方式,要求使用的組織通過資格審核,並具備治理與資安能力。