觀點 · 資訊分享
Azure 推出推論閘道預覽:依模型名稱與伺服器負載分流,替 AKS 上自架的 LLM 降低首字等待
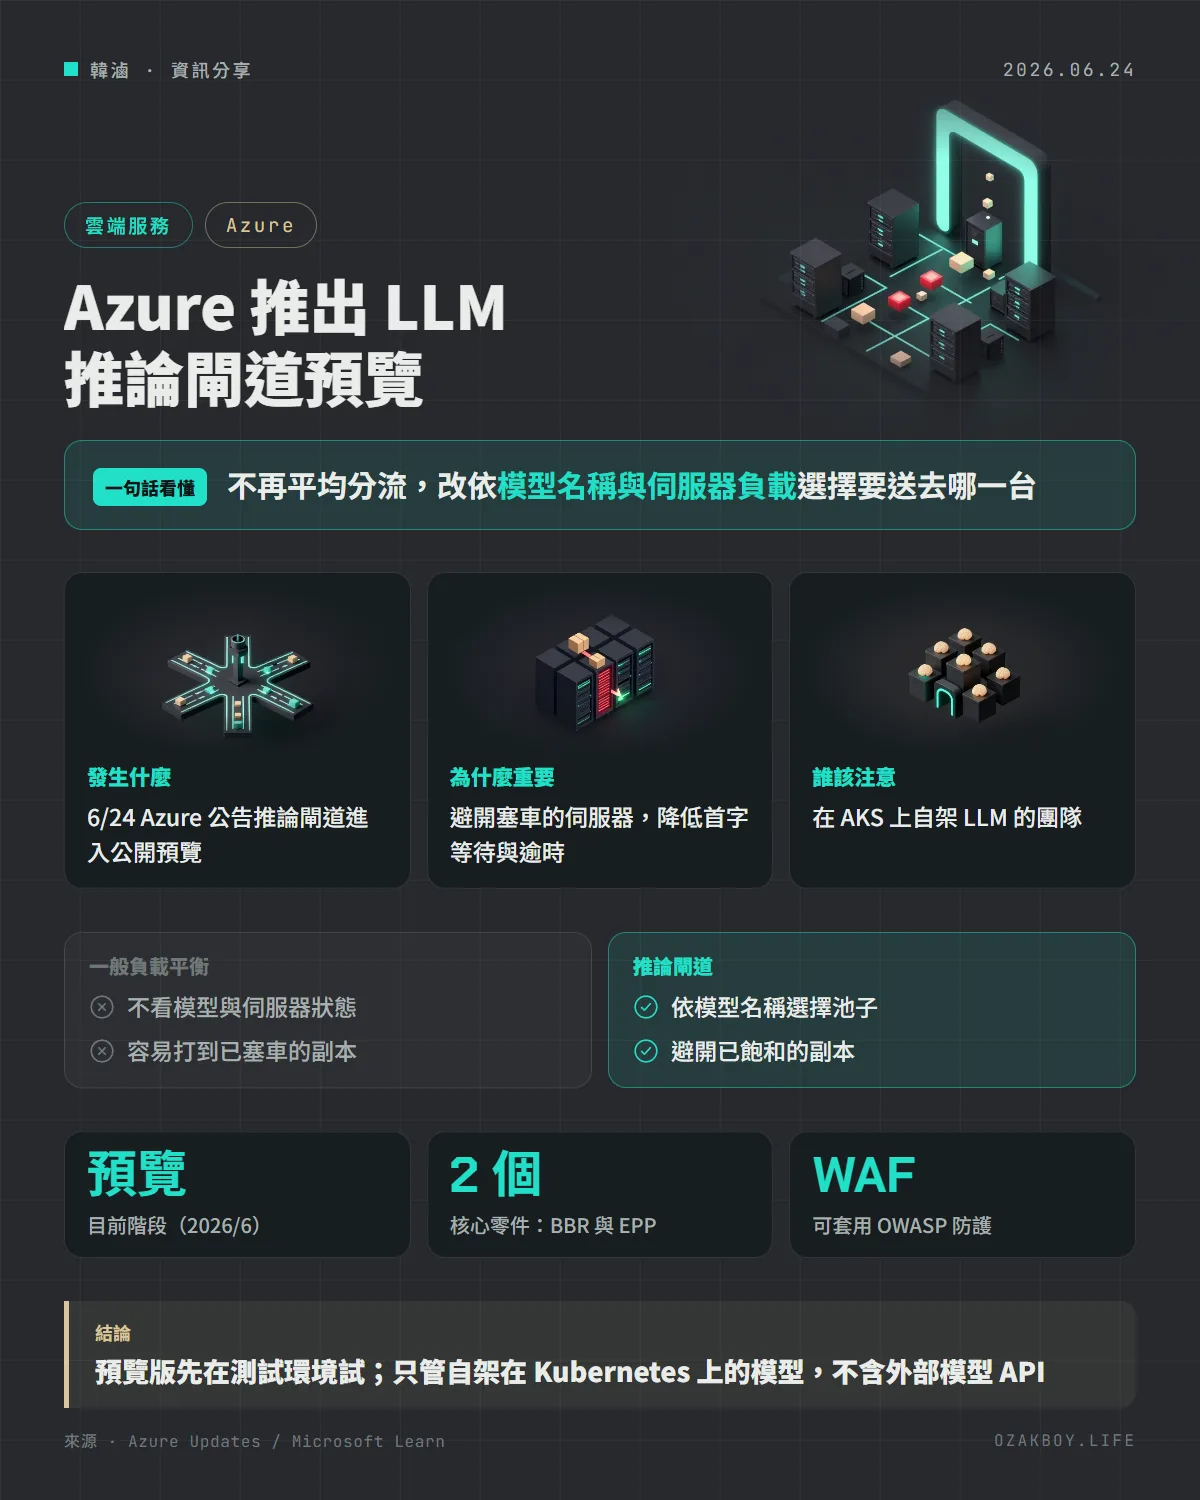
Azure Application Gateway for Containers 新增「推論閘道」預覽,支援 Kubernetes 的 Gateway API Inference Extension,能依模型名稱與模型伺服器狀態分流,並可套用 WAF 保護。
- 發布
- 2026-06-24
- 篇幅
- 約 4 分鐘 · 1,989 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
一句話看懂:Azure 的 Application Gateway for Containers 新增「推論閘道」預覽,可以依模型名稱與模型伺服器的負載來分流,替自架在 AKS 上的 LLM 降低首字等待與逾時。
先用白話講:為什麼 LLM 不能只用一般的負載平衡?
想像一間大醫院的掛號櫃台。傳統做法是「下一位病人隨機分到任何一個診間」。但如果有的診間專看心臟、有的專看骨科,還有一間排了二十個人,隨機分配就會害病人去錯診間,或是擠進最塞的那間。
大型語言模型(LLM)的伺服器很像這樣:不同伺服器載入不同模型,有的 GPU 已經塞滿請求。一般負載平衡不知道這些,推論閘道則會先看病人要看哪一科(請求要用哪個模型),再看每個診間現在排了多少人,才決定送到哪裡。
發生什麼事
Azure 在 6 月 24 日公告,Application Gateway for Containers 新增 AI 閘道功能,也就是「推論閘道」,進入公開預覽:
- 它把 Kubernetes 的 Gateway API Inference Extension 帶進 Application Gateway for Containers
- 支援依模型與負載分流,對象是自架在 AKS(Azure Kubernetes Service)上的生成式 AI 工作
- 官方說目標是降低首字等待時間(TTFT)、減少高負載下的逾時,並提升 GPU 使用效率
- 可搭配 Application Gateway for Containers 既有的網頁應用程式防火牆(WAF),在請求到達模型伺服器前套用 OWASP 對齊的保護
四個要認識的零件
| 零件 | 做什麼 |
|---|---|
| InferencePool | 一種後端資源,代表一群模型伺服器 Pod,以及用來挑選 Pod 的端點挑選器 |
| EPP(端點挑選器) | 由你自己提供,依伺服器的排隊深度、快取使用率等資訊,為每個請求挑一台 |
| BBR(主體路由器) | 讀取 OpenAI 相容請求中的模型名稱,讓閘道能依模型分流;由 Azure 託管,不用自己部署 |
| InferenceObjective | 描述請求的服務目標,例如優先順序 |
給開發者的技術細節
以下取自 Microsoft Learn 文件的現況(我讀到的頁面可能在 6 月 24 日之後更新過):
- 怎麼啟用:HTTPRoute 的後端指向 InferencePool 而不是一般的 Service,閘道才會走推論流程;指向 Service 的路由維持原本行為
- 模型感知路由:BBR 會讀取請求內文中的模型名稱,放進標頭
X-Gateway-Model-Name,HTTPRoute 再依它選擇池子 - 流量切分:可用 HTTPRoute 的權重式後端,在不同 InferencePool 之間切分流量,做模型的金絲雀或藍綠發布
- 優先順序:用 InferenceObjective 與請求標頭設定優先順序,伺服器飽和時,先捨棄低優先的請求
- 失敗行為:EPP 失效時,可設為放行(FailOpen)或拒絕(FailClose)
- 限制:只針對自架在 Kubernetes 的推論工作,直接路由到公開或託管的模型服務不在範圍內;也是預覽功能,適用微軟的預覽補充條款
我的看法
多數中小型專案不會自己養一群 GPU 伺服器跑 LLM,所以這則消息對我來說更像是「趨勢提示」:AI 流量跟傳統網頁流量的特性不一樣,請求長、成本高、會被伺服器狀態影響,所以閘道要變聰明。
如果你有在 Kubernetes 上自架 vLLM 或類似的服務,而且副本不只一台,這個功能值得評估;但它是預覽版,我會先在測試環境對比「一般負載平衡」與「推論閘道」的首字等待與逾時差異,再決定要不要換。若只是單機跑 Ollama 或呼叫外部 API,就用不到。
名詞小辭典
- 推論(Inference):模型根據輸入產生回答的過程,相對於「訓練」。
- TTFT(Time to First Token):從送出問題到出現第一個字的等待時間。
- AKS:Azure Kubernetes Service,Azure 代管的 Kubernetes 服務。
- WAF(Web Application Firewall):網頁應用程式防火牆,擋掉常見的惡意請求。