觀點 · 資訊分享
Google Cloud 託管執行個體群組可以「只監控、不自動修復」:想先保留故障現場的人多了一個正式開關
Compute Engine 在 6/26 宣布,託管執行個體群組(MIG)的健康檢查可以只負責監控,不再自動重建出問題的 VM。想先查原因、或自己寫修復流程的團隊,現在有正式支援的做法。
- 發布
- 2026-06-27
- 篇幅
- 約 4 分鐘 · 1,646 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
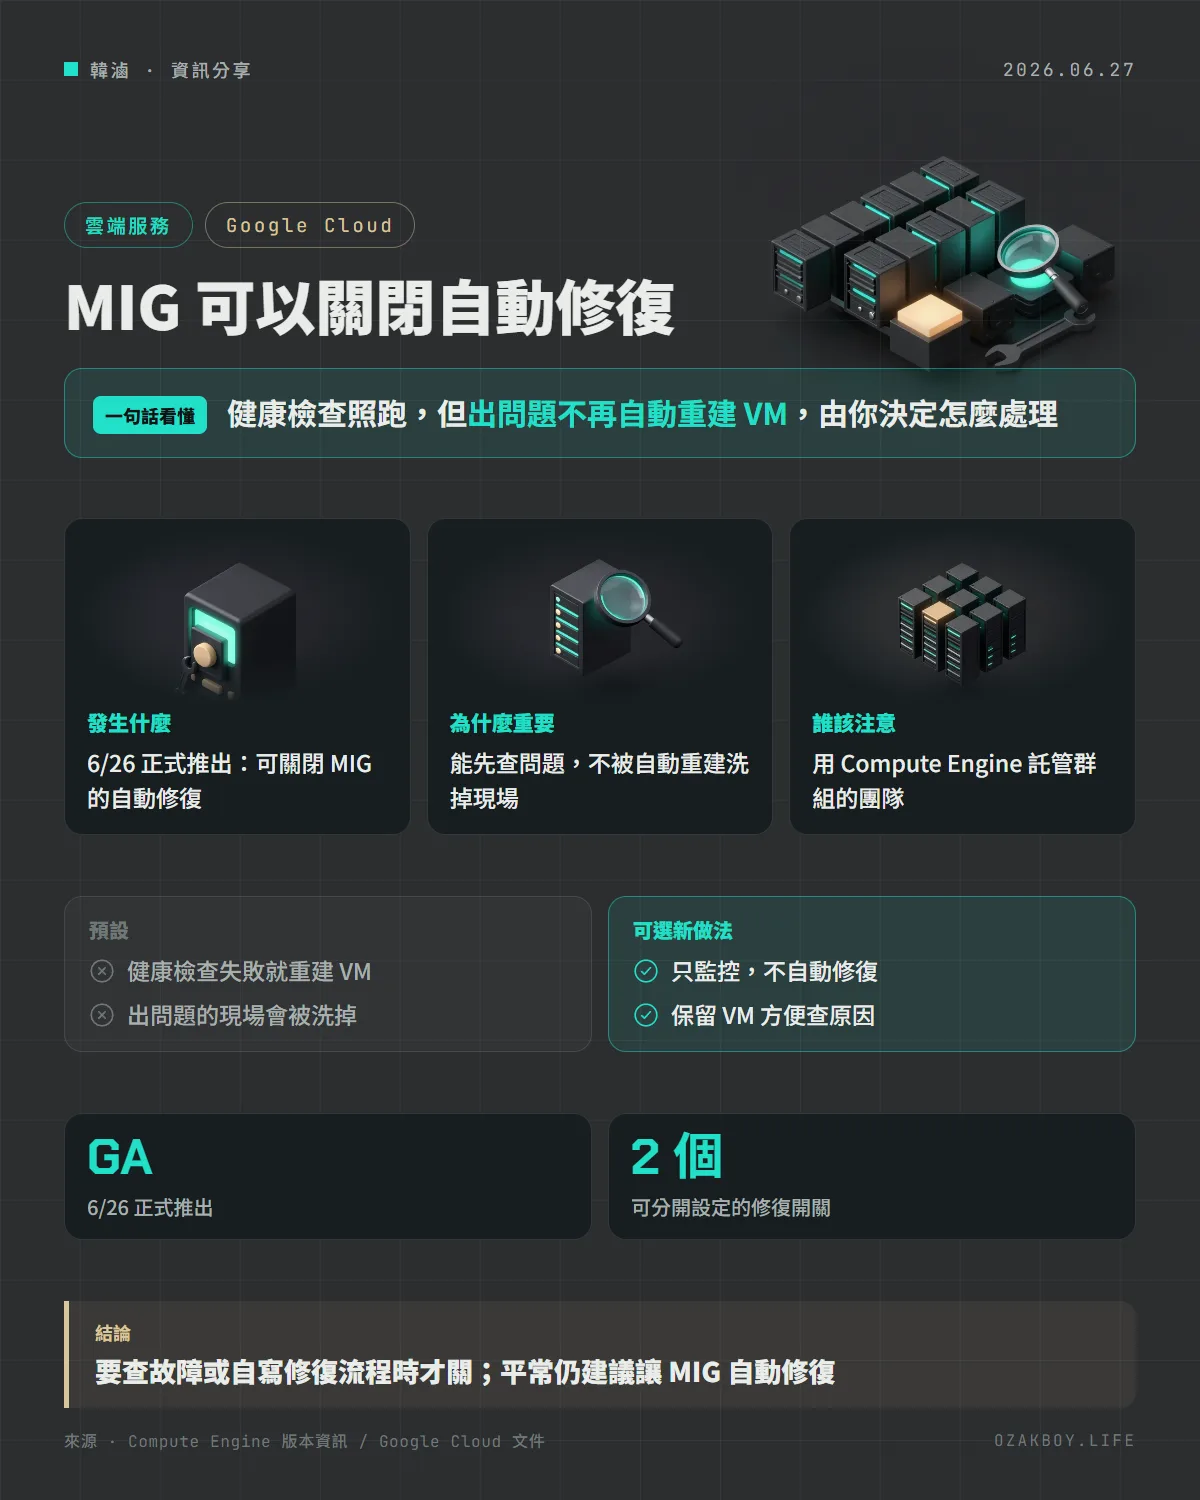
一句話看懂:Google Cloud 的託管執行個體群組(MIG)現在可以讓健康檢查「只監控、不動手」,不再自動重建出問題的 VM,6 月 26 日正式推出。
先用白話講:MIG 與自動修復是什麼?
想像一間連鎖早餐店,有 10 台一模一樣的咖啡機。MIG 就是這個「機隊」,店長(Google Cloud)負責管理。每隔一陣子,店長會檢查每台機器能不能正常出咖啡;如果有一台壞了,店長會直接把它換成全新的。這個「壞了就換新」的動作就是自動修復(autohealing)。
大部分時候這很方便。但如果你想知道「這台機器為什麼會壞」,它被換掉之後,證據就沒了。
發生什麼事
Google Cloud 在 6 月 26 日的 Compute Engine 版本資訊寫道:在 MIG 裡,可以用健康檢查監控應用程式的健康狀態,而不觸發對不健康 VM 的修復;做法是關閉 autohealing。這項功能是正式推出(Generally available)。
官方文件說明了預設行為與使用情境:
- 預設:MIG 會自動重建失敗的 VM;如果有設定應用程式健康檢查,連應用程式沒回應的 VM 也會被修復
- 可以關閉修復的情境:排查失敗的 VM、實作自己的修復邏輯、只監控健康而不修復
兩個獨立的開關
| 設定 | 管什麼 |
|---|---|
| 預設的失敗動作 | VM 本身失敗時,MIG 要不要修復 |
| 健康檢查失敗的動作 | 應用程式沒通過健康檢查時,MIG 要不要重建(autohealing) |
兩個可以分開設定:例如你可以讓「VM 失敗」關閉修復,但保留「健康檢查失敗」的自動重建。反過來,只關掉 autohealing 並不會停止失敗 VM 的修復。
給開發者的技術細節
以下指令取自 Google Cloud 目前的文件,實際使用前請以文件為準。
只關閉 autohealing(健康檢查照跑,不重建):
gcloud compute instance-groups managed update MIG_NAME \
  --action-on-vm-failed-health-check=do-nothing \
  --zone=ZONE
關閉整個 MIG 的預設修復,但保留 autohealing:
gcloud compute instance-groups managed update MIG_NAME \
  --default-action-on-vm-failure=do-nothing \
  --action-on-vm-failed-health-check=repair \
  --zone=ZONE
- 區域型 MIG 把
--zone換成--region - 用 REST API 的話,設定在
instanceLifecyclePolicy的defaultActionOnFailure與onFailedHealthCheck - 限制:如果 MIG 有設定自動調整規模(autoscaling),或有被暫停或停止的 VM,就不能用
defaultActionOnFailure設成DO_NOTHING來關閉修復
我的看法
這個功能的價值在於「保留現場」。很多人遇過的情況是:服務偶爾出問題,等你登入查看時,自動機制已經把那台機器換掉,連 log 都跟著消失,只能靠猜。有個正式支援的開關,讓團隊在查問題的時間窗口內暫停重建,是很實用的。
但我不建議平常就關掉。自動修復本來就是 MIG 最重要的價值之一,關掉之後出問題要靠人處理,半夜出事就沒人替你換機器。比較好的做法是:平常保持預設,要查特定問題時才暫時關閉,查完記得打開,或搭配警示通知,確保出事時有人知道。
名詞小辭典
- MIG(Managed Instance Group,託管執行個體群組):由同一份範本建立的一群 VM,由 Google Cloud 負責維持數量與健康。
- Autohealing(自動修復):MIG 用健康檢查發現應用程式沒回應,就把那台 VM 重建。
- 健康檢查(Health check):定期探測應用程式是否能正常回應的機制。
- GA(Generally Available):功能正式推出,可以放心用在正式環境。