觀點 · 資訊分享
llama.cpp 加入 DFlash 推測解碼:本機跑大模型最高快約 8 倍,但要看模型與題目
本機跑模型的核心工具 llama.cpp 在 6/28 合併 DFlash 推測解碼:讓小模型一次猜一整段字,大模型再批次檢查。PR 實測 Qwen3-8B 最高快 8.08 倍,但開啟思考或換成 MoE 模型時,加速有限,甚至會變慢。
- 發布
- 2026-06-28
- 篇幅
- 約 4 分鐘 · 1,797 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
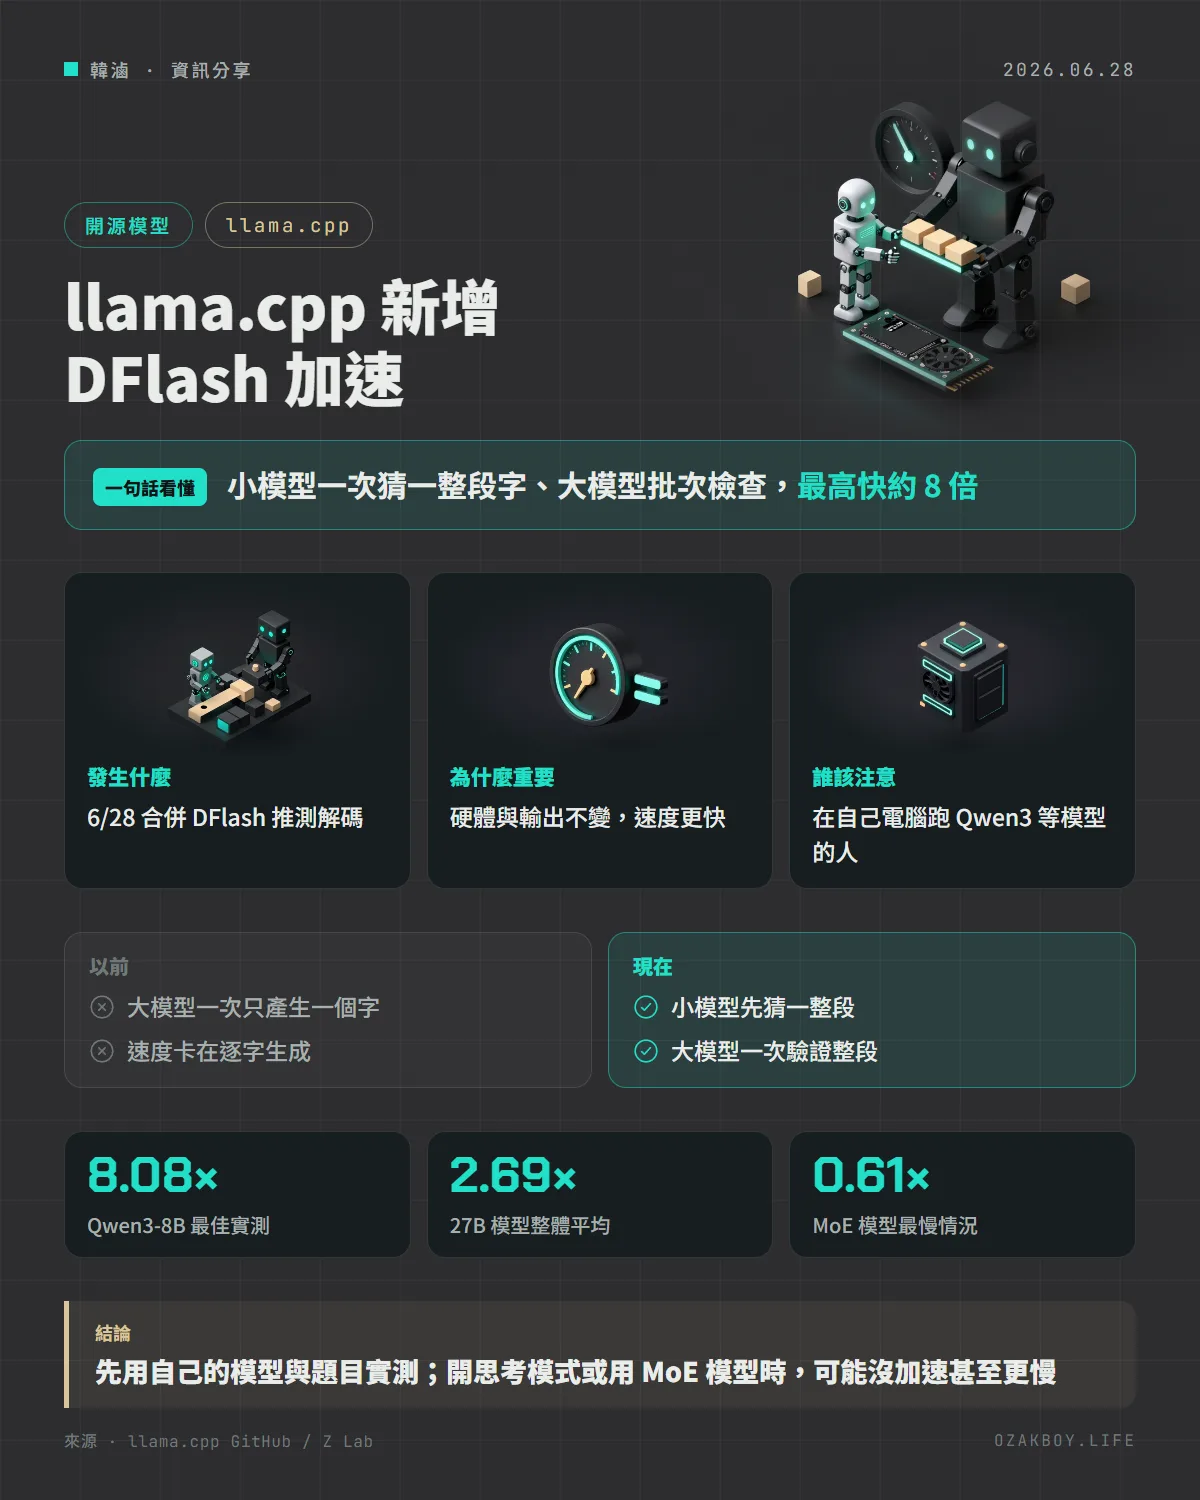
一句話看懂:本機跑模型的工具 llama.cpp 在 6 月 28 日加入 DFlash 推測解碼,讓小模型先一次猜一整段字、大模型再批次檢查,在 PR 的測試中最高快 8.08 倍,但不是所有情況都會變快。
先用白話講:推測解碼是什麼?
想像一位資深主編(大模型)在改稿,他一個字一個字斟酌,品質很好但很慢。現在請一位實習生(小模型)先幫忙起草接下來的一整段,主編只要快速掃一遍:寫對的直接收下,寫錯的從錯的地方重改。
因為最後每個字都由主編把關,成品不會變差,只是省下一個字一個字寫的時間。這就是推測解碼。
發生什麼事
llama.cpp(很多本地執行工具的底層引擎)在 6 月 28 日合併了 PR #22105,加入 DFlash 這種推測解碼方式,並包含在同日的 b9831 版本。
它跟常見的 EAGLE3 有什麼不同,PR 說明得很清楚:
| 項目 | EAGLE3 | DFlash |
|---|---|---|
| 草稿方式 | 逐字產生候選 | 一次運算產生整個區塊的候選 |
| 草稿模型的層數 | 一層 transformer | 多層 transformer |
| 每輪草稿產量 | 較低 | 較高 |
PR 同時說明,這個實作與原始參考實作的數值完全一致。
實際快多少
以下數字都來自 PR 描述,由 PR 作者自己測,條件不同,不能直接套用在你的電腦上:
- Qwen3.6-27B(Q4_K_M,在 DGX Spark 上,SpeedBench):整體平均從每秒 12.57 個 token 提升到 33.76,約 2.69 倍;寫程式類 3.11 倍,檢索增強類 4.07 倍
- Qwen3-8B(bf16):關掉思考模式、寫 Python 快速排序,從 51.9 提升到 419.3 t/s,達 8.08 倍(接受率 93.3%);但開啟思考模式只有 1.77 倍,規劃旅行這類開放題只有約 1.1 到 1.5 倍
- gpt-oss-20b(MoE 模型):加速有限,部分測試是 0.61 到 0.98 倍,也就是比不用還慢。PR 的解釋是,MoE 模型在驗證整段候選時會同時啟用更多專家
另外,研究團隊 Z Lab 的專案頁寫的是「在 Qwen3-8B 上最高約 6 倍」,與 PR 的 8.08 倍測試條件不同,不矛盾,但別把兩個數字混在一起。
給開發者的技術細節
以下步驟取自 PR 描述,旗標名稱與用法請以最新文件為準:
- 把主模型與配對的 DFlash 草稿模型都轉成 GGUF,轉草稿模型時要指定主模型目錄:
python convert_hf_to_gguf.py "${DFLASH_MODEL_HF}" \
  --outtype bf16 \
  --target-model-dir "${TARGET_MODEL_HF}" \
  --outfile "${DFLASH_MODEL_GGUF}"
- 用 llama-server 啟動:
./build/bin/llama-server \
  -m "${TARGET_MODEL_GGUF}" \
  -md "${DFLASH_MODEL_GGUF}" \
  --spec-type draft-dflash \
  --spec-draft-n-max 15 \
  --temp 0 --top-k 1 -ngl 99 -fa on --jinja
- 草稿模型要與主模型配對,PR 使用的是 z-lab 發布的
Qwen3-8B-DFlash等模型 - 範例用
--temp 0 --top-k 1(貪婪取樣);PR 沒有說明其他取樣設定下的表現,這裡也沒有驗證 - 混合架構的模型(例如 Qwen3.5),PR 提到靠推測檢查點機制處理狀態回復
我的看法
我自己平常在家用本地模型(Ollama、ComfyUI),最在意的就是「同樣的硬體,能不能再快一點」。推測解碼是少數「不犧牲品質」的加速手法,所以每次有新進展我都會留意。
但看到「最高 8 倍」要冷靜:最漂亮的數字出在關掉思考模式、寫程式這種很好猜的題目,因為小模型猜得準,主編才收得快。一旦題目開放、或模型改成 MoE,加速就掉下來,甚至變慢。建議用自己真正會問的題目跑一遍,再決定要不要常駐開著;也要記得,這是剛合併的新功能,先別直接放進正式服務。
名詞小辭典
- 推測解碼(Speculative Decoding):小模型先猜、大模型批次驗證的加速方法,輸出內容不變。
- 草稿模型(Draft Model):負責先猜候選字的小模型。
- tok/s(t/s):每秒產生多少個 token(文字片段)。
- MoE(混合專家):把模型拆成多位專家、每次只叫部分來答題的架構。
- GGUF:llama.cpp 使用的模型檔案格式。