觀點 · 資訊分享
Ollama 0.40.4:Codex CLI 可以直接挑本機模型,終端機一行指令就能讓 AI 判斷是或否
Ollama 0.40.4 讓 ollama launch codex 的模型選單出現本機安裝的模型,決策模型也能直接在終端機用 ollama run 問是非題、分類與評分;另外改善推論效能、支援多模態嵌入,Gemma 4 在 NVIDIA 顯示卡上的前置處理也變快。
- 發布
- 2026-10-12
- 篇幅
- 約 3 分鐘 · 1,503 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
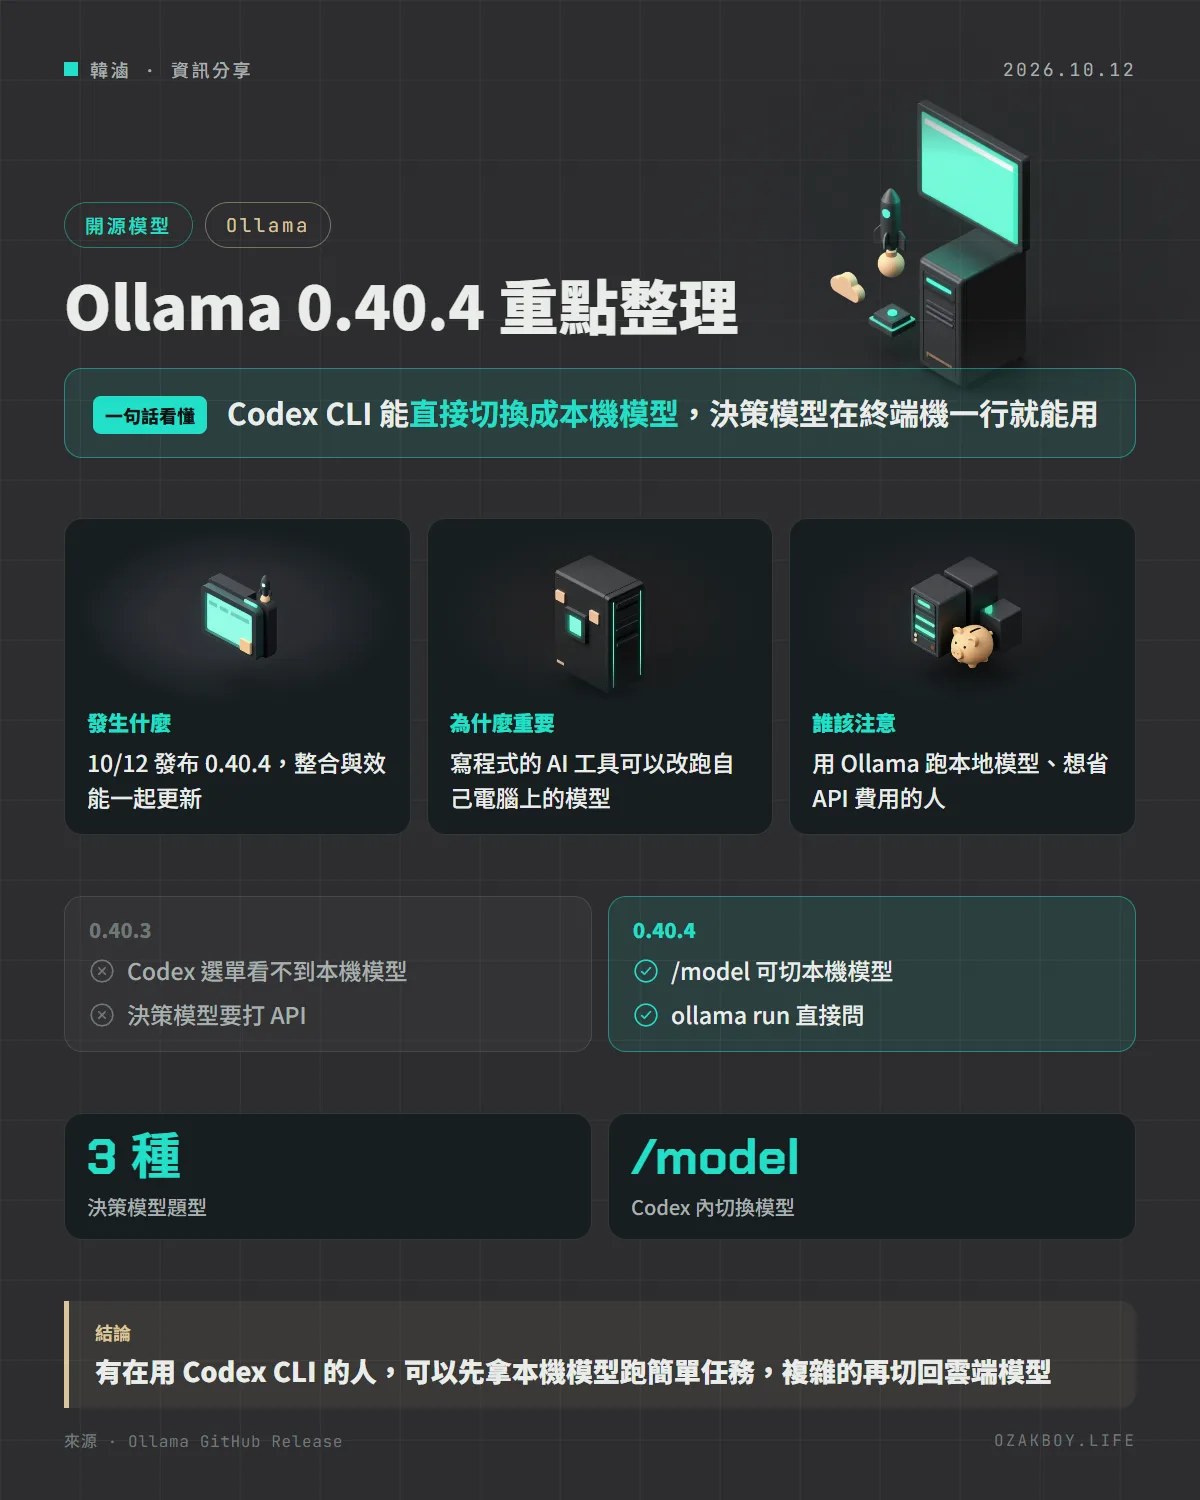
一句話看懂:Ollama 0.40.4 讓 Codex CLI 可以直接挑選本機安裝的模型,決策模型也能在終端機一行指令就用,想用本地 AI 寫程式、做分類的人更方便了。
先用白話講:Ollama 和 Codex CLI 是什麼?
Ollama 是在自己電腦上跑 AI 模型最常見的工具,下載一個模型、打一行指令就能聊天,資料不用送到雲端。Codex CLI 則是 OpenAI 做的「終端機裡的寫程式 AI」,可以幫你讀程式碼、改檔案、跑指令。
Ollama 提供 ollama launch 指令,能直接幫你把 Codex 這類工具接到 Ollama。這次更新,就是讓這條路更順。
發生什麼事
Ollama 在 10 月 12 日發布 0.40.4,重點有兩個:
1. 決策模型可以直接在終端機用
以前要呼叫 API,現在用 ollama run 就能問是非題、分類或評分,例如把客服工單丟進去問「這是在要求退款嗎?」:
ollama run nimble --ask "Is a refund being requested?" < ticket.txt
2. Codex CLI 看得到本機模型
ollama launch codex 的模型選單,現在會列出你本機安裝的 Ollama 模型,在 Codex CLI 裡輸入 /model 就能切換。
其他更新
ollama launch可以用額度點數(usage credits),不必升級付費方案- 重複使用已驗證的模型資訊與已載入的模型,改善推論效能
- 透過 llama-server 支援多模態嵌入(multimodal embeddings),也修正小上下文的多模態嵌入模型載入問題
- 在 Apple 晶片上,MLX 執行器支援 Kev 決策模型
- MLX 執行器改善 Gemma 4 在 NVIDIA 顯示卡上的前置處理效能,並提升推測解碼的穩定性
- 更新 README 與文件,更清楚說明隱私與雲端服務
給開發者的技術細節
決策模型是 Ollama 在 0.35.0 加入的功能,走 /v1/systemone 端點,回傳的不是文章而是結構化答案。三種題型:
| 題型 | 用途 | 回傳 |
|---|---|---|
choice |
從幾個選項挑一個 | 選擇結果與各選項機率 |
noul |
判斷某個條件成不成立 | 成立的機率 |
score |
依評分標準打分 | 分數 |
適合的場景包括工單分流、內容分類、決定要把請求交給哪個模型。這種「只要答案、不要長篇大論」的工作,用決策模型比一般聊天模型更快也更好解析。
我的看法
很多人用本地模型卡在「工具接不起來」:模型裝好了,但習慣的寫程式工具只認雲端 API。這次 Codex CLI 直接列出本機模型,等於少了一道設定。我會建議先拿本機模型處理簡單、重複的修改,例如改命名、補註解、寫小測試,真正複雜的架構調整再切回雲端模型,這樣比較省 API 費用。
決策模型的 CLI 對做系統的人也很實用。像客戶的聯絡表單、LINE 訊息分類,以前要寫一段程式呼叫 API,現在可以先在終端機用真實資料試一試,確定準確率可以接受,再寫進系統裡。
名詞小辭典
- CLI:命令列介面,在終端機打指令操作的工具。
- 決策模型:只回傳選擇、機率或分數的模型,適合分類與判斷。
- 嵌入(Embedding):把文字或圖片轉成一串數字,方便拿來比對相似度、做搜尋。
- 推測解碼:先用小模型快速猜答案、再由大模型確認,藉此加快產生速度的技術。