觀點 · 資訊分享
Google Cloud Run 多區域自動容錯移轉正式推出:一個區域出問題,流量自動切到另一個區域
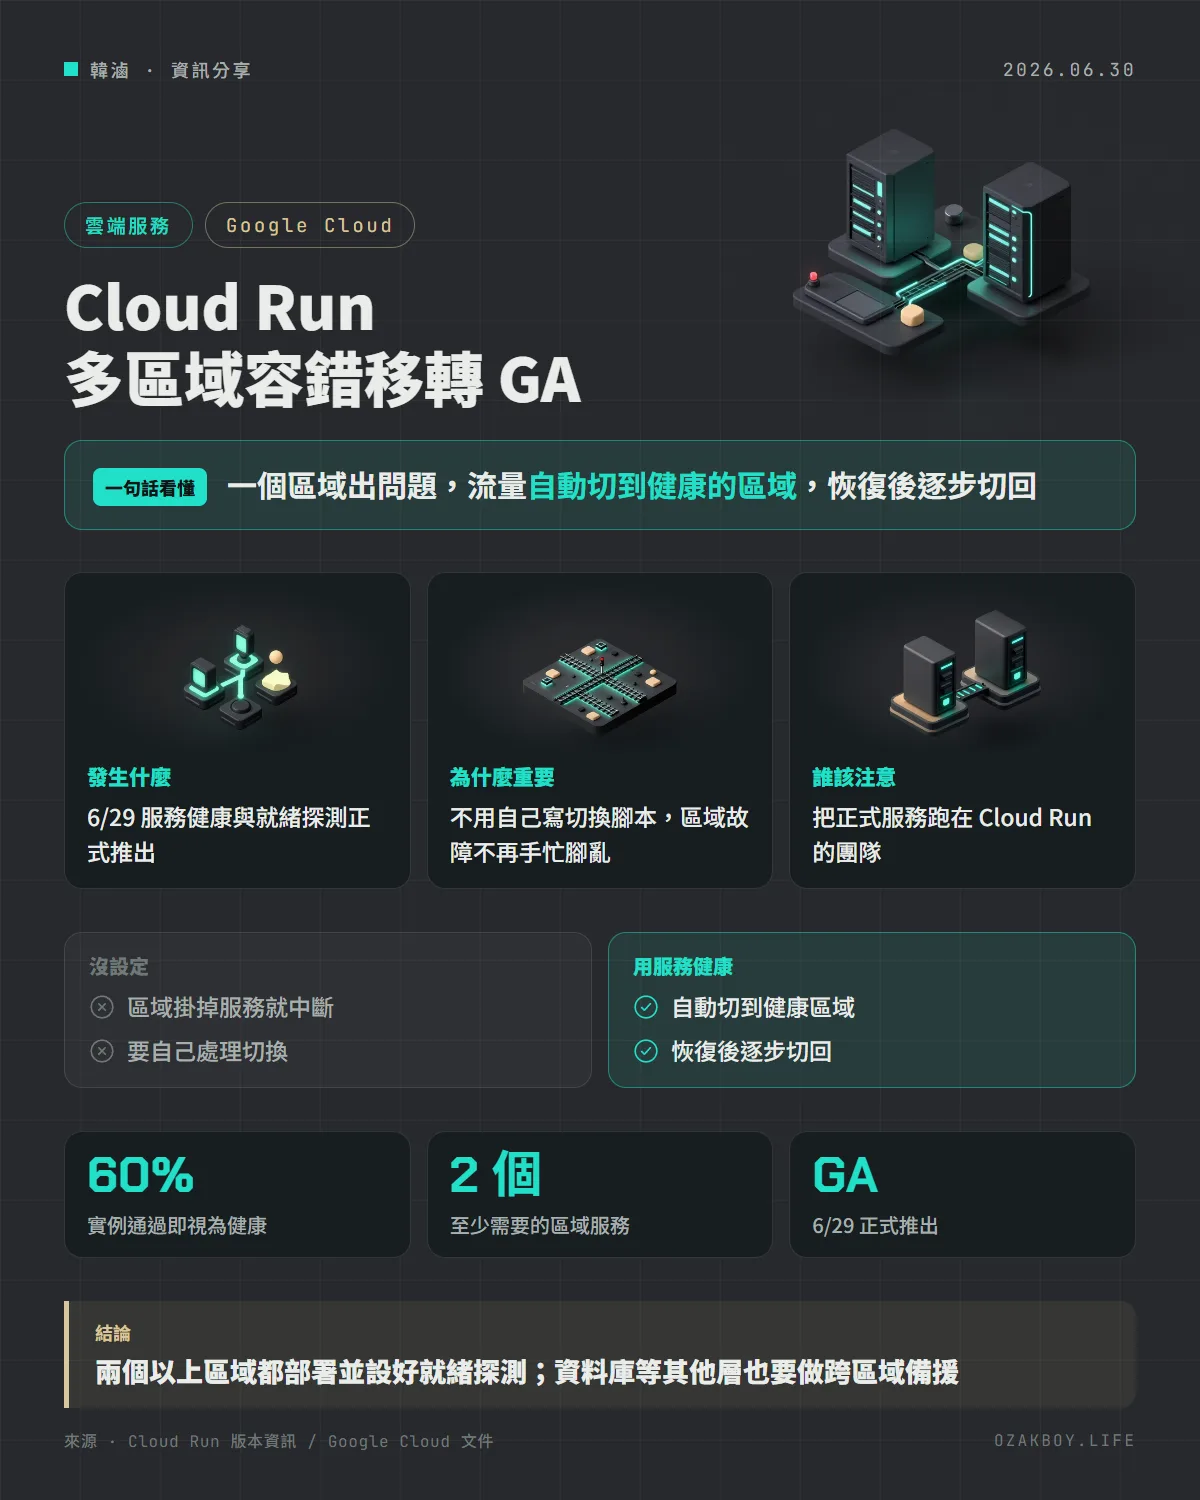
Google Cloud 在 6/29 讓 Cloud Run 的「服務健康」多區域容錯移轉與 HTTP、gRPC 就緒探測同時正式推出(GA)。區域掛掉時由負載平衡器自動改走健康的區域,恢復後再逐步切回。
- 發布
- 2026-06-30
- 篇幅
- 約 4 分鐘 · 1,724 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
一句話看懂:Google Cloud 的 Cloud Run 現在可以在多個區域部署同一個服務,一個區域出問題時,由負載平衡器自動把流量切到健康的區域,恢復後再逐步切回,這項功能 6 月 29 日正式推出。
先用白話講:什麼是容錯移轉?
想像一家連鎖咖啡店,台北和高雄各有一間分店。如果台北店突然停電,大家不用打電話通知,導航軟體自動把客人導去高雄店;等台北店恢復營業,再慢慢把客人導回來。
Cloud Run 的服務健康做的就是這件事:你把同一個服務放在兩個以上的區域,Cloud Run 一直在檢查各區域「是否還正常營業」,不正常就自動改走別的區域。
發生什麼事
Google Cloud 在 6 月 29 日的 Cloud Run 版本資訊中宣布兩項功能正式推出(GA):
- 多區域高可用服務:使用 Cloud Run 服務健康,對內部與外部流量做自動容錯移轉與容錯回復
- 就緒探測:可以為 Cloud Run 服務設定 HTTP 與 gRPC 的就緒探測
它是怎麼運作的
根據官方文件:
- 每個容器實例會執行就緒探測
- Cloud Run 把這些結果彙整,算出每個區域服務的整體健康狀態,並透過無伺服器網路端點群組(Serverless NEG)提供給負載平衡器
- 一個區域的服務,有 60% 以上的實例通過探測,才視為健康並接收流量
- 區域不健康時,負載平衡器自動把流量導到健康區域;區域恢復後,再逐步把流量切回
| 流量類型 | 搭配的負載平衡器 |
|---|---|
| 公開(外部)流量 | 全球外部應用程式負載平衡器 |
| 私有(內部)流量 | 跨區域內部應用程式負載平衡器 |
給開發者的技術細節
官方文件列出的限制與注意事項:
- 至少兩個區域:容錯移轉需要至少兩個不同區域的服務,否則一個服務失敗時,會顯示「no healthy upstream」錯誤
- 沒設探測就不會切換:沒有設定探測的版本,以及還沒完成第一次探測的新實例,都被視為「未知」;負載平衡器會把未知當成健康
- 無伺服器 NEG 不能設定 URL 對應或標籤
- 如果 Cloud Run 服務被刪除,Cloud Run 不會向負載平衡器回報不健康
- 新啟動的實例不計入第一次就緒探測,所以請求可能短暫導向剛啟動、還沒完全準備好的服務
- 實例快速反覆當掉時,服務健康的計算可能不準
- 官方也建議把就緒探測、流量分配與最小實例數搭配使用,做新版本的安全漸進式上線
實際設定的步驟(探測設定、建立全球外部應用程式負載平衡器、加入無伺服器 NEG)請照官方教學操作,本文沒有逐步驗證指令。
我的看法
多區域部署以前常讓小團隊卻步,原因不只是設定麻煩,而是「到底誰來決定何時切換」很難回答。把這件事交給負載平衡器和健康檢查,是比較務實的做法。
但有兩個提醒。第一,探測的設計很關鍵:探測太簡單(例如永遠回 200),區域壞了也不會被發現;探測太嚴格(例如把外部資料庫也算進去),可能一點小狀況就大規模切換。第二,Cloud Run 本身是無狀態的,如果你的資料庫還放在單一區域,切到另一個區域之後,應用程式連不到資料庫,還是等於沒服務。我會建議先盤點整條路徑上有哪些單點,再決定要不要做多區域。
名詞小辭典
- Cloud Run:Google Cloud 的無伺服器容器服務,依流量自動擴縮。
- 容錯移轉(Failover):服務出問題時,自動切換到備援的機制;容錯回復(Failback)是恢復後切回。
- 就緒探測(Readiness Probe):定期檢查容器是否準備好接收請求的小檢查。
- Serverless NEG:讓負載平衡器能把流量導到 Cloud Run 等無伺服器服務的端點群組。