觀點 · 資訊分享
Transformers 5.13.0 新增 Qwen3 ASR 等 9 組模型架構,還加入統一的模型匯出工具
Hugging Face 的 Transformers 在 7 月 3 日釋出 5.13.0:一口氣新增 9 組模型架構(含 Qwen3 ASR、Kimi K2.5 系列、MiMo-V2-Flash),並加入統一的模型匯出工具,同時有幾項會改變行為的調整要留意。
- 發布
- 2026-07-04
- 篇幅
- 約 4 分鐘 · 1,794 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
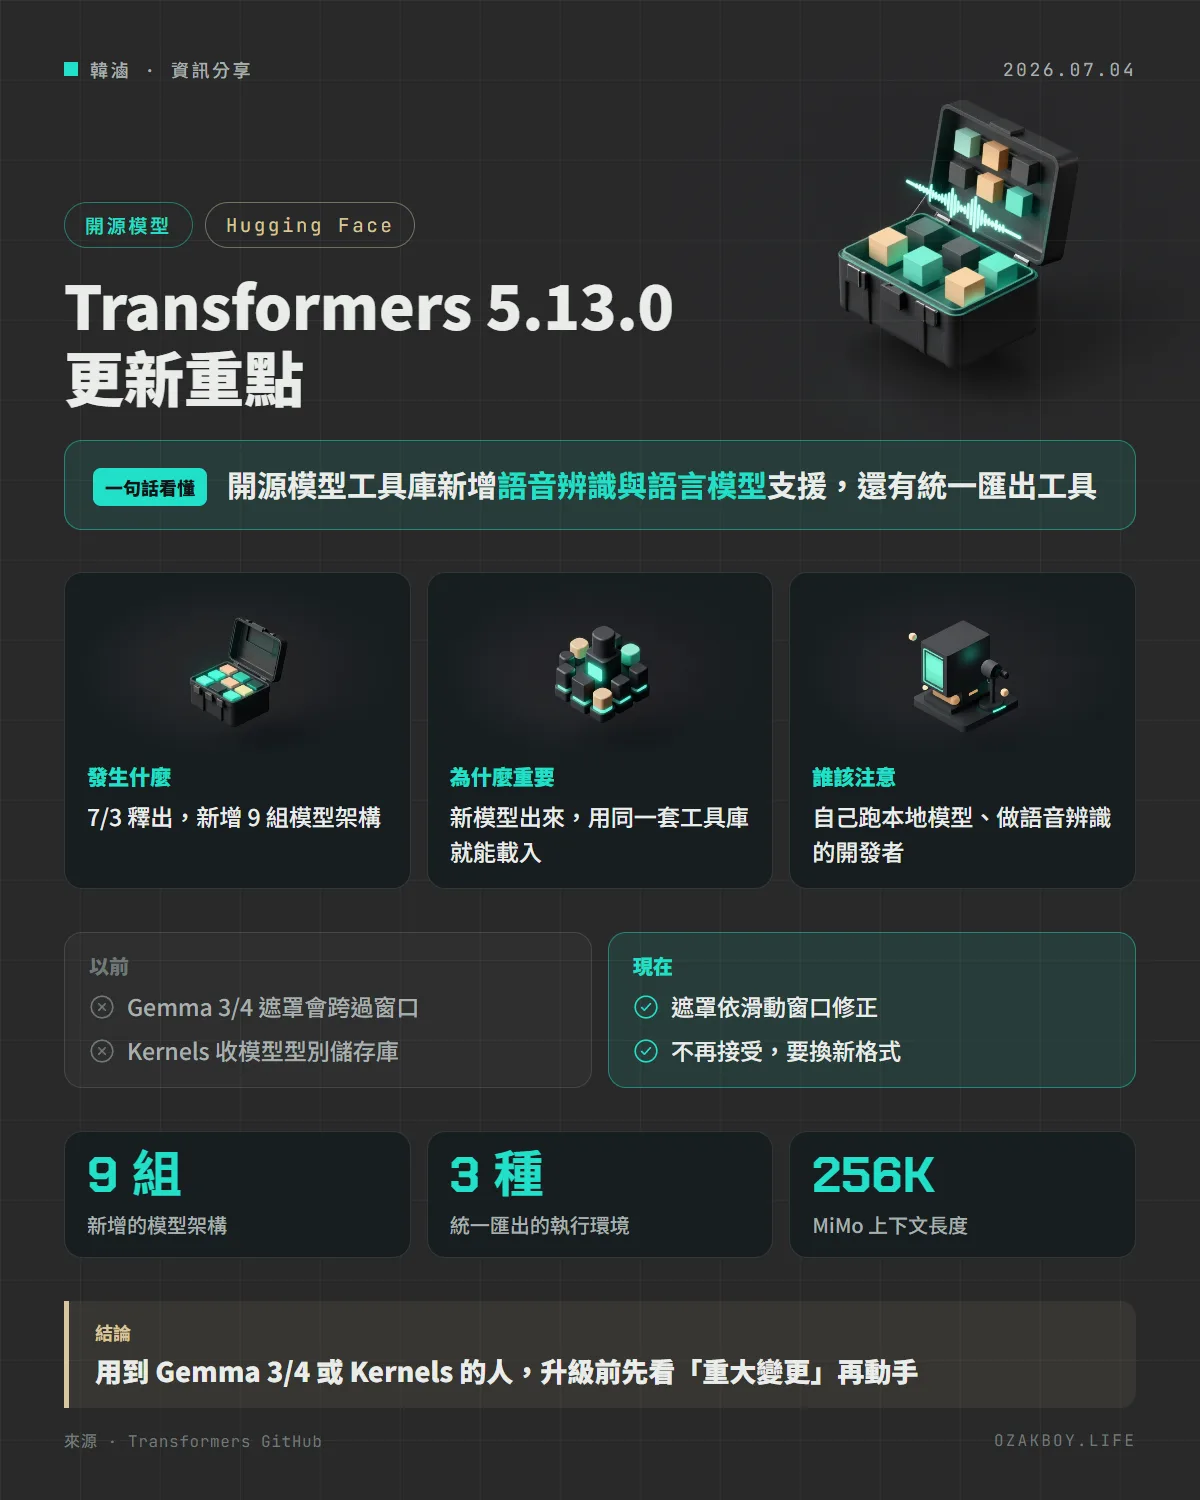
一句話看懂:Hugging Face 的 Transformers 在 7 月 3 日釋出 5.13.0,新增 9 組模型架構(含 Qwen3 ASR 語音辨識),並加入統一的模型匯出工具,但也有幾項會改變行為的調整。
先用白話講:Transformers 是什麼?
每個 AI 模型都有自己的「說明書」:怎麼讀取、怎麼算、怎麼輸出。如果每個模型都要自己寫一套,開發者會瘋掉。Transformers 是 Hugging Face 做的開源工具庫,把各家模型的說明書統一收進同一個工具箱,開發者用幾行程式就能叫出各種模型。
新模型出來時,通常要等 Transformers 加入支援,大家才好用。這次的 5.13.0 就是一次補進一大批。
發生什麼事
依官方 GitHub 更新說明(2026 年 7 月 3 日),5.13.0 新增 9 組模型架構:
| 模型 | 來源 | 一句話 |
|---|---|---|
| Kimi K2.5、K2.6、K2.7 | Kimi | K2.5 是開源的原生多模態代理模型,擅長長時間程式開發;架構同時供 2.5 到 2.7 使用 |
| MiMo-V2-Flash | 小米 MiMo 團隊 | 混合專家(MoE)語言模型,支援 256K 上下文,並降低 KV 快取用量 |
| Nemotron 3.5 ASR | NVIDIA | 6 億參數、多語言語音辨識,串流可選 80、160、560、1120 毫秒的處理區塊 |
| Nemotron ASR Streaming | NVIDIA | 6 億參數的英文版串流語音辨識 |
| Qwen3 ASR | 阿里巴巴 Qwen | 語音轉文字,附帶強制對齊模型可為逐字稿標時間點 |
| ZAYA1 | Zyphra | 啟用 7.6 億、總計 84 億參數的 MoE 語言模型 |
| VideoPrism | Google DeepMind | 通用影片編碼器 |
| RADIO | NVIDIA | 把多個視覺模型蒸餾成一個的視覺基礎模型 |
| MiniCPM3 | OpenBMB | 4B 模型,官方說在標準測試上勝過許多 7B 到 9B 的開源模型 |
統一的匯出工具
另一個重點是 HfExporters:把模型匯出成不同執行環境用的格式,現在有一套統一的呼叫方式,三個子類別對應三種目標:
DynamoExporter:匯出成 PyTorch 的ExportedProgram,可做提前編譯OnnxExporter:匯出成 ONNX,可交給 ONNX Runtime、TensorRT、OpenVINO 等ExecutorchExporter:匯出給手機與邊緣裝置用的 ExecuTorch
官方說預設使用動態形狀,生成式模型會自動拆成 prefill(讀完提示詞)與 decode(逐字產生)兩段。
給開發者的技術細節
官方標示的重大變更(升級前務必看):
- 建模程式碼重整:為了讓更多模型能乾淨地匯出與編譯,統一了層宣告、遮罩與快取建構、混合注意力處理;依賴內部建模 API 的人可能要調整
- Gemma 3/4:影像 token 的注意力遮罩修正為遵守滑動窗口邊界,會改變模型行為,可能影響先前結果的重現性
- 專家平行(EP)與 FP8:修正 EP 路由器的約定並遵循 FP8 縮放格式,使用 EP 或 FP8 量化的人要確認設定
- Kernels 整合:同步到最新版,模型型別的儲存庫不再被接受,需改用新的儲存庫格式
升級指令:
pip install -U "transformers==5.13.0"
我的看法
對自己在本機或 NAS 跑開源模型的人來說,這個版本最實用的是語音辨識那一批。語音轉文字很適合放在本機做:會議錄音、客服錄音這類資料不太想上傳雲端。Qwen3 ASR 加上強制對齊,還能幫逐字稿標時間點,做字幕很方便。
不過我會提醒:這類函式庫的大版本之間常有行為變動,尤其是 Gemma 3/4 那條會影響輸出結果。如果你有已經調好的本地流程,先在獨立環境測試,確認輸出沒有走樣,再升級正式環境。
名詞小辭典
- ASR:自動語音辨識,把人說的話轉成文字。
- MoE(混合專家):模型裡有很多「專家」,每次只叫其中幾個出力,省算力。
- ONNX / ExecuTorch:讓模型能在不同硬體與手機上執行的通用格式與執行環境。
- prefill / decode:生成文字的兩個階段,前者讀完整個提示詞,後者一個字一個字產生答案。