觀點 · 資訊分享
DeepSeek 開放會看圖的 V4 Flash 實驗版權重:MIT 授權,官方範例要 4 張 GB300 才跑得動
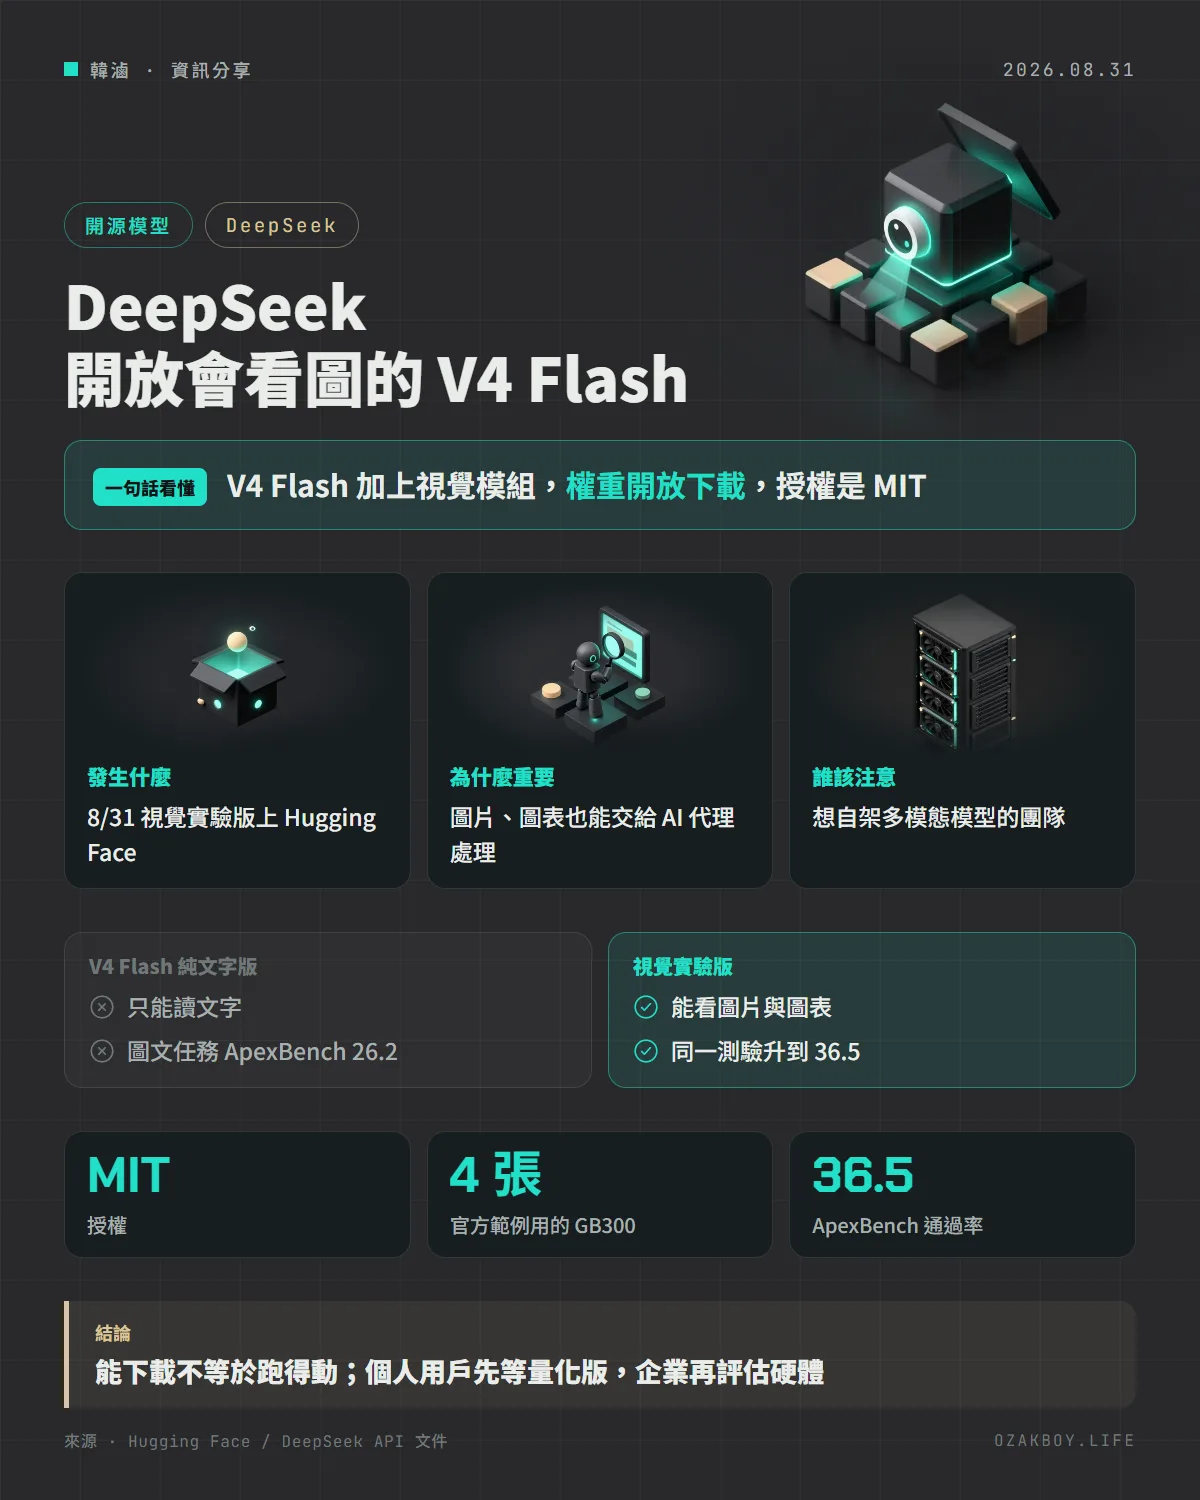
DeepSeek 在 8 月 31 日把 V4 Flash 的視覺實驗版放上 Hugging Face,採 MIT 授權。官方公布的圖文任務分數比純文字版高,但官方範例得用 4 張 GB300 的單機節點,一般人只能先看看。
- 發布
- 2026-08-31
- 篇幅
- 約 4 分鐘 · 1,683 字
- 結構
- 6 節 + 4 題常見問題
- 標籤
一句話看懂:DeepSeek 把 V4 Flash 加上視覺能力的實驗版放上 Hugging Face,授權是 MIT;它看得懂圖片與圖表,但官方範例要 4 張 GB300 才跑得動。
先用白話講:多模態模型是什麼?
想像一位很會讀書、寫程式的助理,但他只能讀文字。你給他一張圖表,他看不懂;給他截圖,他也沒辦法。多模態模型就是幫這位助理配上一雙眼睛:除了文字,還能看懂圖片、圖表和畫面。
DeepSeek 這次放出的 DeepSeek-V4-Flash-Vision-Exp,是在原本的 V4 Flash 上加入視覺模組、再繼續訓練出來的。名字最後的 Exp 是 Experimental(實驗性)的意思,官方也說這是 V4 家族第一個多模態實驗模型。
發生什麼事
- 8 月 31 日:模型權重放上 Hugging Face,授權標示為 MIT
- API 先行:DeepSeek 的 API 更新日誌顯示,這個模型在 8 月 21 日就已經在 API 平台提供,這次是把權重也開放下載
- 官方表格:跟純文字的 V4-Flash-0731 比,在圖文任務上進步明顯,純文字任務則維持相近
| 測驗 | 視覺實驗版 | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| ApexBench(圖文) | 36.5 | 26.2 | 39.4 |
| Agents’ Last Exam | 27.3 | 25.2 | 25.7 |
| Chartography(圖表) | 64.3 | 無 | 65.0 |
| ZeroBench | 35.0 | 無 | 34.0 |
| Terminal Bench 2.1(純文字) | 83.9 | 82.7 | 85.0 |
要冷靜看:這些是 DeepSeek 自己公布的分數。模型卡註明,V4-Flash-0731 在圖文測驗中會直接忽略圖片,所以那兩格的比較本來就不對等,只能看出「有眼睛比沒眼睛好」。
給開發者的技術細節
模型卡的內容:
- 儲存庫含分詞器、提示詞格式轉換範例,以及最小版的 PyTorch 推論程式
- 輸入支援 OpenAI 風格的訊息格式
- 官方 vLLM 範例是在「單機 4 張 GB300」的環境服務,要用到 FP8 的 KV 快取與 tensor parallel 設定
- SGLang 也有支援,需要開啟 DSPARK 這種推測解碼設定
這代表它主要面向資料中心等級的硬體。Hugging Face 上已經能找到社群上傳的 GGUF 量化版,但能不能在家用機器跑、需要多少記憶體,我沒有實測,要自己查模型頁的說明。
後續(9 月 10 日):DeepSeek 在更新日誌宣布 V4.1 Flash,原生支援多模態;API 上的 V4 Flash 與視覺實驗版同時退役,舊的模型名稱暫時導向 V4.1 Flash。
我的看法
我自己用本地 AI 的情況,大多是 Ollama 或 ComfyUI 跑在家裡的機器上,這類權重不是我這種硬體跑得動的。所以它的價值對我來說,更多是「看廠商把視覺能力補到什麼程度」,而不是真的下載來用。
對一般接案或小團隊,我的建議是:要用 AI 看截圖、看報表,先用 API 或雲端服務就好,別為了「能下載」去買 GPU。等到有人把量化版調好、也有人實測過品質,再評估自架划不划算。實驗版這種東西,廠商自己都可能很快換掉(上面後續就是例子)。
名詞小辭典
- 多模態(Multimodal):模型能處理文字以外的資料,例如圖片、聲音。
- 權重(Weights):模型訓練完之後的「腦袋內容」,下載後就能自己部署。
- MIT 授權:很寬鬆的開源授權,使用與修改的限制很少。
- GGUF:一種方便在個人電腦上執行大型模型的檔案格式,通常會經過壓縮量化。