觀點 · 資訊分享
DeepSeek V4.1 Flash 小改版開源:Terminal-Bench 從 31.2 跳到 42.3,輸出還變短
DeepSeek 推出 V4.1-Flash-1017,以 MIT 授權開放權重,多項跑分提升、完成任務更快、輸出更短。API 名稱 deepseek-flash 已指向新版,離峰時段每百萬輸出 token 只要 0.6 美元。
- 發布
- 2026-10-18
- 篇幅
- 約 4 分鐘 · 1,910 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
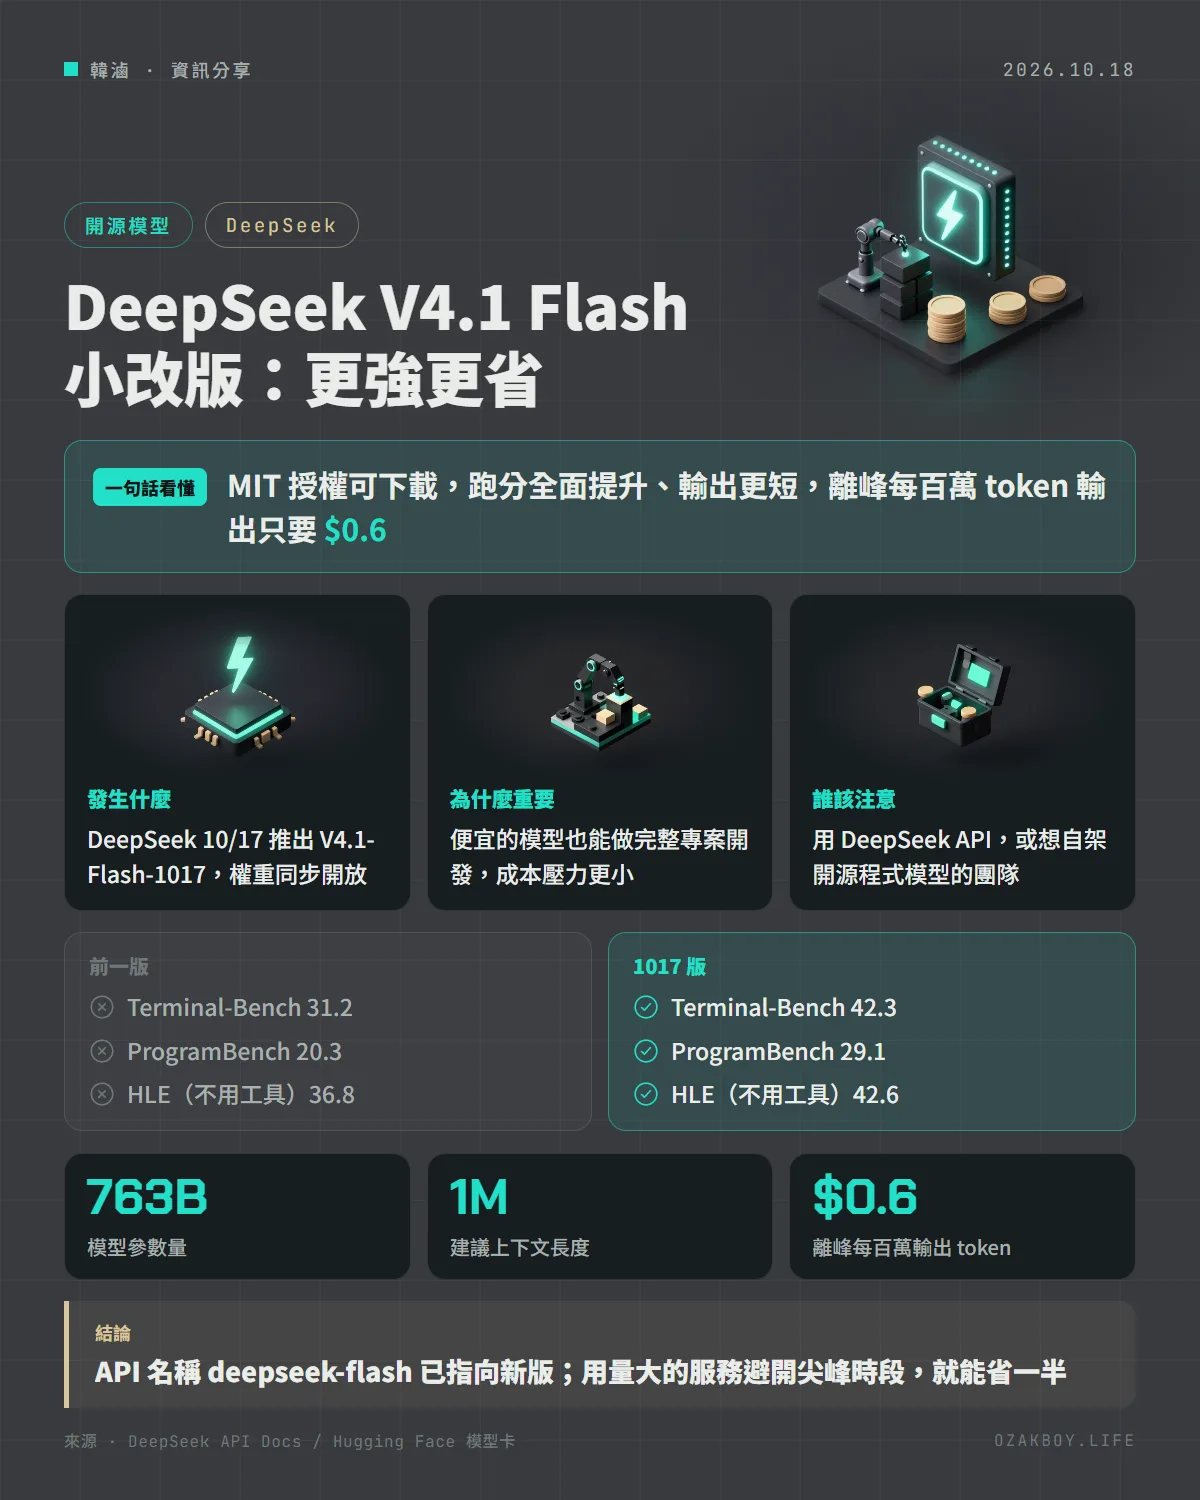
一句話看懂:DeepSeek 推出 V4.1 Flash 的小改版並開放權重,寫程式與代理任務的分數明顯進步、輸出還變短,API 價格維持便宜,離峰時段再打對折。
先用白話講:「小改版」為什麼值得注意?
想像你常去的便當店沒有漲價,也沒換招牌,只是默默換了一位更厲害的廚師:菜更好吃、出餐更快、份量剛剛好不浪費。你不用改點餐習慣,吃到的東西卻變好了。
DeepSeek 這次的 V4.1-Flash-1017 就是這種改版。名字後面的 1017 代表 10 月 17 日的版本,API 呼叫的名稱不變,背後的模型卻已經換成新的。而且它是開源的,任何人都能下載權重。
發生什麼事
DeepSeek 在 10 月 17 日發布 DeepSeek-V4.1-Flash-1017,網站、App、API 同步上線:
- 更強更省:官方說跑分更高、完成任務更快、輸出更短
- 訓練方式:用帶自我回饋的強化學習,加強端到端的專案開發能力,官方示範了 3D 建模、網頁賽車遊戲等例子
- 開放權重:Hugging Face 與 ModelScope 都能下載,MIT 授權
- 規格:模型卡列出 763B 參數;建議上下文 1M token、最大輸出至少 256K
- 搭配工具:針對 DeepSeek Harness、騰訊 CodeBuddy、WorkBuddy 等最佳化
跑分進步多少?
以下來自官方模型卡,與前一版 V4.1-Flash 比較:
| 測驗 | 前一版 | 1017 版 |
|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 |
| ProgramBench | 20.3 | 29.1 |
| HLE(不用工具) | 36.8 | 42.6 |
| DeepSWE v1.1 | 74.2 | 77.0 |
| Apex Bench v1.1 | 64.6 | 72.1 |
| BabyVision(用工具) | 89.6 | 92.5 |
給開發者的技術細節
API 價格(每百萬 token,美元):
| 計費類型 | 離峰 | 尖峰 |
|---|---|---|
| 輸入(命中快取) | 0.003 | 0.006 |
| 輸入(未命中) | 0.15 | 0.3 |
| 輸出 | 0.6 | 1.2 |
- 尖峰時段:週一到週五 UTC 01:00–04:00 與 06:00–10:00,中國國定假日除外;換算台灣時間是 9–12 點與 14–18 點(自行換算,台灣為 UTC+8)
- 模型名稱:
deepseek-flash已指向新版;舊名deepseek-v4-flash、deepseek-v4-flash-vision-exp也改由新版提供、按 Flash 價計費 - 上限:價格頁列出上下文 1M、最大輸出 384K、並行上限 2,500
- Search 與 Fetch API:各為每千次成功請求 0.75 美元;透過 DeepSeek Harness、Claude Code、Codex 的伺服器端呼叫,北京時間(同台灣時間)11 月 1 日 0 點前免費
- 自架:提供 vLLM、SGLang、Transformers 部署說明;沒有 Jinja 格式的對話範本,改附一份
encoding.py參考實作
我的看法
DeepSeek 一直是「便宜又夠用」的代表,這次的重點是 Terminal-Bench 這類代理任務進步很多,代表拿它來跑自動化的寫程式流程更可行了。對預算有限的小團隊,先用它做大量的初步處理,再把關鍵步驟交給更貴的模型,是很實際的組合。
但有兩點要注意:第一,舊的模型名稱背後已經換成新版,如果你的產品依賴特定的輸出格式,最好重新跑一次測試;第二,尖峰時段剛好落在台灣的上班時間,價格是兩倍,排程類的批次工作可以考慮挪到晚上或週末。
名詞小辭典
- 開放權重 / 開源:公開模型檔案讓人下載使用,這次用的是限制很少的 MIT 授權。
- 強化學習(RL):讓模型反覆嘗試、依結果給獎勵來學習的訓練方式。
- 快取命中(Cache Hit):送出的內容跟之前一樣,服務直接沿用處理結果,所以便宜很多。
- Benchmark(跑分測驗):用固定題目比較模型能力的標準測驗,例如 Terminal-Bench 測的是在終端機完成任務的能力。
資料來源
常見問題
我原本用 deepseek-v4-flash 這個名稱,要改程式嗎?
不一定要改。官方價格頁寫明 deepseek-v4-flash 與 deepseek-v4-flash-vision-exp 這兩個舊名稱現在也由 V4.1-Flash-1017 提供服務,按 Flash 價格計費。但背後模型換了,建議重新測一次輸出品質。
尖峰時段是什麼時候?
官方定義是週一到週五 UTC 01:00–04:00 與 06:00–10:00(中國國定假日除外)。換算成台灣時間是週一到週五 9 點到 12 點、14 點到 18 點(自行換算,台灣為 UTC+8)。其他時間與週末都算離峰,價格是尖峰的一半。
可以在自己的電腦跑嗎?
模型卡列出的參數量是 763B,一般電腦跑不動。官方提供 vLLM、SGLang、Transformers 的部署說明,社群也有 llama.cpp、Ollama、LM Studio 可用的量化版本,但仍需要很大的記憶體。
Search 和 Fetch API 怎麼收費?
各為每千次成功請求 0.75 美元。透過 DeepSeek Harness、Claude Code、Codex 的伺服器端工具呼叫,目前免費,北京時間(也就是台灣時間)2026 年 11 月 1 日 0 點起開始計費。
接著讀
全部觀點 →Claude Opus 5.5 快速模式免申請開放:輸出最快 2.5 倍,價格是一般的 2 倍Anthropic 讓 Claude Opus 5.5 的快速模式結束研究預覽,不用申請、不用 beta 標頭,加一個參數就能讓輸出速度最高變 2.5 倍,價格則是一般模式的 2 倍。閱讀 →德國 Aleph Alpha 開源 Kolibri:78B 參數只動 3.5B,Apache 2.0 授權、最長 100 萬 token德國 AI 公司 Aleph Alpha 釋出開放權重模型 Kolibri,總共 780 億參數,但每個 token 只動用約 35 億,採 Apache 2.0 授權。它主打英文與德文,訓練到 25.6 萬 token 上下文,調整設定後可延伸到 100 萬。閱讀 →Cloudflare 開源 Clef 決策模型:不寫文章只回機率,9B 版本中位數延遲 38 毫秒Cloudflare 推出第一批自己訓練的開源模型 Clef 與 Clef-flash。它們不產生文字,而是針對你給的問題直接回答「是的機率多少」「選哪個選項」,適合分類工單、擋不該做的動作。權重以 Apache 2.0 釋出,也能在本機跑。閱讀 →