觀點 · 資訊分享
Claude Opus 5.5 快速模式免申請開放:輸出最快 2.5 倍,價格是一般的 2 倍
Anthropic 讓 Claude Opus 5.5 的快速模式結束研究預覽,不用申請、不用 beta 標頭,加一個參數就能讓輸出速度最高變 2.5 倍,價格則是一般模式的 2 倍。
- 發布
- 2026-10-15
- 篇幅
- 約 4 分鐘 · 1,653 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
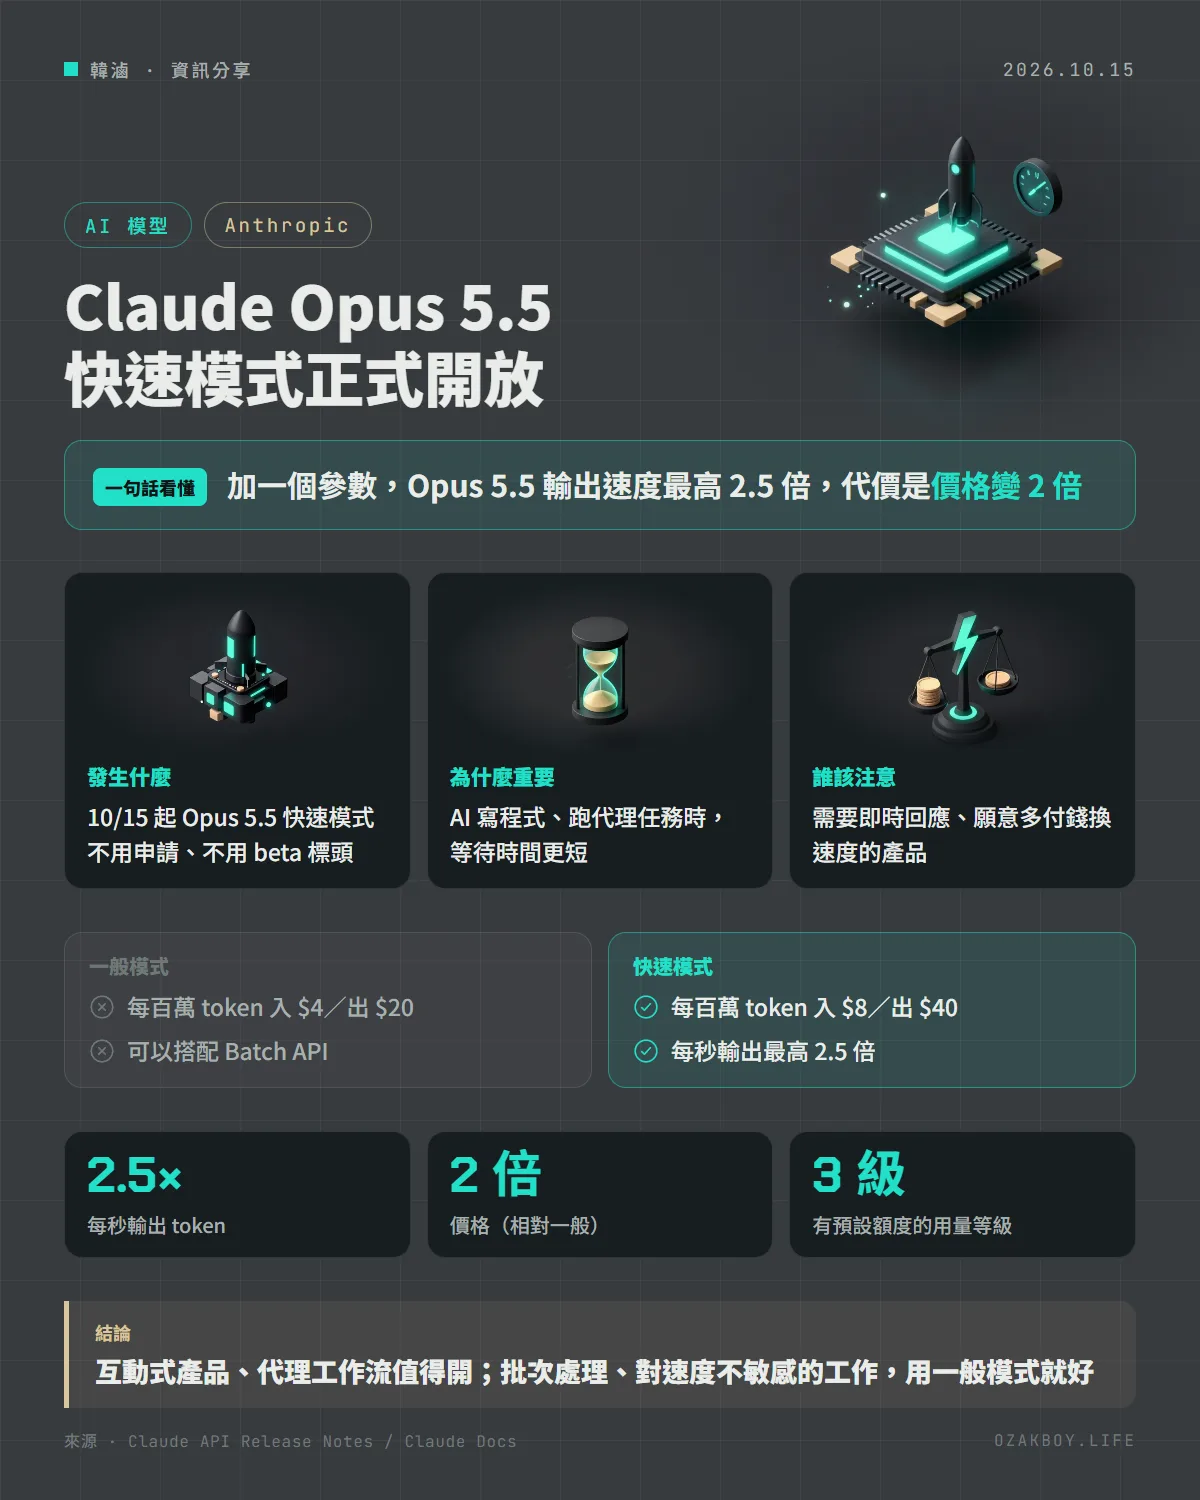
一句話看懂:Claude Opus 5.5 的快速模式不用申請就能用了,加一個參數,AI 吐字速度最高變成 2.5 倍,但每個 token 的價格也變成 2 倍。
先用白話講:快速模式是什麼?
想像你叫了一份外送,同一家店、同一位廚師、同一道菜,但可以選「一般配送」或「加價快送」。菜的味道一模一樣,差別只在送到你手上的速度,以及你多付了多少運費。
Claude 的快速模式就是 AI 的加價快送。模型本身沒有換,聰明程度也沒變,只是 Anthropic 用更快的方式跑它,讓答案一個字一個字冒出來的速度變快。
以前這個選項要排隊申請,現在 Opus 5.5 直接開放。
發生什麼事
Anthropic 在 10 月 15 日的 Claude 平台更新日誌宣布:
- 結束研究預覽:Opus 5.5 的快速模式不必申請,也不用再帶
fast-mode-2026-02-01beta 標頭;舊程式還帶著也照常能用 - 預設有額度:Start、Build、Scale 三個用量等級都有預設的快速模式速率上限
- Azure 也能用:Microsoft Foundry 上由 Azure 託管的部署同步支援
- 舊模型不變:Opus 5 與 Opus 4.8 的快速模式仍是研究預覽,還是要帶 beta 標頭
多付的錢值不值得?
| 比較 | Opus 5.5 一般 | Opus 5.5 快速 |
|---|---|---|
| 輸入(每百萬 token) | 4 美元 | 8 美元 |
| 輸出(每百萬 token) | 20 美元 | 40 美元 |
| 每秒輸出速度 | 1 倍 | 最高 2.5 倍 |
| Batch API | 可用 | 不可用 |
價格是整個 context 視窗都適用的倍率,連超過 20 萬輸入 token 的請求也一樣;提示快取與資料落地的倍率會再疊加上去。
簡單說:速度最多快 2.5 倍,價格固定貴 2 倍。使用者正盯著畫面等結果的情境(例如程式助手、客服對話)比較划算;半夜跑的批次工作,多付錢沒什麼意義。
給開發者的技術細節
啟用方式是在 Messages API 的請求加上 speed:
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    speed="fast",
    messages=[{"role": "user", "content": "幫我重構這個模組"}],
)
print(response.usage.speed)  # "fast" 或 "standard"
- 加速的是每秒輸出量,不是第一個字出現前的等待時間,搭配串流最有感
- 獨立的速率上限:超過時回
429並附retry-after,回應標頭有anthropic-fast-*系列可以看剩餘額度 - 退回一般速度:可以接住 429 後拿掉
speed重送,但兩種速度不共用提示快取,退回時快取會失效 - 不支援:Batch API、Priority Tier;Claude Platform on AWS 與其他合作雲端平台也不提供
我的看法
我自己用 AI 寫程式時,最常卡住的不是 AI 不夠聰明,而是等它把一大段程式碼慢慢吐完。快速模式解決的正是這段等待,對互動式工具很有吸引力。
但幫客戶做產品時要算清楚:價格直接翻倍,而且是每一次請求都翻倍。我的建議是只在「使用者正在等」的路徑開快速模式,背景摘要、排程分析這類工作維持一般速度。另外要記得寫好退回邏輯:額度用完時自動改用一般速度,不要讓整個功能因為 429 直接壞掉。
名詞小辭典
- Token:AI 計算文字量的單位,API 依 token 數量收費。
- 研究預覽(Research Preview):功能還在試驗階段,只開放給申請通過的使用者,規格可能還會變。
- 速率上限(Rate Limit):每分鐘最多能送多少請求或 token,超過會被暫時擋下。
- 串流(Streaming):AI 一邊產生答案一邊傳回來,畫面上會看到字一個一個出現。