觀點 · 資訊分享
德國 Aleph Alpha 開源 Kolibri:78B 參數只動 3.5B,Apache 2.0 授權、最長 100 萬 token
德國 AI 公司 Aleph Alpha 釋出開放權重模型 Kolibri,總共 780 億參數,但每個 token 只動用約 35 億,採 Apache 2.0 授權。它主打英文與德文,訓練到 25.6 萬 token 上下文,調整設定後可延伸到 100 萬。
- 發布
- 2026-10-04
- 篇幅
- 約 4 分鐘 · 1,679 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
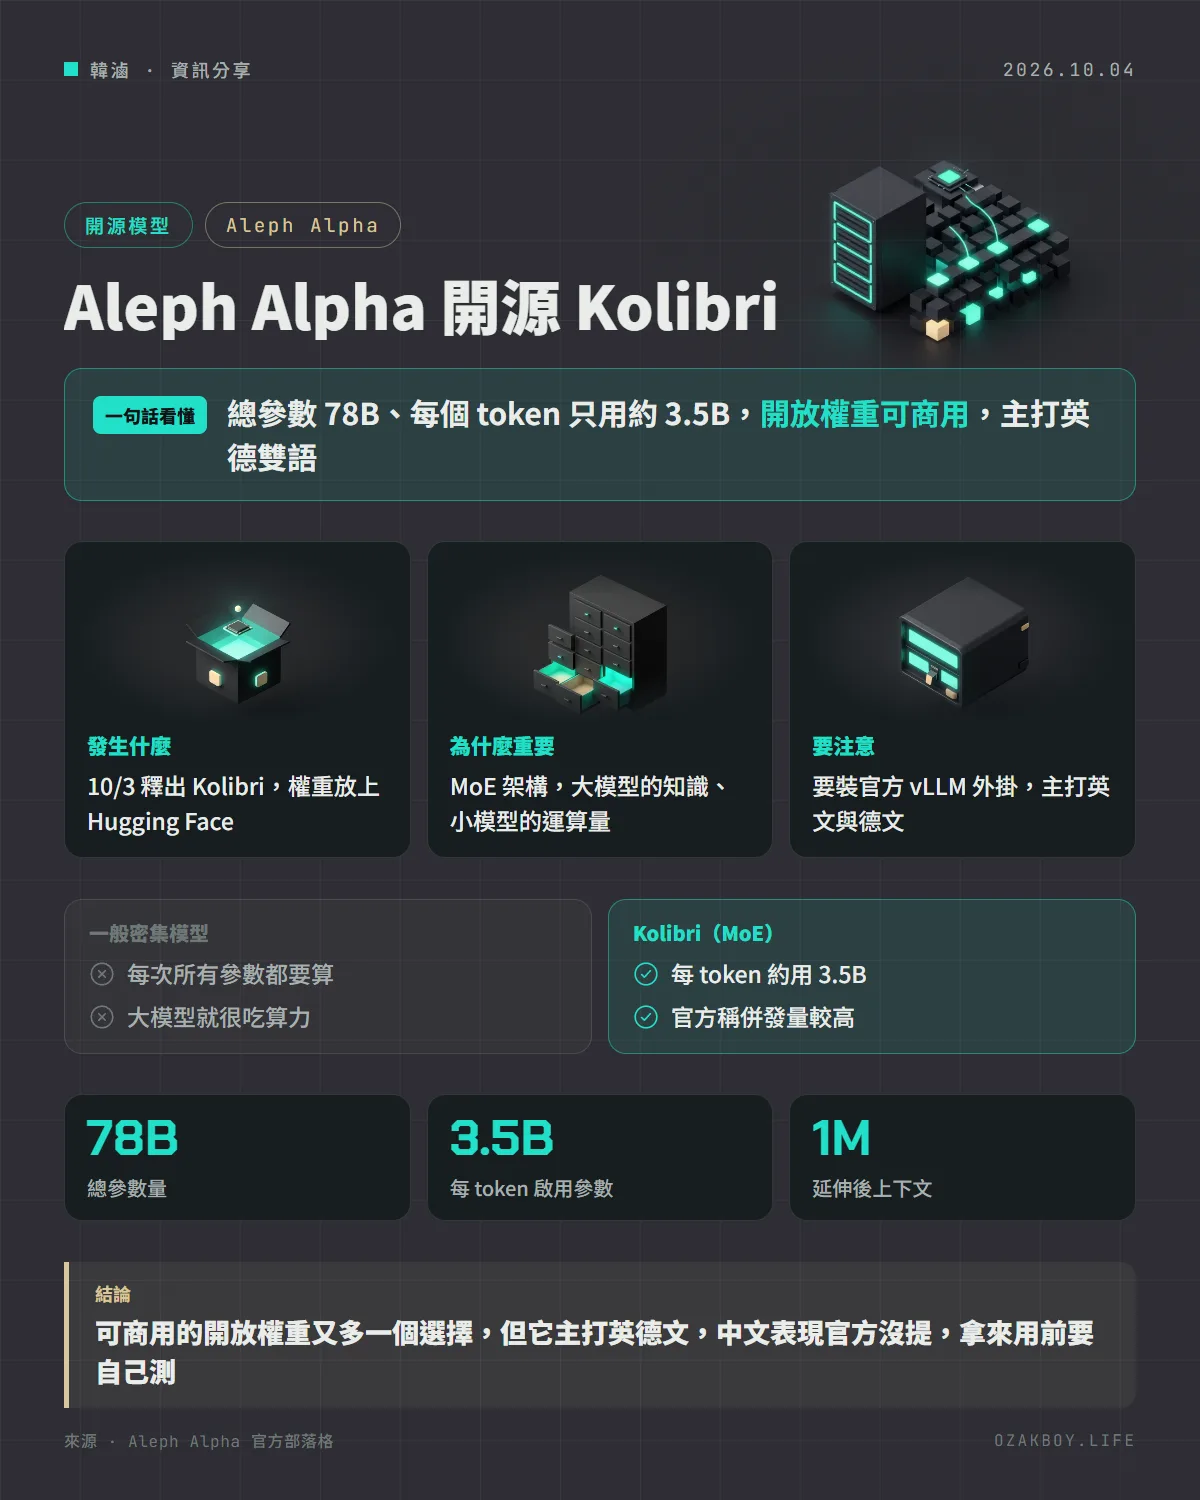
一句話看懂:德國 Aleph Alpha 開源 Kolibri,總參數 78B、每個 token 只用約 3.5B,Apache 2.0 授權可商用,主打英文與德文。
先用白話講:MoE 模型是什麼?
想像一間有 100 位專家的顧問公司。客人來問稅務問題,櫃台只會請兩、三位稅務專家出來回答,其他人繼續休息。公司整體很有學問,但每次接案只動用少數人,所以成本不高。
MoE(混合專家)模型就是這樣運作:模型裡有很多「專家」子網路,每處理一個 token,只挑少數幾個來算。Kolibri 總共有 780 億參數(78B),但每個 token 只動用約 35 億(3.5B),等於用小模型的運算量,換取大模型的知識量。
發生什麼事
德國 AI 公司 Aleph Alpha 在 10 月 3 日釋出 Kolibri:
- 授權:Apache 2.0,完整權重放在 Hugging Face(Aleph-Alpha/Kolibri-1)
- 架構:英德雙語的 MoE Transformer,總參數 78B、每 token 約 3.46B
- 語言:英文與德文,預訓練資料約 21.3% 是德文
- 訓練量:預訓練 20T token,加上後續階段約 24T token
- 上下文:訓練到 256K token,加上設定覆寫可延伸到 1M token
- 推理強度:none、low、medium、high 四段
- 知識截止:2026 年 6 月 18 日
跑分怎麼看
以下是官方自測結果(對照組分數也是官方頁面列出的):
| 測試 | Kolibri | Qwen3.6-35B-A3B |
|---|---|---|
| AIME 2025(數學) | 96.9 | 84.6 |
| GPQA Diamond(英文) | 84.3 | 83.4 |
| LiveCodeBench v6(程式) | 85.9 | 82.5 |
| LongBench Pro(長文) | 64.5 | 70.8 |
從官方表格也看得到,它在長文理解等測試落後部分對手。另外,在兩張 H100 的服務測試中,官方表示 78B 的 Kolibri 能同時處理比 123B 模型更多的請求。
給開發者的技術細節
Kolibri 不是下載下來就能用一般工具直接跑,需要官方的 vLLM 外掛:
pip install "aleph-alpha-inference>=1.0"
- 也可以用官方容器
ghcr.io/aleph-alpha/aleph-alpha-inference - 啟動時要開推理與工具呼叫解析器:
--reasoning-parser kolibri1、--tool-call-parser kolibri1、--enable-auto-tool-choice - 超過 262,144 token 的上下文,要加
--max-model-len 1048576並覆寫max_position_embeddings - 官方建議取樣參數:temperature 1.0、top_p 0.97、top_k 128
我的看法
Apache 2.0 授權、可商用的開放權重模型又多了一個,對想自架 AI 的團隊是好事。MoE 架構每次運算量小,同樣的伺服器能服務更多人,這點對成本很有幫助。
但老實說,它對台灣使用者的吸引力有限:主打英德雙語,中文表現官方完全沒提;部署又要裝官方專屬的 vLLM 外掛,門檻比一鍵安裝的工具高。78B 的權重還是要整份載入記憶體,家用 NAS 或一般顯示卡應該很難跑得動(推測,官方沒寫硬體需求)。我會把它當成「歐洲主權 AI」的代表觀察,真的要用在中文案子,還是先找有公布中文測試結果的模型,再拿自己的資料比較。
名詞小辭典
- 開放權重(Open Weight):公開模型訓練好的參數檔,任何人都能下載部署。
- MoE(混合專家):模型內有多個專家子網路,每次只啟用一部分,以降低運算量。
- vLLM:一套常用的開源推論引擎,專門讓大型語言模型跑得更快、同時服務更多請求。
- 上下文(Context):模型一次能讀進來的文字量,用 token 計算。