觀點 · 資訊分享
Meta 開放 816B 參數的 Muse Spark Open:兩台 Mac Studio 跑得動,但綜合指標仍不及中國開源模型
Meta 釋出開放權重模型 Muse Spark Open,總參數 816B、每次啟用 42B、支援 100 萬 token 上下文與圖片影音輸入。官方示範用兩台 Mac Studio 執行,商用要標示來源,大型 API 業者另有營收門檻。
- 發布
- 2026-10-16
- 篇幅
- 約 4 分鐘 · 2,002 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
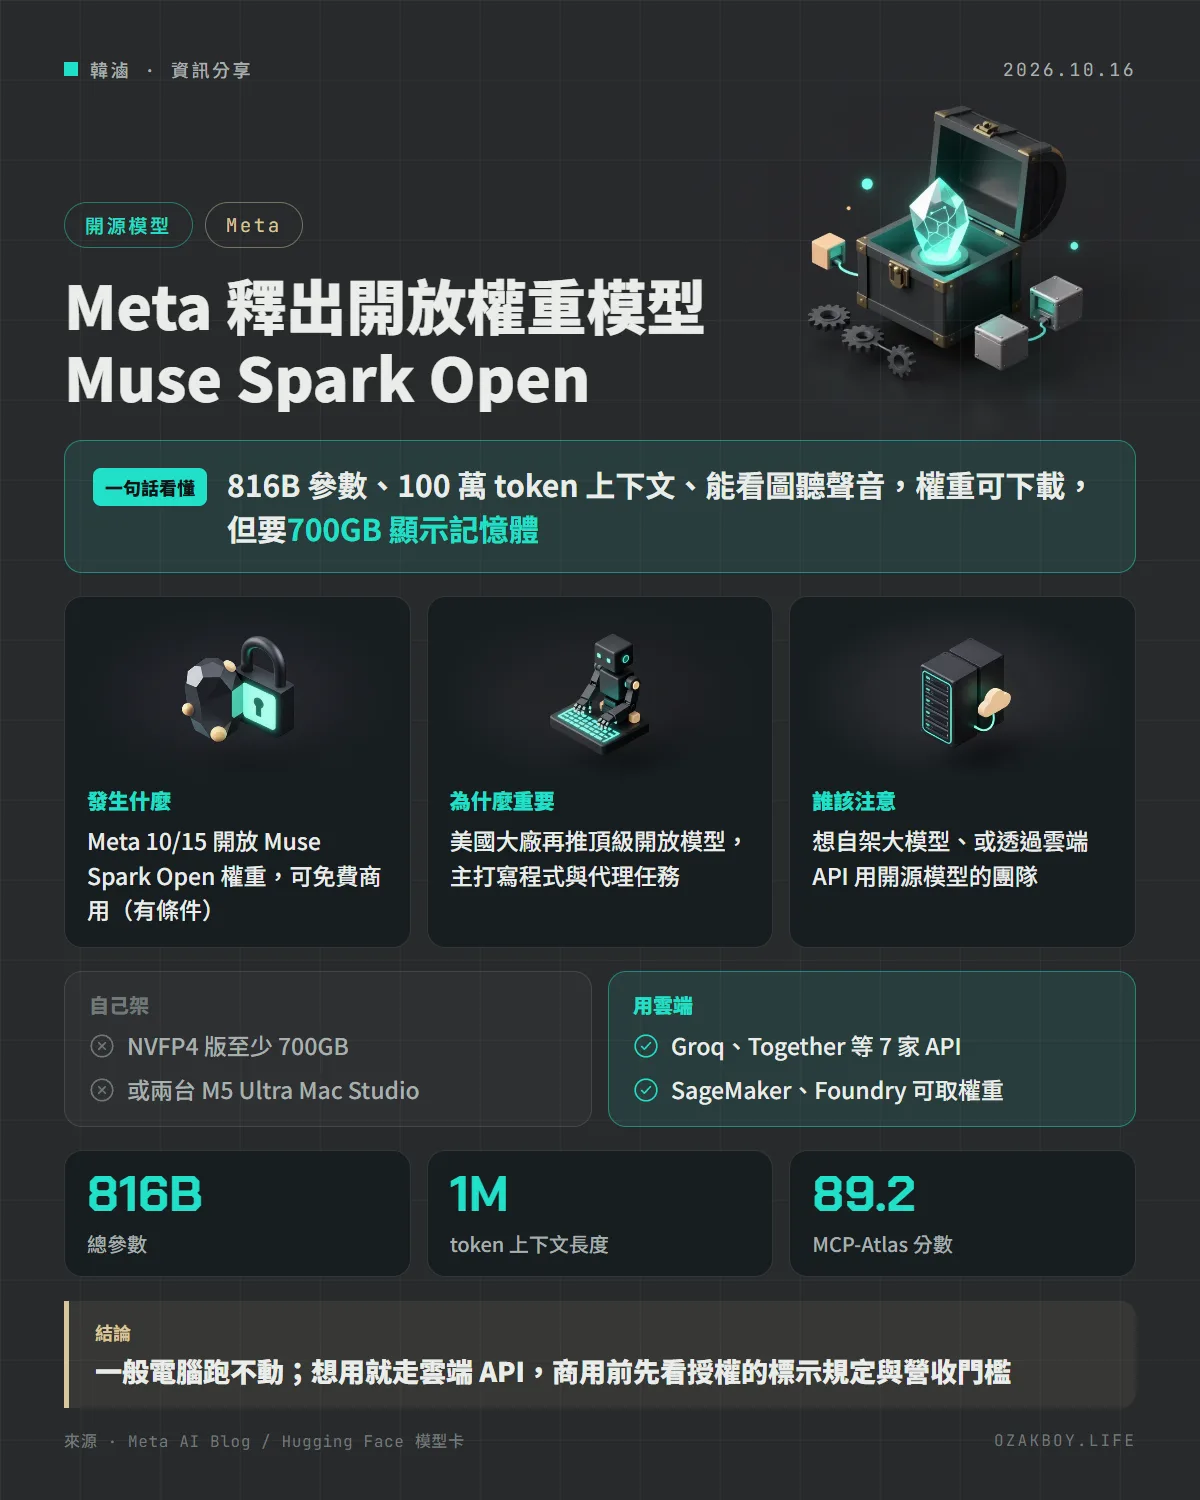
一句話看懂:Meta 釋出可以下載權重的大模型 Muse Spark Open,總參數 816B、支援 100 萬 token 上下文,官方說兩台 Mac Studio 就能跑,但對一般人來說,用雲端 API 還是比較實際。
先用白話講:開放權重模型是什麼?
想像一家知名餐廳把招牌菜的「完整配方」公開,你可以在自家廚房照做、改良,甚至拿去開店賣,只要遵守餐廳定的幾條規矩。這就是開放權重模型:AI 公司把訓練好的模型檔案(權重)公開,任何人都能下載到自己的機器上執行。
相對的,ChatGPT 這類封閉模型只能透過對方的網站或 API 使用,配方永遠鎖在對方廚房裡。
這次 Meta 公開的配方非常大,大到一般家用廚房根本放不下。
發生什麼事
Meta 在 10 月 15 日釋出 Muse Spark Open,重點如下:
- 規模:總參數 816B,每個 token 只啟用其中 42B,是 MoE(混合專家)架構,共 256 個專家、每次選 8 個
- 上下文:100 萬 token
- 多模態:可以輸入文字、圖片、影片、音訊,輸出文字
- 定位:官方說它是目前最強的美國開放權重模型,主打寫程式、長時間的代理任務與多步驟推理
- 硬體:NVFP4 版至少要 700GB 顯示記憶體,BF16 版要 2TB;官方示範用兩台 M5 Ultra Mac Studio 搭配 MLX 執行
- 授權:Muse Model License,產品要標示「Built with Muse Spark Open」
跟其他開源模型比起來如何?
以下數字都來自 Meta 自己的模型卡:
| 測驗 | Muse Spark Open | Qwen3.8-2.4T-A95B | GLM 5.3 | Kimi K3 |
|---|---|---|---|---|
| MCP-Atlas(工具使用) | 89.2 | 84.5 | 84.2 | 82.3 |
| Terminal-Bench 2.1 | 76.4 | 82.0 | 83.9 | 85.0 |
| GPQA Diamond | 89.0 | 93.5 | 91.7 | 93.5 |
| AA Intelligence Index | 39 | 40 | 45 | 44 |
它在工具使用、部分影像理解測驗領先,但在綜合指標和終端機程式任務上,仍落後幾個中國的開源模型。所以「最強的美國開放權重模型」這個說法要注意前面的國別限定。
給開發者的技術細節
- 推論框架:SGLang、vLLM、TensorRT-LLM、Transformers、MLX、llama.cpp、Unsloth;模型卡另列出 LM Studio、Jan、Ollama 的量化版本
- 雲端 API:Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AI
- 取得權重:Hugging Face、Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry;Hugging Face 要先登入並填寫含法定姓名的同意表單
- 推理強度:
reasoning_effort可設low、medium、high、xhigh,預設xhigh,其他值會報錯 - 建議參數:temperature 1.0、top_p 1.0、不使用 top_k
- 授權門檻:把模型當服務提供給第三方、且 12 個月營收超過 2,000 萬美元的業者,要先通知 Meta 並另簽協議
- 年齡:不適用於未滿 18 歲的使用者
我的看法
我平常在家用 Ollama 跑本地模型,看到「開放權重」第一個反應是能不能裝在自己的機器上。答案很直接:不行。700GB 的顯示記憶體遠超過任何家用顯示卡,就算是官方示範的兩台頂規 Mac Studio,也不是一般工作室會有的設備。
對小團隊比較有意義的是「選擇變多」:同一個模型有七家 API 供應商可以比價,將來不滿意也能換家,不會被單一廠商綁死。另外,如果你的產品會用到它,記得在介面或文件放上授權要求的標示,這種條款很容易被忽略,等到被追究才補就麻煩了。
名詞小辭典
- 開放權重(Open Weights):公開模型檔案,讓人可以下載到自己的機器執行,但不一定公開訓練資料與程式。
- MoE(混合專家):模型裡有很多個「專家」子網路,每次只叫用其中幾個,所以總參數很大、實際運算量比較小。
- 上下文長度(Context):模型一次能讀進去的文字量,100 萬 token 大約是好幾本書。
- 量化(NVFP4、BF16):用比較少的位元儲存模型數字,檔案變小、需要的記憶體變少,代價是可能損失一點精準度。