觀點 · 資訊分享
LocalAI 4.6.0:AMD 顯卡終於能全速跑,模型庫的 SSRF 漏洞也一併補上
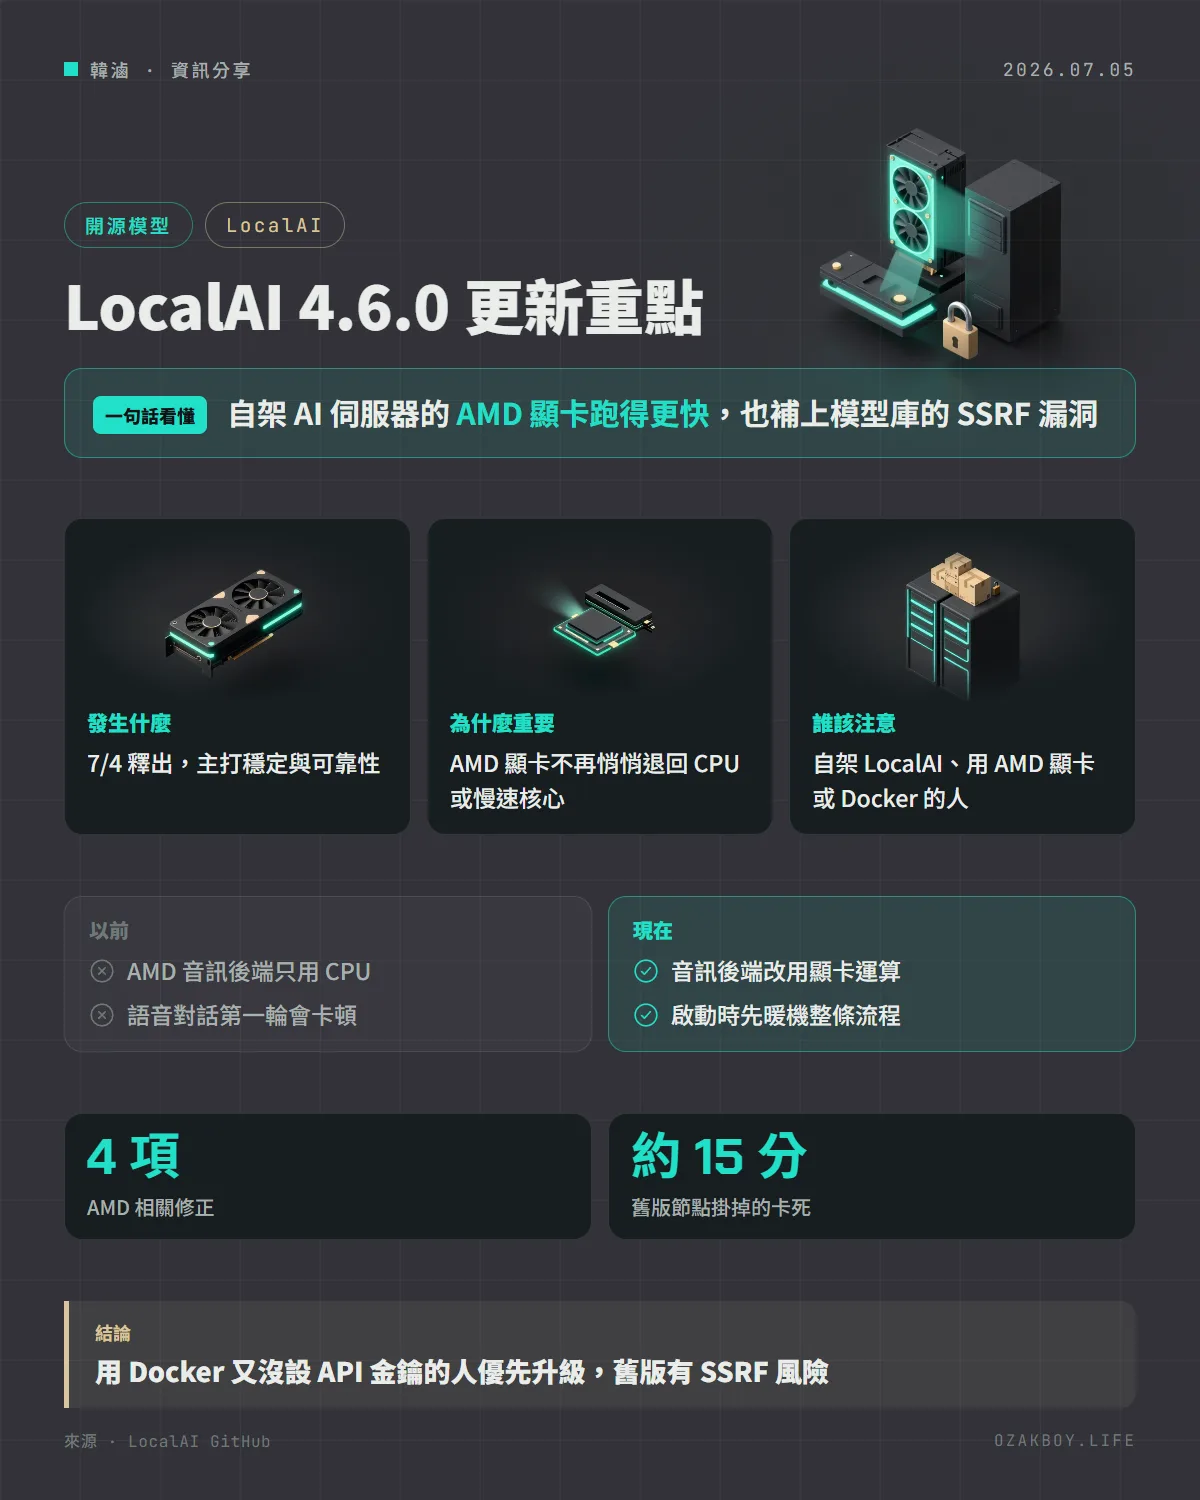
自架 AI 伺服器 LocalAI 在 7 月 4 日釋出 4.6.0,主打可靠性:修好 AMD ROCm 後端悄悄退回 CPU 的問題、語音對話啟動前先暖機、聊天介面能分岔對話,也補上 POST /models/apply 的 SSRF 漏洞。
- 發布
- 2026-07-05
- 篇幅
- 約 5 分鐘 · 2,130 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
一句話看懂:LocalAI 4.6.0 是以可靠性為主的版本:AMD 顯卡終於真的用上 GPU,語音對話啟動前先暖機,同時補上模型庫網址檢查的 SSRF 漏洞。
先用白話講:LocalAI 是什麼?
如果你的程式原本呼叫 OpenAI 的 API,想改成用自己電腦上的模型,最麻煩的是每個模型的呼叫方式都不一樣。LocalAI 的做法是:自己架一台長得像 OpenAI 的伺服器,背後接各種本地模型,讓原本的程式只要改網址就能用,語言模型、語音辨識、語音合成、圖片生成都能放在同一個地方。
這次的 4.6.0,官方自己定位成「可靠性為主」的版本,修的都是自架時最煩人的那類問題。
發生什麼事
依官方 GitHub 更新說明(2026 年 7 月 4 日),重點有六項:
- AMD ROCm 後端真的跑在顯卡上:四個一組的修正,讓 AMD 顯卡不再悄悄退回 CPU 或慢速的通用核心
- 即時語音啟動更可預測:語音對話一開始就把整條流程(語音活動偵測、語音辨識、語言模型、語音合成)一起暖機,第一輪不再因各模型冷啟動而卡頓,載入錯誤也會在一開始就顯示
- 聊天介面能分岔:可以重新產生任何一則回答(不只最後一則)、從任一回答分出新對話、複製對話,或整段複製成 Markdown
- 分散式部署更耐用:工作節點掛掉時,不再把模型載入鎖卡住約 15 分鐘;主程式被強制結束後,殘留的後端工作程序會自己結束,不再佔著顯示記憶體
- PII(個資)事件計數:個資偵測、遮罩、封鎖的事件會輸出成 Prometheus 計數器,可以設警報,發現過濾器停止運作
- 模型庫 SSRF 修正:見下節
AMD 顯卡到底修了什麼
| 問題 | 修正 |
|---|---|
| 部分 ggml 音訊後端編譯成只用 CPU(用了無效的編譯選項) | 改用正確選項並連結 HIP,真正使用顯卡運算 |
| 打包時漏掉 hipBLASLt 調校資料,所有架構都悄悄用慢速核心 | 資料改為一併打包,並設定對應環境變數 |
rocm-vllm 裝到只支援 CUDA 的安裝包,在 AMD 上直接報錯 |
固定使用 Python 3.12,從 ROCm 專用的安裝包來源安裝 vLLM |
| 運算專用映像缺少 ASIC 識別表,每次載入模型都警告 | 補上對應的檔案連結 |
給開發者的技術細節
這次安全修正的背景:POST /models/apply 在 id 留空時,會直接去抓你提供的 url。官方說明在預設 Docker 部署(沒設 API 金鑰)的情況下,任何連得到的使用者都能藉此探測內部服務或雲端中繼資料位址(169.254.169.254),並透過工作的錯誤訊息帶出一小段內容。
修正方式是讓設定網址的抓取,先通過既有的 ValidateExternalURL 檢查,擋下私有、本機(loopback)、連結本地、未指定與雲端中繼資料位址。只有一般的 http(s):// 網址會被驗證,huggingface://、github:、oci://、ollama://、file:// 這類網址不受影響。
其他你可能會用到的改動:
- 新增
POST /backend/load(與/v1/backend/load),可事先把指定模型載入記憶體;即時語音流程可用disable_warmup: true關閉暖機 POST /backends/apply與開機載入外部後端的流程,不再重複下載已安裝的後端,除非帶force: true- 連到最新推理模型的雲端代理,改為丟掉
temperature、top_p並傳max_completion_tokens,避免回 400 錯誤
後續:2026 年 7 月 7 日,GitHub Advisory Database 以 CVE-2026-59707 收錄這個 POST /models/apply 的 SSRF 問題,嚴重度為 Critical(CVSS 9.2)。
我的看法
自己在家或在 NAS 上架 LocalAI 的人,最該注意的是那個 SSRF。很多人為了方便會把服務直接開在內網,Docker 預設又沒設 API 金鑰,這時內網裡任何一台能連到它的機器,都能拿它當跳板去探別的服務。如果還沒升級,至少先設定 API 金鑰,並且不要把服務對外網開放。
另一點是 AMD 顯卡的修正:如果你以前覺得「LocalAI 在 AMD 上怎麼這麼慢」,有可能是悄悄退回 CPU 了,不是你的顯卡不行。升級後可以重新測一次速度。
名詞小辭典
- SSRF:攻擊者讓你的伺服器代替他去連指定網址,用來探測內網或雲端的敏感資訊。
- ROCm:AMD 顯卡做 AI 與高效能運算的軟體平台,地位類似 NVIDIA 的 CUDA。
- 暖機(Warm-up):事先把模型載入記憶體,避免第一次使用時卡頓。
- Prometheus:常見的監控系統,用計數器與警報追蹤服務狀況。