觀點 · 資訊分享
vLLM 公開 cache_salt 漏洞:塞一個超長字串,就能讓 AI 推論伺服器卡住所有人
自架 AI 模型常用的推論引擎 vLLM,在 9 月 12 日公開一則安全公告:請求裡的 cache_salt 欄位沒有長度上限,沒登入的人送出超大字串,就能拖慢排程、讓其他請求排隊。0.29.0 以上已修正。
- 發布
- 2026-09-13
- 篇幅
- 約 4 分鐘 · 2,015 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
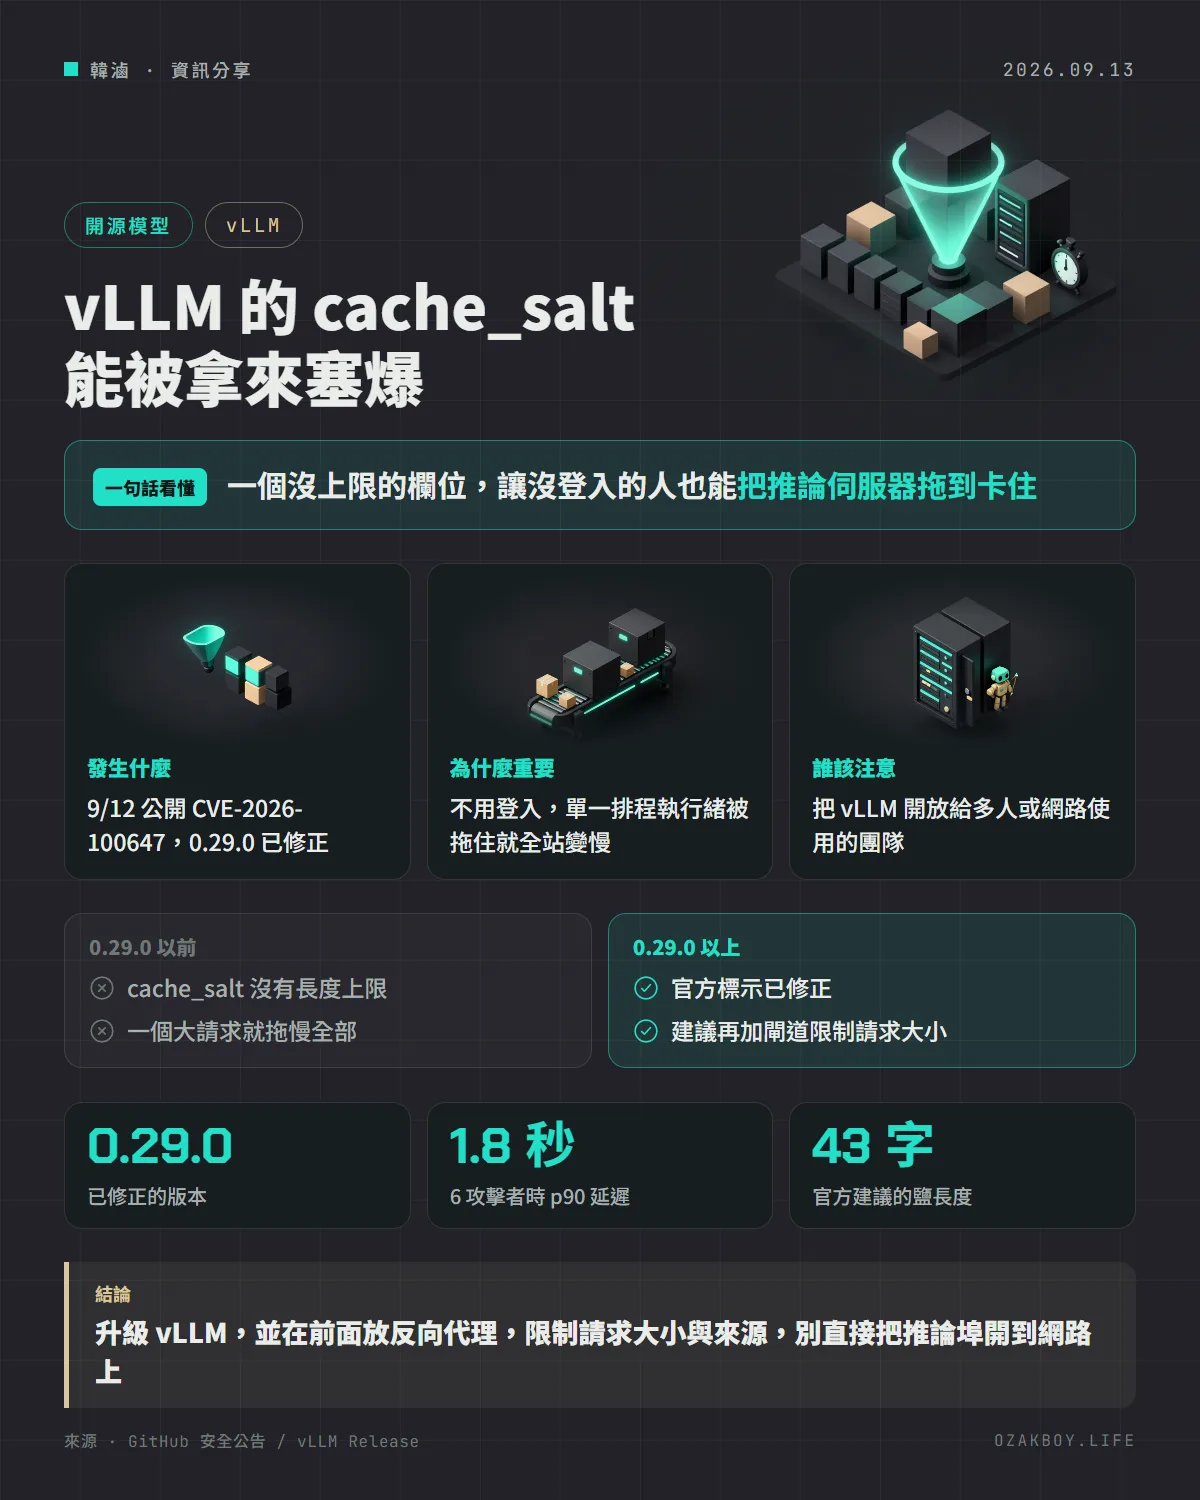
一句話看懂:自架 AI 常用的推論引擎 vLLM,有個請求欄位 cache_salt 沒有長度上限,沒登入的人送出超大字串,就能拖住唯一的排程執行緒,讓所有人的請求排隊;0.29.0 以上已修正。
先用白話講:為什麼一個欄位能卡死整台伺服器?
想像一間餐廳,只有一位櫃台人員負責把每張訂單唸給廚房。點餐單上有個「備註」欄,本來大家只會寫幾個字,例如「少冰」。但這個備註欄沒有字數限制,有人寫了一本小說,櫃台人員得從頭到尾唸完,才能輪到下一位客人。這段時間所有人都在排隊。
vLLM 是很多人拿來自架 AI 模型服務的推論引擎,這次出問題的就是這種「單一櫃台」設計:它的排程執行緒只有一條,而請求裡的 cache_salt 欄位正好會在這條執行緒上被處理。
發生什麼事
2026 年 9 月 12 日,vLLM 在 GitHub 公開安全公告(GHSA-wpww-v874-ph2p,CVE-2026-100647):
- 問題:
cache_salt欄位只檢查「至少 1 個字元」,沒有最大長度;OpenAI 相容的 chat completions、completions、responses、pooling 端點,以及 Anthropic 格式的/v1/messages都接受它 - 為什麼會慢:這個字串會被整段放進快取鍵,並在單一排程執行緒上做序列化與 SHA-256 雜湊,字串越大花的時間越多
- 不需要特別條件:不用登入,也不用開特殊功能;前綴快取預設就是開的,vLLM 也預設不限制 HTTP 請求本文大小
- 嚴重度:官方標為 medium(CVSS 5.3),影響是可用性(服務變慢或停擺),不是資料外洩
- 修正:升到 0.29.0 以上(0.29.0 在 9 月 9 日釋出)
實測有多慢?
下面是公告裡回報者的實測(2026-08-29,vllm 0.28.0 預設設定,RTX PRO 6000):
| 情境 | 結果 |
|---|---|
| 沒有 salt | 單次請求中位數約 9 毫秒 |
| 10 MB 的 salt | 約 58 毫秒 |
| 100 MB 的 salt | 約 599 毫秒 |
| 200 MB 的 salt | 約 1195 毫秒 |
| 6 個攻擊者各送 100 MB salt | 一般請求的 p90 約 1.8 秒(空閒時中位數約 8.5 毫秒) |
這是回報者自己的環境與方法,數字會因硬體而不同,但可以看出趨勢:字串越大,延遲幾乎成正比增加。
給開發者與維運的技術細節
- 先升級:vLLM 升到 0.29.0 以上
- 別把推論埠直接開到網路上:放一層反向代理(例如 nginx 或 API 閘道),設定請求本文大小上限、要求驗證、限制來源。公告提到 vLLM 預設沒有請求本文大小限制,這是我會優先補上的一層
- 多人共用的環境:官方建議
cache_salt是隨機、不被第三方取得的值,長度約 43 字元;自己的前端或閘道不要把使用者可任意控制的字串直接轉成cache_salt - 同一天還有 3 則公告:多模態聊天的音訊解碼忽略
VLLM_MAX_AUDIO_CLIP_FILESIZE_MB上限(CVSS 4.3,0.29.0 以上修正);取樣器子類別影響影片解碼限制與 GPU 記憶體計算(CVSS 3.7,0.29.0 以上修正);遠端媒體在檢查大小上限前就被完整載入(CVSS 6.5,公告標示的修正版本為高於 0.29.0) - 後續:之後 vLLM 在 9 月下旬到 10 月間,又陸續公開多則同類的拒絕服務與資源耗盡公告,若你長期自架,建議把安全公告納入定期檢查
我的看法
自架 AI 的人常有個盲點:以為「我的模型在家裡跑,沒人會打」。但 vLLM 這類服務一旦為了方便,開了 0.0.0.0 讓手機或同事連,或放到雲端主機上,就等於把一個沒有任何防護的 API 暴露出去。這則公告提醒的重點不是某個欄位,而是推論服務本身通常沒有內建的流量與大小保護。
我自己的做法是:推論服務只綁內網,對外一律經過反向代理,並加上驗證與請求大小限制。如果是接案給客戶用,這一層更不能省,不然哪天客戶的服務被一個大請求拖垮,是很難解釋的事。
名詞小辭典
- vLLM:高效能的開源推論引擎,用來把大型語言模型包成 API 服務。
- 前綴快取(prefix caching):把提示詞開頭相同的部分先算好存起來,之後重複使用,省時間也省算力。
- 拒絕服務(DoS):讓服務變慢或停擺,使正常使用者無法使用的攻擊。
- p90:把所有請求的延遲由小排到大,第 90% 位置的那一筆,用來看「大多數人最慢會等多久」。