觀點 · 資訊分享
vLLM 0.29 把新執行器 MRV2 設為所有模型的預設:舊版預計 0.32 移除,指令與預設值也有調整
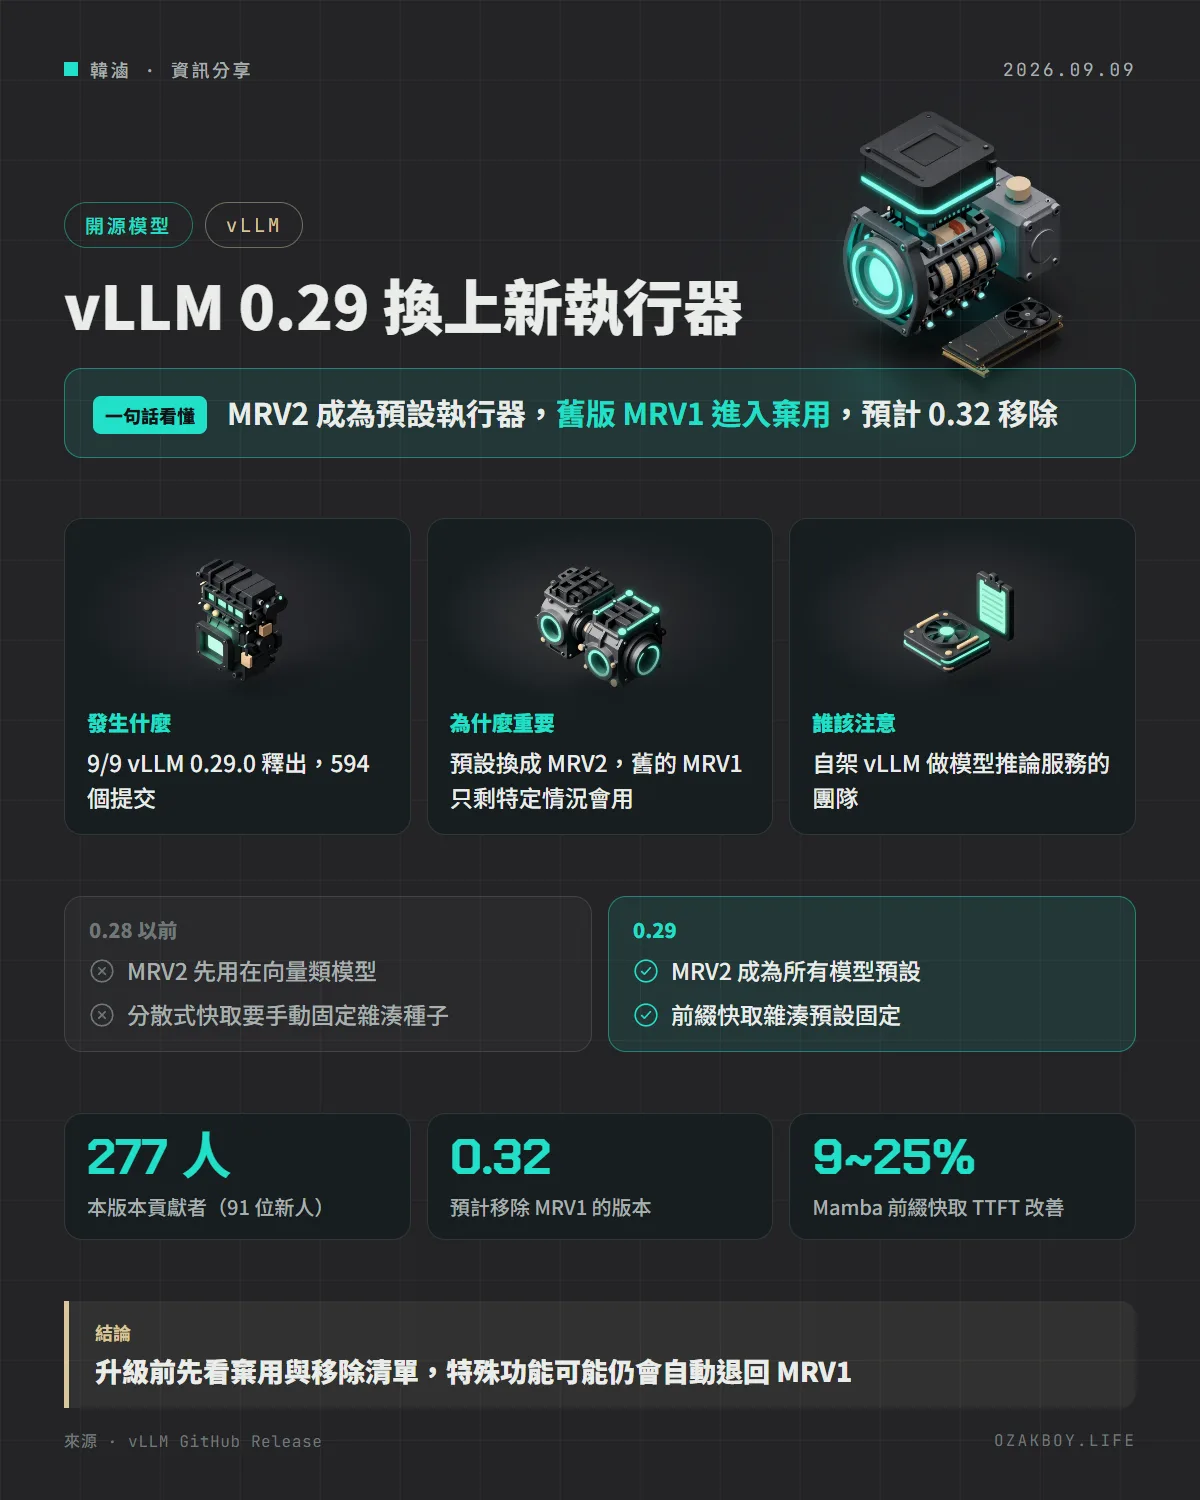
開源推論引擎 vLLM 發布 0.29.0:新一代執行器 Model Runner V2 成為所有模型的預設,舊版 MRV1 進入棄用、目標 0.32 移除。同時調整多項預設值,也有幾個指令與環境變數被移除。
- 發布
- 2026-09-09
- 篇幅
- 約 4 分鐘 · 1,889 字
- 結構
- 8 節 + 4 題常見問題
- 標籤
一句話看懂:開源推論引擎 vLLM 0.29 把新一代執行器 Model Runner V2 設為所有模型的預設,舊版 MRV1 進入棄用,預計 0.32 移除,升級前要先看有哪些預設值與指令變了。
先用白話講:vLLM 是什麼?
想像一間很熱門的餐廳,每天有上百位客人同時點餐。如果廚房每次只做一份,客人會等到天荒地老;高明的廚房會把訂單排好、同時開火,讓每個爐子都不閒著。
vLLM 就是 AI 模型的「高效廚房」:它是一個開源的推論引擎,把大型語言模型包成 API 服務,讓很多人可以同時使用,而且盡量把顯示卡的記憶體與運算力用滿。這次 0.29.0,是廚房換了一套新的「出餐流程」。
發生什麼事
vLLM 在 9 月 9 日發布 0.29.0,共 594 個提交、277 位貢獻者(其中 91 位是新人)。最大的改變是:
- Model Runner V2(MRV2)成為所有模型的預設,完成之前先從向量類(pooling)模型開始的推廣
- MRV1 被視為棄用,目標在 0.32 移除,官方說不再接受針對 MRV1 的改進
- 官方預計 2 到 3 週內補齊 MRV2 還沒支援的功能,包括序列平行、雙批次重疊、彈性專家平行、自訂 logits 處理器與部分推測式解碼;在那之前,設定了這些功能,vLLM 仍會退回用 MRV1
新增與預設值的改變
| 面向 | 內容 |
|---|---|
| 新模型支援 | 騰訊 Hy4-preview(770B 總參數、49B 啟用的 MoE)、Qwen3.8-Flash-Next、GraniteSWA 系列、NemotronH Omni Reasoning V3、Kimi K3 的 NVFP4 版本 |
| FlashInfer all-reduce | TP 的 CUDA 群組預設開啟,可用 VLLM_ALLREDUCE_USE_FLASHINFER=0 關閉 |
| 前綴快取雜湊 | 預設固定,分散式 KV 快取的使用者不用再固定 PYTHONHASHSEED |
| 排隊上限 | 新增 --max-num-queued-reqs、--max-num-queued-tokens |
| Mamba 前綴快取 | 內部預填檢查點,TTFT 改善 9% 到 25% |
要注意的移除與棄用
- 移除十個已棄用的模型架構
- FlexOlmo、Olmo3、Hunyuan V1/VL 改走 Transformers 建模後端
- 移除 PyAV 影片解碼後端
python -m vllm.entrypoints.openai.api_server被棄用,改用vllm serve- 移除環境變數
VLLM_TEST_FORCE_FP8_MARLIN與VLLM_ROCM_USE_AITER_FP4_ASM_GEMM
給開發者的技術細節
安裝與升級(預設是 CUDA 13.0):
pip install -U vllm
docker pull vllm/vllm-openai:v0.29.0
- 需要 CUDA 12.9 的環境,用
vllm/vllm-openai:v0.29.0-cu129;也有 ROCm、CPU、XPU 的映像檔 - 啟動服務請用
vllm serve <模型>;要控制排隊長度,可加上--max-num-queued-reqs(數值請依自己的流量決定) - 推測式解碼可用
--per-request-spec-decode-metrics,在 OpenAI 相容的回應中取得每個請求的接受統計 - 官方也在 release 說明提供了 MRV2 尚未支援功能的追蹤頁面,升級前可以對照自己的設定
我的看法
我自己平常用 Ollama 在家裡的機器跑本機模型,vLLM 比較像是「正式上線、需要多人同時用」才會碰的工具。但這種「預設引擎換代」的版本,我覺得很值得看:不是因為它加了多炫的功能,而是升級後的行為差異,通常會出現在不太顯眼的地方,例如某個參數被棄用,或者某個功能悄悄退回舊的執行路徑。
如果你有自架 vLLM 服務,我會建議先在測試環境跑一遍自己真正用的設定與模型,看日誌有沒有出現退回 MRV1 或棄用的警告,再決定要不要升級到正式環境。官方既然說 MRV1 預計 0.32 移除,現在就該開始把依賴舊行為的設定整理好。
名詞小辭典
- 推論(Inference):模型訓練好之後,用來回答問題、產生內容的階段。
- TTFT:Time To First Token,從送出請求到收到第一個字的時間,越短越有「即時」感。
- 前綴快取(Prefix Cache):把重複出現的開頭內容先處理好存起來,下次遇到相同開頭就不用重算。
- MoE(混合專家):模型分成很多個專家,每次只動用其中一小部分,所以總參數很大、實際運算量卻較小。
資料來源
常見問題
vLLM 是什麼?
vLLM 是一個開源的大型語言模型推論引擎,把模型包成可以同時服務很多人的 API 服務,特色是吞吐量高、對顯示卡記憶體的利用有效率。常用在自架 AI 服務的團隊。
Model Runner V2 是什麼?要升級嗎?
它是 vLLM 內部負責「每一步怎麼跑模型」的新一代執行器。0.29 起成為所有模型的預設;舊的 MRV1 被視為棄用,官方不再接受針對它的改進。如果你的設定用到 MRV2 暫時不支援的功能,vLLM 會自動退回 MRV1。
升級後哪些指令要改?
官方列出:python -m vllm.entrypoints.openai.api_server 被棄用,請改用 vllm serve;環境變數 VLLM_TEST_FORCE_FP8_MARLIN 與 VLLM_ROCM_USE_AITER_FP4_ASM_GEMM 被移除;PyAV 影片解碼後端被移除。
個人電腦用得到嗎?
vLLM 主要面向伺服器與多使用者的推論,個人桌機想跑本機模型,通常用 Ollama 之類的工具比較簡單。如果你有自己的 GPU 主機要同時服務多人,才比較需要看 vLLM。
接著讀
全部觀點 →德國 Aleph Alpha 開源 Kolibri:78B 參數只動 3.5B,Apache 2.0 授權、最長 100 萬 token德國 AI 公司 Aleph Alpha 釋出開放權重模型 Kolibri,總共 780 億參數,但每個 token 只動用約 35 億,採 Apache 2.0 授權。它主打英文與德文,訓練到 25.6 萬 token 上下文,調整設定後可延伸到 100 萬。閱讀 →DeepSeek V4.1 Flash 小改版開源:Terminal-Bench 從 31.2 跳到 42.3,輸出還變短DeepSeek 推出 V4.1-Flash-1017,以 MIT 授權開放權重,多項跑分提升、完成任務更快、輸出更短。API 名稱 deepseek-flash 已指向新版,離峰時段每百萬輸出 token 只要 0.6 美元。閱讀 →Cloudflare 開源 Clef 決策模型:不寫文章只回機率,9B 版本中位數延遲 38 毫秒Cloudflare 推出第一批自己訓練的開源模型 Clef 與 Clef-flash。它們不產生文字,而是針對你給的問題直接回答「是的機率多少」「選哪個選項」,適合分類工單、擋不該做的動作。權重以 Apache 2.0 釋出,也能在本機跑。閱讀 →