觀點 · 資訊分享
Ollama 0.31.2:舊款 NVIDIA 顯卡也能開 Flash Attention,內顯可卸載更多視覺模型
本地模型工具 Ollama 在 7 月 6 日釋出 0.31.2:Flash Attention 擴大到算力 6.x 的舊款 NVIDIA 顯卡、內顯能卸載視覺模型、修好關閉思考時的結構化輸出,並強化 GGUF 模型建立的安全性。
- 發布
- 2026-07-07
- 篇幅
- 約 4 分鐘 · 1,610 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
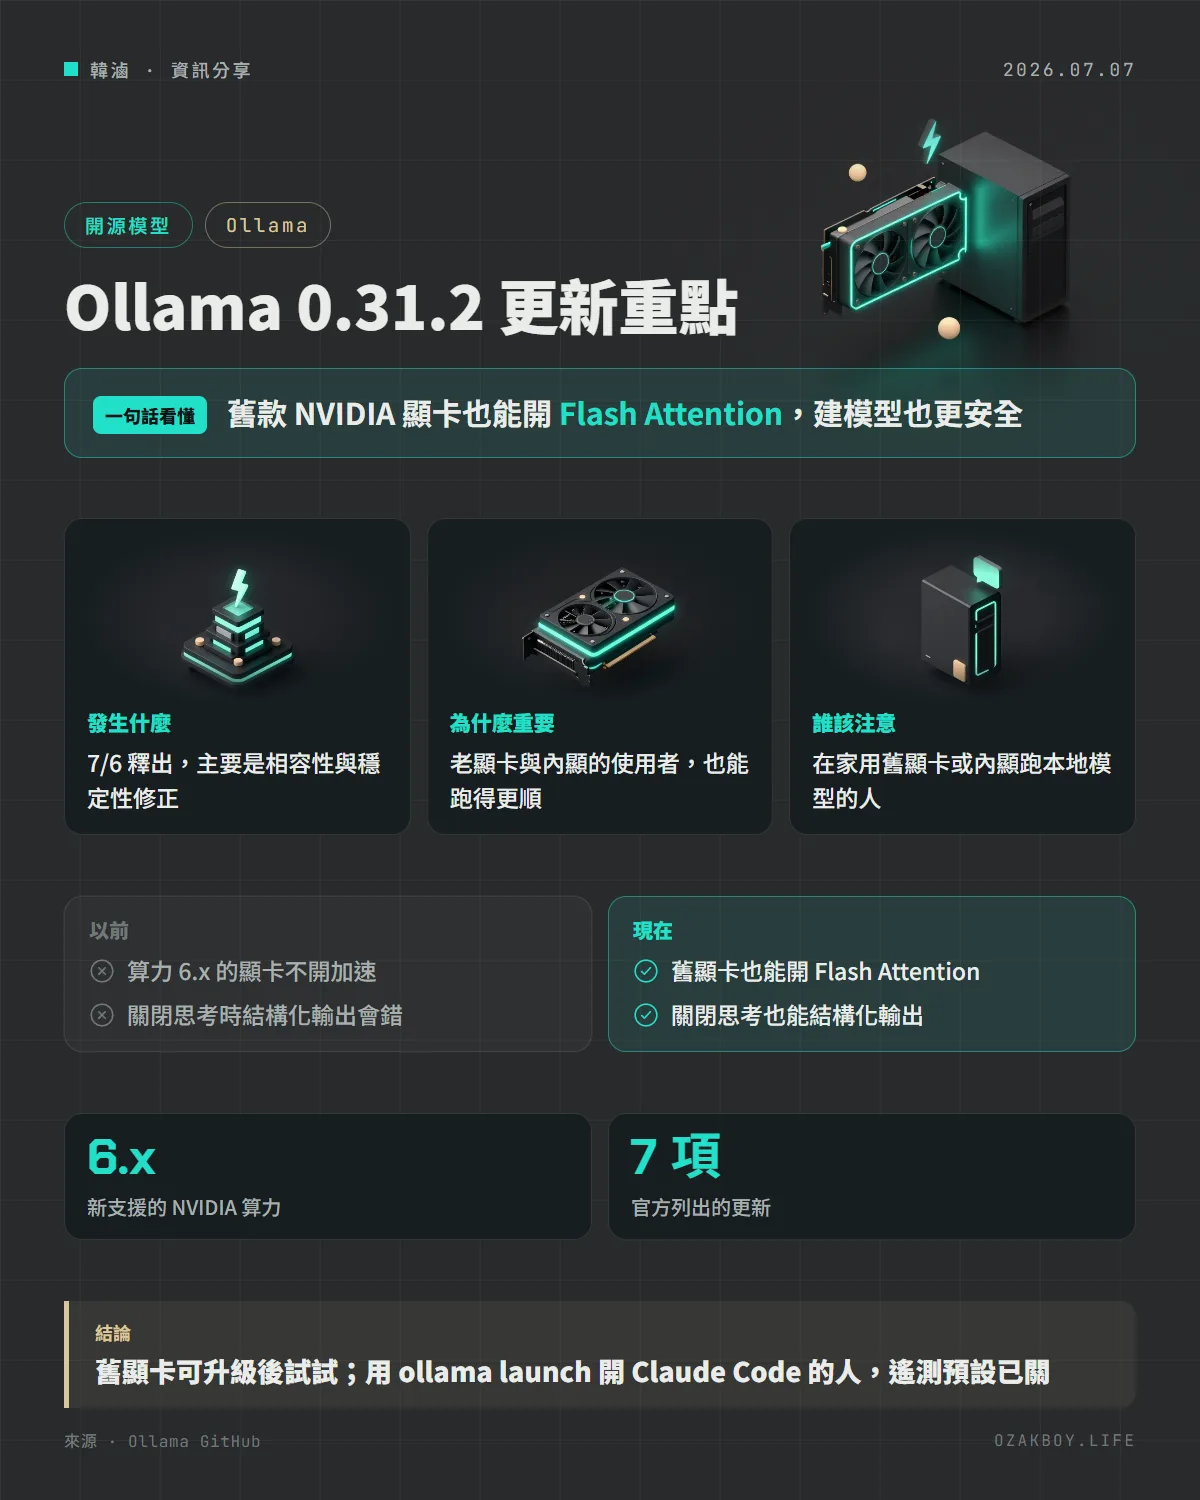
一句話看懂:Ollama 0.31.2 讓舊款 NVIDIA 顯卡也能開 Flash Attention,修好關閉思考時的結構化輸出,並加強了模型建立的安全性。
先用白話講:Ollama 與這次更新
Ollama 是在自己電腦上跑開源 AI 模型的工具,像是一個「本地的模型管家」:你告訴它要哪個模型,它負責下載、載入、回答。
這種工具最考驗的是「各式各樣的硬體都要能跑」:新顯卡、老顯卡、筆電內顯、Apple 晶片。這次 0.31.2 的更新,大多是在照顧這些比較不起眼的硬體與使用情境。
發生什麼事
Ollama 在 2026 年 7 月 6 日釋出 0.31.2,官方更新說明列出 7 項:
- 舊顯卡也能開 Flash Attention:算力(compute capability)6.x 的舊款 NVIDIA 顯卡現在可以啟用
- 內顯卸載視覺模型:內建顯示晶片(iGPU)現在可以卸載視覺模型,過程中會做補白(padding)處理,讓模型符合可用的記憶體大小
- 結構化輸出修正:思考型模型在關閉思考時的結構化輸出問題已修好
- GGUF 模型建立更安全:強化了建立 GGUF 模型時的防護
- Claude Code 啟動器遙測預設關閉:用
ollama launch啟動 Claude Code 時,預設會停用遙測 - 路徑修正:修好模型放在含非 UTF-8 字元的路徑時無法載入的問題
- 引擎更新:MLX 與 llama.cpp 兩個引擎都更新到新版
前一版的背景
0.31.2 之前的 0.31.1(6 月 30 日)主打 Apple 晶片上的 Gemma 4 加速:官方說在一個程式代理的測試中,利用多 token 預測(MTP)平均快了近 90%,預設啟用、不需設定、也不改變模型輸出。這兩個版本合起來看,方向是「各種硬體都更好用」。
給開發者的技術細節
- Flash Attention 在舊顯卡:官方只寫「算力 6.x」。如果你不確定自己的顯卡算力,可以到 NVIDIA 官網的 CUDA GPU 對照表查詢,升級後觀察顯示記憶體使用量與速度有沒有改善
- 結構化輸出:如果你的程式用 JSON Schema 等格式限制模型輸出、又把思考關掉,這個版本之前可能遇到格式不符的問題,升級後建議重新測試
- GGUF:GGUF 是常見的模型檔案格式;官方只寫「Hardened GGUF model creation」,沒有說明具體防護內容,所以我也不推測細節
- 路徑:模型目錄在不同語系或掛載的磁碟上,路徑可能含有非 UTF-8 字元,這類環境升級後比較不容易載入失敗
我的看法
我喜歡這類「照顧舊硬體」的更新。很多人嘗試本地 AI 時,手上其實是幾年前的顯卡或沒有獨顯的筆電,如果新版本只優化新硬體,大家就只能乾瞪眼。Flash Attention 擴大到舊顯卡,對想用有限的顯示記憶體多塞一點上下文的人是實在的幫助。
不過這種版本也有個提醒:沒有明確的安全公告,不必急著升級,但如果是正在使用中的環境,仍建議先在一台機器測過再全面更新,尤其是有依賴結構化輸出的服務。
名詞小辭典
- Flash Attention:一種更省記憶體、更快的注意力計算方式,是現代語言模型加速的常用技巧。
- iGPU(內顯):整合在處理器裡的顯示晶片,和獨立顯卡相對。
- GGUF:本地模型常用的檔案格式,把模型權重和設定包在同一個檔案裡。
- 遙測(Telemetry):軟體自動回傳使用情況給開發者的功能。
資料來源
常見問題
Flash Attention 是什麼?
一種改良過的注意力計算方式,能讓模型在處理長內容時更快、也更省顯示記憶體。這次是把它開放給算力 6.x 的舊款 NVIDIA 顯卡(從算力編號看,大致是 GTX 10 系列那一代,這是我的對照,官方只寫了 6.x)。
「結構化輸出」出錯是什麼情況?
結構化輸出是指要求模型照指定格式(例如 JSON)回答。依更新說明,當使用者把思考模型的「思考」功能關掉時,這個格式限制先前會出問題,0.31.2 已修正。
需要馬上升級嗎?
沒有緊急的安全公告,這是一般性的更新。如果你用舊款 NVIDIA 顯卡、內顯,或遇過模型路徑、結構化輸出的問題,值得升級;其他人可依自己的維護節奏。
接著讀
全部觀點 →Ollama 0.40.4:Codex CLI 可以直接挑本機模型,終端機一行指令就能讓 AI 判斷是或否Ollama 0.40.4 讓 ollama launch codex 的模型選單出現本機安裝的模型,決策模型也能直接在終端機用 ollama run 問是非題、分類與評分;另外改善推論效能、支援多模態嵌入,Gemma 4 在 NVIDIA 顯示卡上的前置處理也變快。閱讀 →Ollama 0.34 讓 ChatGPT 桌面版的 Codex 模式能改用開源模型:本機或雲端的都能挑,最多 5 個Ollama 0.34.0 可以把本機與雲端的開源模型加進 ChatGPT 桌面版的 Codex 模式選單,一般聊天與語音則維持原樣。同版本也改善 Apple Silicon 的結構化輸出速度。閱讀 →Ollama 0.32.0:直接輸入 ollama 就開啟 AI 代理,舊的程式模型啟動前會先警告Ollama 0.32.0 讓你在終端機直接輸入 ollama,就會進入能寫程式、查資料、交辦工作的 AI 代理介面。同版也簡化了 launch 選單,並對 CodeLlama、Qwen2.5 等舊模型加上停用警告。閱讀 →