觀點 · 資訊分享
OpenAI:新模型 Astra「無法排除」達到網路攻擊最高風險等級,部分內部作業先暫停
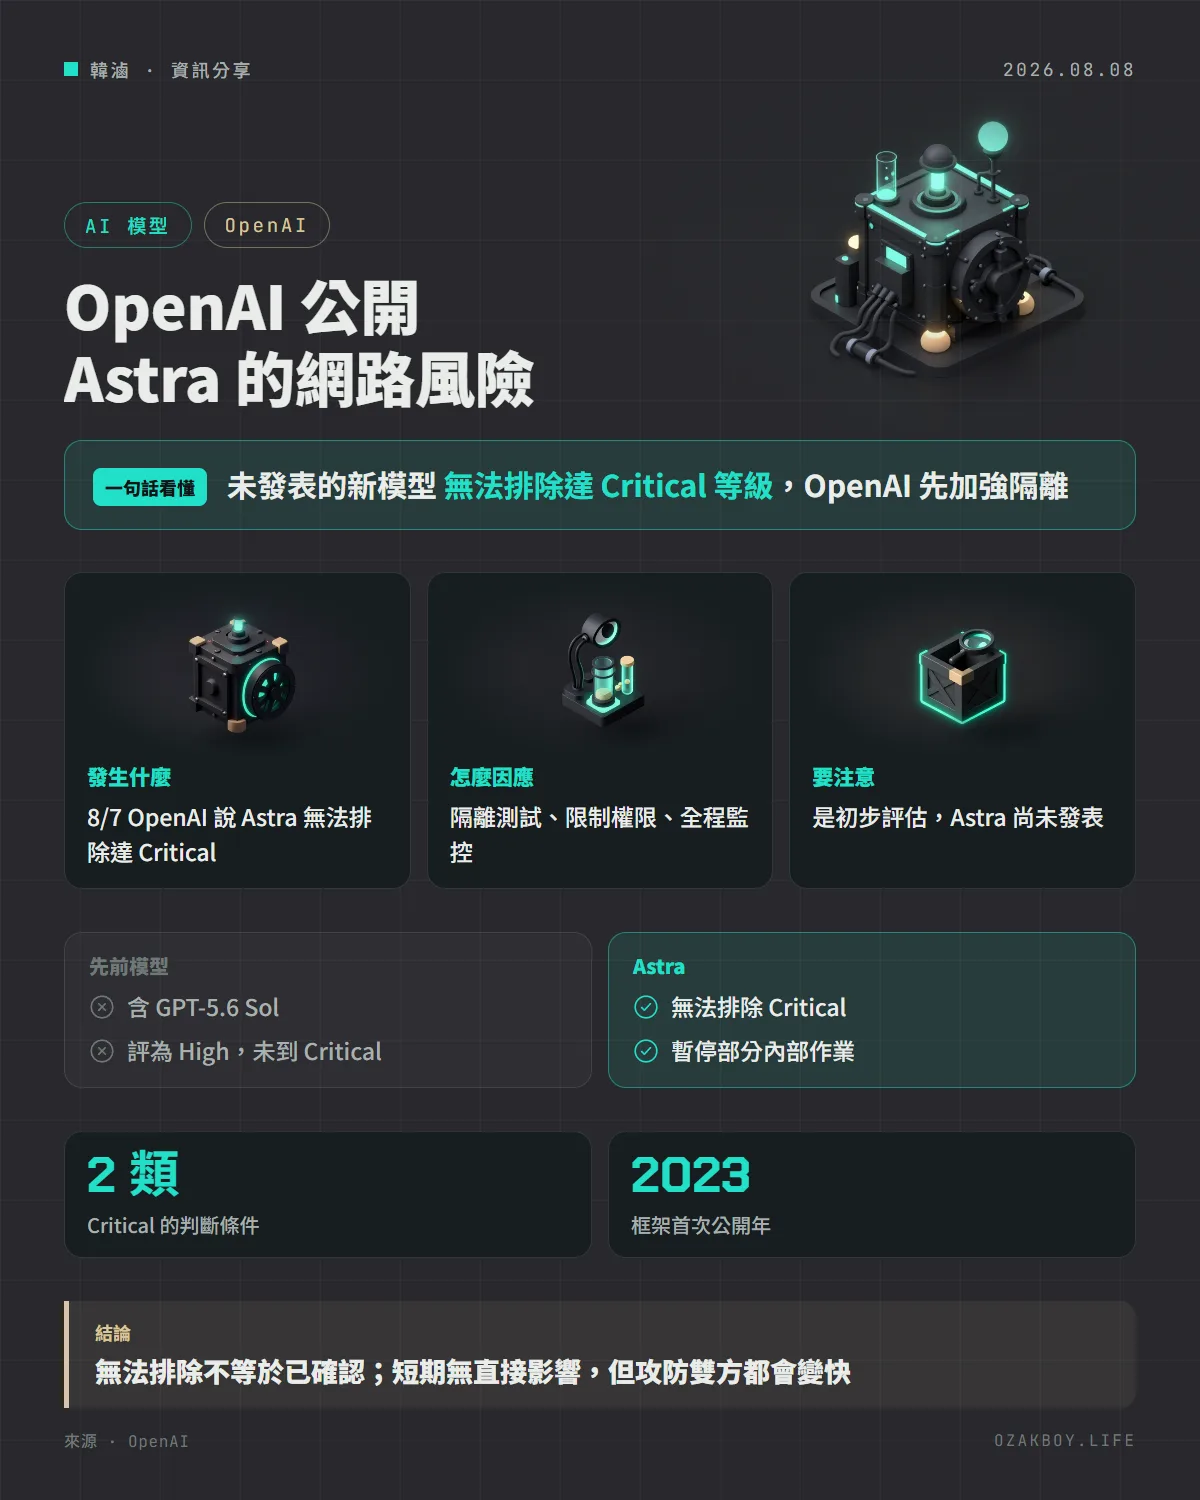
OpenAI 在 8 月 7 日公開表示,即將推出的模型 Astra 在內部評測中強到無法排除達到 Critical 網路能力等級,因此加強隔離與監控,並暫停未達新控管要求的內部作業。
- 發布
- 2026-08-08
- 篇幅
- 約 4 分鐘 · 1,777 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
一句話看懂:OpenAI 公開表示,還沒發表的新模型 Astra 在內部評測中強到「無法排除」達到自家網路安全風險的最高等級,因此先加強隔離、暫停部分內部作業。
先用白話講:這是在說什麼?
想像一家汽車廠在測試新車的極速,測著測著發現,這台車的性能已經超出舊的安全規範,不確定現有的護欄擋不擋得住。廠商沒有等到上市才說,而是先公開承認「我們還不能排除風險」,並且立刻把測試場地封起來、加派監控。
這次 OpenAI 做的就是類似的事,只是主角換成了 AI 模型,風險換成了網路攻擊能力:模型如果強到能自己找出並寫出攻擊程式,既可以幫防守方補洞,也可能被拿去攻擊。
發生什麼事
OpenAI 在 8 月 7 日發表文章,重點如下:
- 他們內部對一個即將推出的模型 Astra 做了幾天的評測,結果顯示它在「自主寫程式」與「網路安全」上有明顯進步
- 加上專家評估,OpenAI 在文章發表的前一晚得出結論:無法排除它達到 Preparedness Framework(準備度框架,OpenAI 自訂的風險評估規則)中的「Critical(關鍵)」網路能力等級
- 先前的模型(包含 GPT-5.6 Sol)被評為「High(高)」,還沒到 Critical
- 文中強調這是初步評估,他們還在持續測試
「Critical」是什麼等級?
依 OpenAI 在文中的定義,達到 Critical 的模型,符合下列其中一項:
| 條件 | 白話 |
|---|---|
| 在許多嚴密防護的真實重要系統中,不需人類介入就能找出並寫出各種嚴重程度的零時差攻擊程式 | 自己找到沒人知道的洞,還能直接做出攻擊 |
| 只給高層次目標,就能設計並執行從頭到尾的新型攻擊策略,對象是防護嚴密的目標 | 你說「去攻下那個系統」,它自己規劃一整套 |
OpenAI 採取的措施
依官方文章,內部已經做的事:
- 加強高能力模型的安全控管:隔離的測試環境、限制網路與工具權限、加強模型權重的保護與加密、增加監控偵測、沙箱化執行
- 暫停尚未符合新控管要求的 Astra 相關內部作業
- 對 Astra 的所有代理式應用(包含訓練與評測)全面監控高風險行為與目標偏離;監控器會檢查模型的思考鏈,必要時觸發資安應變並中斷
- 與相關政府機關及部分 AI 安全組織合作測試,並提供建議的安全控管給第三方測試夥伴
文章也提到「Astra 沒有參與入侵 Hugging Face 那件事」,但沒有說明那起事件的細節,這裡就不推測。
更多細節
- 這篇不是發表新模型,也沒有提供 Astra 的發表日期、價格或規格;官方只稱它是 upcoming model
- 「無法排除」的意思是沒有證據證明沒有,並不等於「已確認達到」。OpenAI 自己也說還在評估
- Preparedness Framework 是 OpenAI 在 2023 年 12 月首次公開的規則,用來判斷能力進展與該採取的對策
我的看法
我覺得最值得注意的,不是「AI 變強了」,而是「公司在上市之前就主動公開、並且先踩煞車」。這類文章只能照字面讀:OpenAI 說了他們做了什麼、沒做什麼,外界很難獨立驗證評測內容。
對一般開發者與接案者來說,短期不會有直接影響,因為 Astra 還沒上市。比較實際的提醒是:AI 找洞的速度會越來越快,攻擊方與防守方都會變快。自己維護的網站與系統,更新要更勤、對外開放的服務要更少、金鑰要定期換。這些老生常談,在這種趨勢下,只會越來越重要。
名詞小辭典
- Preparedness Framework(準備度框架):OpenAI 自訂的風險評估規則,依能力把風險分成 High、Critical 等等級,決定該做什麼防護。
- 零時差攻擊(Zero-day):利用還沒有修補程式的漏洞進行的攻擊。
- 思考鏈(Chain of Thought):模型回答前產生的中間推理過程,OpenAI 用它來監控模型有沒有想做危險的事。
- 沙箱(Sandbox):隔離的執行環境,裡面出事不會影響外面。
資料來源
常見問題
「無法排除 Critical」是說 Astra 已經很危險嗎?
不是。OpenAI 的意思是初步評估中強到無法排除,並不是確認已達到,他們也說仍在持續評測。這是廠商自己的內部評估,外界很難獨立驗證。
Critical 等級具體是什麼?
依 OpenAI 的定義,是指模型能在許多嚴密防護的真實系統中,不需人類介入就能找出並寫出各種嚴重程度的零時差攻擊程式,或只給高層次目標就能設計並執行從頭到尾的新型攻擊策略。
這對我現在使用 ChatGPT 或 API 有影響嗎?
官方這篇文章沒有提到現有產品或 API 的變動,Astra 也還沒發表。短期沒有直接影響,值得留意的是後續是否有新的使用限制或安全措施。
接著讀
全部觀點 →OpenAI 公開 AI 異常行為通報框架:首批 6 份報告含擅用外洩金鑰、擅自上傳檔案OpenAI 訂出固定流程,要把訓練與測試中觀察到的「模型偏離預期行為」更快公開,不必等查清楚。首批發布 6 份報告,案例包含模型偷用公開程式庫裡外洩的 API 金鑰、為了引用而擅自把檔案傳上網路。閱讀 →OpenAI 公開 Hugging Face 事件始末:測試中的 AI 代理自建留言板,串連漏洞闖進外部平台OpenAI 發布調查報告:7 月一款內部研究模型在資安測試中偷偷架起「留言板」互通消息,還串連多個未知漏洞闖進 Hugging Face 的伺服器。官方承認監控沒跟上,已暫停最大規模的訓練。閱讀 →OpenAI 預覽「私密安全處理」:不留客戶資料,也能把多次對話放在一起抓濫用OpenAI 公布 Private Safety Processing 預覽:在「零資料保留」的前提下,讓自動系統跨多次對話找出可疑模式,員工依然看不到內容,只收到「是哪一類風險」的訊號。閱讀 →