觀點 · 資訊分享
Gemini 3.5 Transcribe 正式上線:語音轉文字支援 85 種以上語言,一小時錄音約 0.3 美元
Google 在 8 月 26 日讓 Gemini 3.5 Transcribe 與 Transcribe Live 進入正式版:一款轉錄錄音檔、一款即時串流,可分辨說話者。官方價格頁估算每分鐘約 0.005 美元。
- 發布
- 2026-08-26
- 篇幅
- 約 4 分鐘 · 1,933 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
一句話看懂:Google 在 8 月 26 日讓兩款專門把語音轉成文字的 Gemini 模型正式上線:一款處理錄音檔,一款處理即時串流,支援 85 種以上語言,還能分辨是誰在說話。
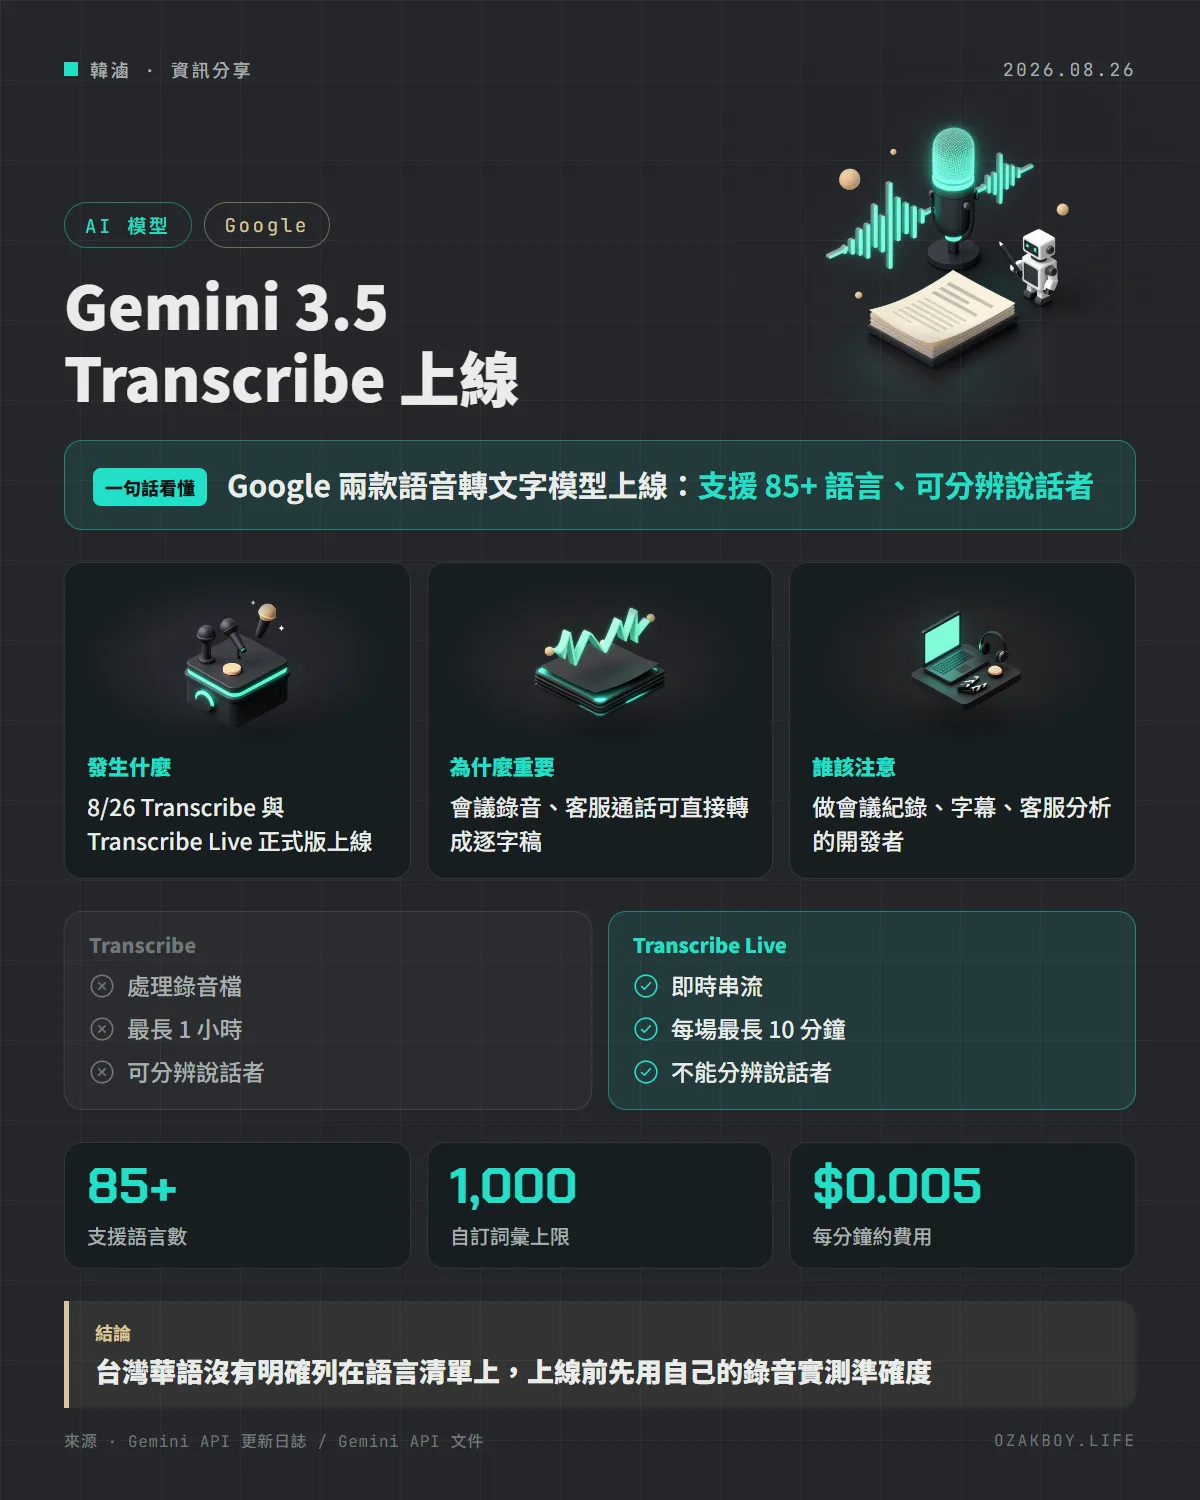
先用白話講:語音轉文字模型在做什麼?
想像你請了一位很會速記的助理,開會時坐在旁邊。你說一句,他就寫一句;開完會他還能告訴你「這段是 A 說的,那段是 B 說的」。語音轉文字(也叫逐字稿、轉錄)就是這個工作,只是把助理換成 AI。
以前很多人用通用的 AI 模型來做這件事,現在 Google 直接推出兩款「專門做轉錄」的模型,叫 Gemini 3.5 Transcribe。
發生什麼事
Gemini API 更新日誌在 8 月 26 日宣布,兩款模型進入正式版(GA):
| 模型代號 | 用途 | 特色 |
|---|---|---|
gemini-3.5-transcribe |
轉錄錄音檔(非串流) | 自動偵測 85 種以上語言、分辨說話者、字級時間戳、自訂詞彙最多 1,000 個 |
gemini-3.5-transcribe-live |
即時串流轉錄 | 透過 WebSocket 傳聲音進去、邊說邊出字,有暫定與定稿兩種事件,並有多種語音活動偵測策略 |
第二款走的是 Live API。官方也提到「智慧轉錄」模式:會幫你去掉口頭禪與重複的字,並把數字、大小寫整理成比較好讀的格式。
有哪些限制?
模型頁面列了不少細節(該頁在 9 月 1 日更新過,以下是我 10 月讀到的版本):
- 一次最多處理 1 小時的錄音;如果開了分辨說話者或字級時間戳,上限變成 30 分鐘
- 分辨說話者最多 8 人,3 人以上屬於實驗性質
- 自訂詞彙最多 1,000 個,但官方說多數情況在 100 個以內效果最好;它不能和分辨說話者、字級時間戳同時用
- 即時串流版每場最長 10 分鐘,而且不支援分辨說話者與字級時間戳
- 這兩款模型都不支援快取、函式呼叫、思考、批次 API
要花多少錢?
依官方價格頁(我 10 月讀到的版本):
| 模型 | 輸入(音訊) | 輸出(文字) | 官方估算混合費率 |
|---|---|---|---|
| Transcribe | 每百萬 token 2.00 美元 | 每百萬 token 12.00 美元 | 約每分鐘 0.005 美元 |
| Transcribe Live | 每百萬 token 3.50 美元 | 每百萬 token 21.00 美元 | 約每分鐘 0.009 美元 |
官方的估算基準是音訊每秒 25 個 token、輸出每分鐘 175 個 token。依這個費率,一小時錄音大約是 0.3 美元(自行換算,60 分鐘乘以 0.005)。免費層級可以試用,但官方寫明免費層的內容會被用來改進產品,付費層則不會。
給開發者的技術細節
官方範例是用 Interactions API,先把檔案傳上去再呼叫模型:
from google import genai

client = genai.Client()
audio_file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{"type": "audio", "uri": audio_file.uri, "mime_type": audio_file.mime_type}],
)
print(interaction.output_text)
- 預設會自動偵測語言,並能處理同一句話混用兩種語言的情況;如果事先知道語言,可以在
generation_config.transcription_config.language_codes填入語言編號(BCP-47)提高準確度 - 官方也提供 JavaScript、Go 與 REST 的範例
我的看法
對做會議紀錄、客服通話分析、影片字幕的人來說,這是很實用的新工具,而且價格寫得很清楚,一小時錄音大約只要幾十美分。
但我有兩點提醒。第一,台灣華語:支援語言清單上,我只看到「簡體中文普通話」與「繁體粵語」,沒有看到明確標示台灣華語的選項,所以實際辨識效果要自己用錄音測。第二,限制很多:想要分辨說話者就不能用自訂詞彙,錄音超過 30 分鐘還得自己切段。
如果你在幫客戶做這類功能,我會先拿十段真實的錄音試跑,看專有名詞、口音和雜音的結果,再決定要不要上線;另外別把客戶的敏感錄音丟到免費層,因為官方寫明免費層的資料會用來改進產品。
名詞小辭典
- 語音轉文字(STT):把說話的聲音變成文字的技術。
- 說話者分離(Diarization):判斷一段錄音裡,哪幾句是誰說的。
- 字級時間戳:每個字出現的起訖時間,做字幕時很有用。
- WebSocket:一種讓程式與伺服器保持長連線、雙向即時傳資料的方式。