觀點 · 資訊分享
BigQuery 內建 TabFM 預覽:預測客戶流失、詐欺不用先訓練模型,一句 SQL 就能跑
Google Cloud 在 8 月 31 日讓 BigQuery 支援 TabFM,這是針對表格資料的預訓練模型。用 AI.PREDICT 把歷史資料與新資料丟進去,就能做分類與迴歸預測,不用訓練、調參。目前是預覽版。
- 發布
- 2026-09-01
- 篇幅
- 約 4 分鐘 · 1,791 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
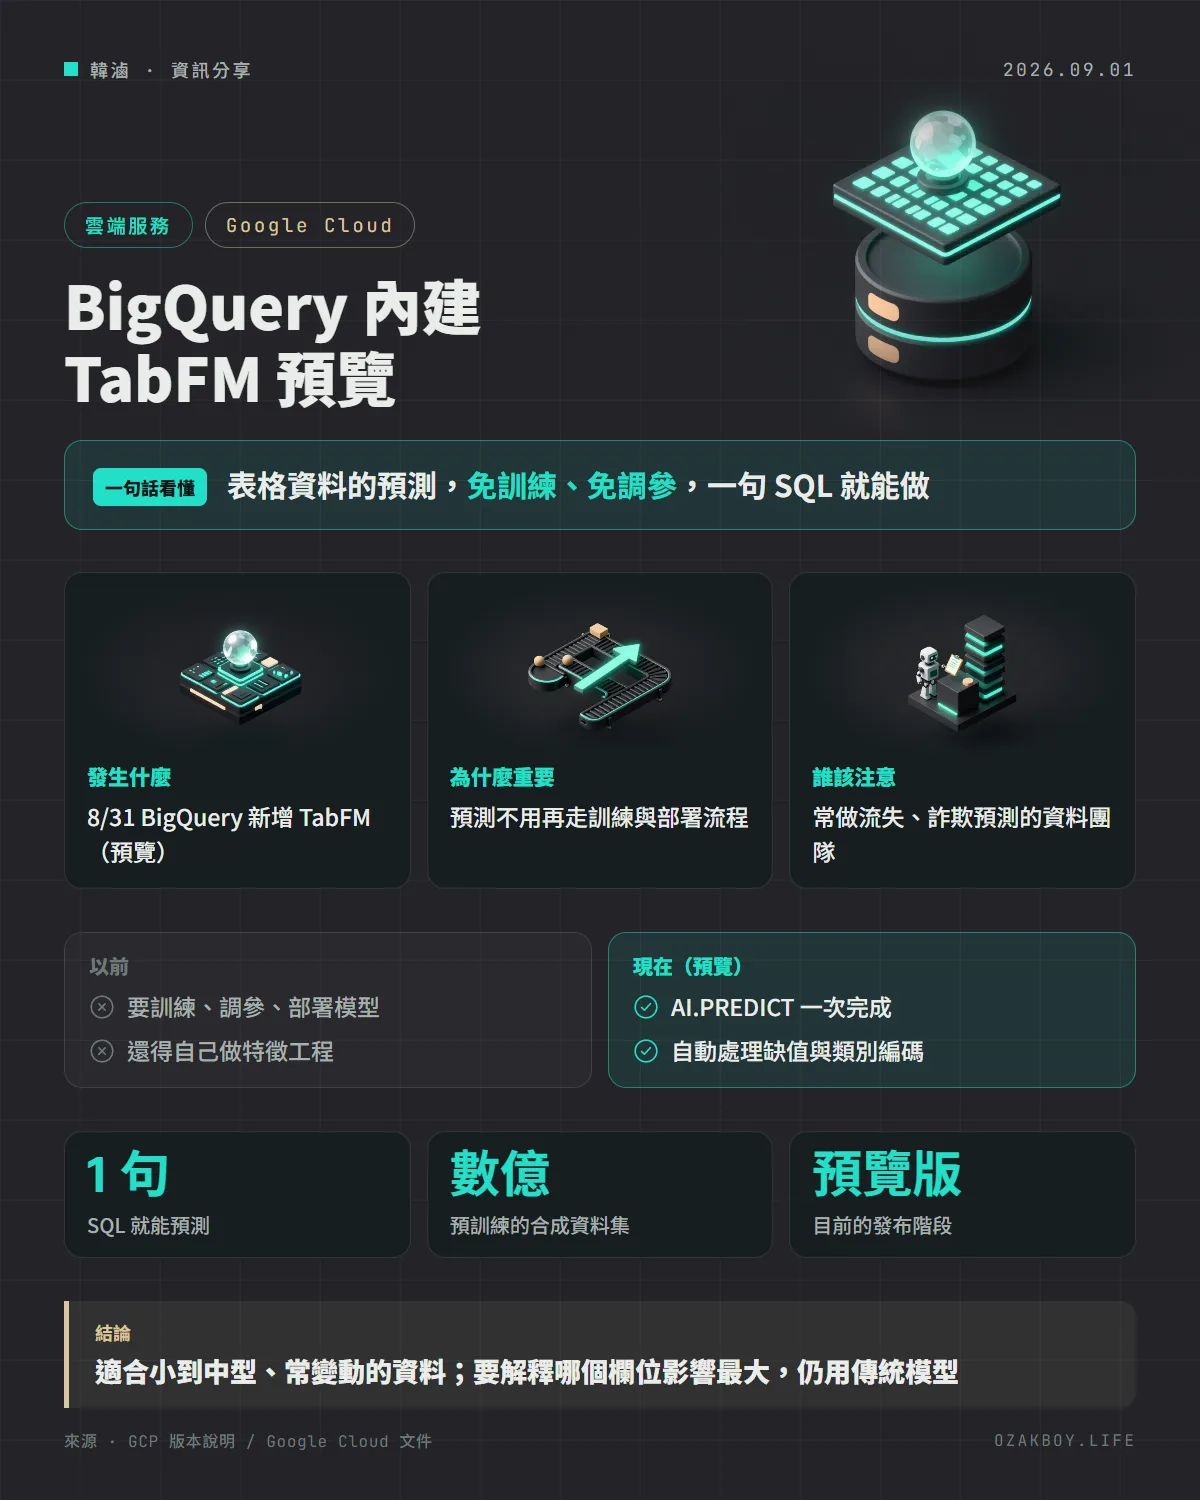
一句話看懂:BigQuery 新增內建的 TabFM 模型,預測客戶流失、詐欺這類表格資料的問題,不用先訓練模型,寫一句 SQL 就能得到結果;目前是預覽版。
先用白話講:表格資料預測是什麼?
公司的客戶名單、訂單紀錄、交易明細,都是「一列一筆、一欄一種資訊」的表格資料。常見的預測問題是:這位客戶下個月會不會流失?這筆交易是不是詐欺?
傳統做法像是請一位專家,每次都要先花時間看歷史資料、反覆調整,做出一個專屬模型,再部署上線,資料一變又得重來。
TabFM 比較像一位已經看過數億份人工合成表格練習題的資優生。你把歷史資料(當範例)和要預測的新資料一起遞給他,他看過範例就直接作答,不必另外訓練。
發生什麼事
Google Cloud 的版本說明在 8 月 31 日列出,BigQuery 現在支援 TabFM,狀態是預覽(Preview)。
- 模型來源:Google Research 的表格資料基礎模型,BigQuery 內建的是它的實作
- 訓練方式:官方文件說,它是用數億個以結構因果模型產生的合成資料集預訓練出來的
- 使用方式:透過
AI.PREDICT做預測、AI.EVALUATE看成績,不用訓練、調參或自己做特徵工程 - 效果:官方文件說,預測結果可與 XGBoost、隨機森林這類傳統演算法相比;Google 部落格另外說在 TabArena 評測中領先,這是廠商自己的說法
同一天的版本說明還有兩項 BigQuery 更新:BigQuery Graph 正式版(GA),以及可建立自動遞增的識別欄位(Identity column,預覽版)。
什麼時候該用?
| 情境 | 官方建議 |
|---|---|
| 想快速取得預測、沒有機器學習專業 | TabFM |
| 歷史資料中小型、資料常變動、常要重訓 | TabFM |
| 要在對話或 AI 代理中隨時做預測 | TabFM 搭配 BigQuery MCP server |
| 資料量很大、要完全掌控調參 | 傳統模型,例如 XGBoost |
| 要知道哪個欄位影響預測最大 | 傳統模型 |
給開發者的技術細節
官方部落格的範例(分類是否詐欺):
SELECT * FROM AI.PREDICT(
  TABLE `my_project.my_dataset.historical_transactions`,
  TABLE `my_project.my_dataset.new_transactions`,
  label_col => 'is_fraud'
);
- 第一個資料表是歷史資料(當範例),第二個是要預測的新資料,
label_col是要預測的欄位 - 模型會依目標欄位的資料型態自動判斷是分類還是迴歸
- 輸出包含原本所有欄位,加上預測標籤與機率欄位(如
predicted_is_fraud) - 授權:透過 BigQuery 使用受 Google Cloud 服務條款規範,可商業使用;GitHub 與 Hugging Face 上可下載的權重是非商用授權,只適用自己架設
- 預覽功能依 Pre-GA 條款提供,可能有限的支援
我的看法
多數我接觸的中小企業客戶,資料還沒進到 BigQuery,所以這項功能對他們不是立刻有用。但它代表一個趨勢:預測分析的門檻,正從「找資料科學家」變成「會寫 SQL 就能試」。
我的提醒是:容易上手不代表可以盲信。流失、詐欺這類結果可能影響營運決策,先拿過去已知答案的資料,用 AI.EVALUATE 驗證一次準不準,再決定要不要採用。官方自己也說,要解釋「為什麼」時,傳統模型還是比較合適。
名詞小辭典
- 基礎模型(Foundation model):先用大量資料預先訓練好、可以直接用在多種任務上的模型。
- 上下文學習(In-context learning):不更新模型參數,只靠在輸入裡放幾個範例,讓模型學會做同類的事。
- 分類 / 迴歸:分類是預測「屬於哪一類」(是不是詐欺),迴歸是預測「一個數字」(客戶終身價值)。
- 預覽版(Preview):功能開放試用,但還沒到正式版,規格與支援都可能調整。