觀點 · 資訊分享
BigQuery 的 AI 函式可以設每日 token 上限了:一行 SQL 燒掉整月預算的風險變小
Google 宣布 BigQuery 生成式 AI 函式的 token 配額正式上線,可以替整個專案或每位使用者設每日的輸入、輸出 token 上限,調低立即生效,避免一次查詢就把預算燒光。
- 發布
- 2026-10-15
- 篇幅
- 約 4 分鐘 · 1,683 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
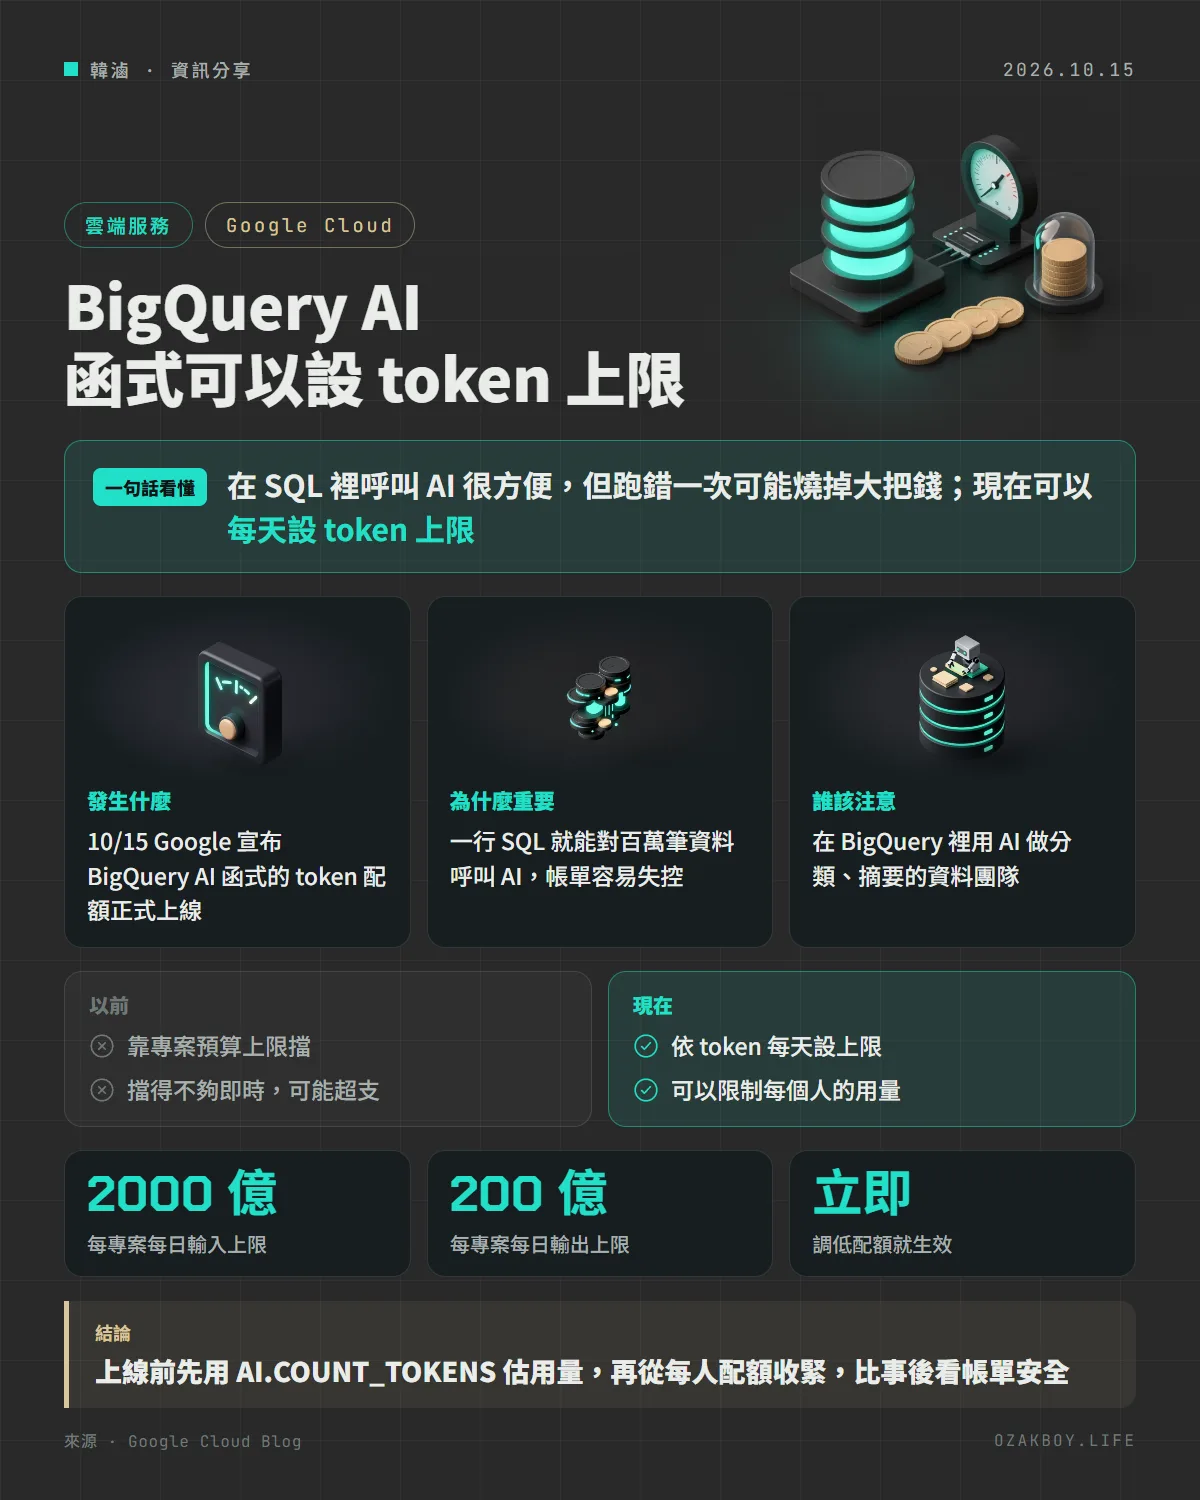
一句話看懂:Google 讓 BigQuery 的 AI 函式可以設「每日 token 上限」,整個專案和每位使用者都能各自限額,避免一次寫錯的查詢就把 AI 預算燒光。
先用白話講:為什麼 AI 函式需要上限?
想像你辦了一張可以無限刷的信用卡給家裡的小朋友,叫他去便利商店買一瓶飲料。他很乖,只買一瓶;但只要有一次手滑多按了幾個零,帳單寄來才知道出事。
BigQuery 的 AI 函式就是這樣的卡。資料分析師只要在 SQL 裡寫一行 AI.GENERATE,就能讓 Gemini 幫每一筆資料做分類或摘要。資料有一百萬筆,就會呼叫一百萬次 AI,每一次都依 token(AI 計算文字量的單位)收費。
這次的新功能,等於替這張卡設了「每天最多刷多少」。
發生什麼事
Google 在 10 月 15 日的官方部落格宣布,BigQuery 生成式 AI 函式的 token 配額管理正式上線(GA),透過 Google Cloud 的配額系統控管。預設值如下:
| 配額 | 範圍 | 預設上限 |
|---|---|---|
| 每日輸入 token | 每個專案 | 2,000 億 |
| 每日輸入 token | 每個專案的每位使用者 | 1,500 億 |
| 每日輸出 token | 每個專案 | 200 億 |
| 每日輸出 token | 每個專案的每位使用者 | 150 億 |
- 全球加總:所有地區的用量加在一起算
- 輸出含思考:模型「思考」用掉的 token 也算在輸出配額裡
- 調低立即生效,不用審核;調高要送申請,多數會自動核准
預算要怎麼換算成配額?
官方給了一個範例:用 Gemini 3.1 Flash-Lite 的批次價格(輸入每百萬 token 0.125 美元、輸出 0.75 美元),假設每天預算 100 美元、輸入和輸出比例是 100 比 1,算出來每天大約可用 7.54 億輸入 token、754 萬輸出 token,就把配額設成這兩個數字。
不同模型的價格不同,官方建議依模型分開算預算,或用混合費率估算。
給開發者的技術細節
上線前可以先用 AI.COUNT_TOKENS 估算輸入量,它只跑分詞、不呼叫模型生成,所以不會產生生成費用:
SELECT SUM(
  AI.COUNT_TOKENS(
    CONCAT('請判斷這則評論是正面、負面或中立:', review_text),
    endpoint => 'gemini-3.1-flash-lite').result) AS total_input_tokens
FROM `my_project.my_dataset.product_reviews`;
- 這個數字是下限:不含輸出、思考 token、函式自己加上的指令,也不含圖片等非文字輸入
- 查詢開始前配額已經用完,會直接回
QuotaExceeded錯誤 - 跑到一半用完,BigQuery 會停止送新的模型呼叫;
AI.GENERATE這類函式仍會完成,但沒跑到的列沒有結果,status欄位會寫明原因 - 可以用
max_output_tokens限制輸出長度,因為輸出比輸入貴 - 產生向量的
AI.GENERATE_EMBEDDING與AI.EMBED不受這個配額管
我的看法
接案時常遇到客戶說「把這幾十萬筆客服紀錄丟給 AI 分類一下」,在資料倉儲裡直接用 SQL 呼叫 AI 確實最省事。但最怕的不是正常使用,而是測試時忘了加 LIMIT,或排程重複觸發,一覺醒來帳單多了一個零。
原本的專案預算上限是用金額算,而且擋得不夠即時,官方也說可能會有部分超支。token 配額直接卡在 AI 呼叫這一層,比較像真正的煞車。我的建議是先設每人配額,讓單一帳號或單一實驗不會吃光整個專案的額度,再搭配預算上限當最後一道保險。
名詞小辭典
- BigQuery:Google Cloud 的資料倉儲服務,用 SQL 就能分析大量資料。
- Token:AI 計算文字量的單位,API 依 token 數量收費。
- 配額(Quota):雲端服務替某項資源設定的使用上限,超過就暫停服務。
- 思考 token(Thinking tokens):模型在給出答案前「內部推理」所用掉的 token,同樣要計費。