觀點 · 資訊分享
Google Cloud 資料庫內建 BM25 搜尋:AlloyDB、Cloud SQL 不用再另架搜尋引擎
Google Cloud 讓 AlloyDB 與 Cloud SQL for PostgreSQL 17 以上版本,直接在資料庫裡做 BM25 關鍵字排序(預覽版)。搭配向量搜尋就能做「混合搜尋」,不必再多養一套 Elasticsearch 之類的搜尋服務。
- 發布
- 2026-09-19
- 篇幅
- 約 3 分鐘 · 1,555 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
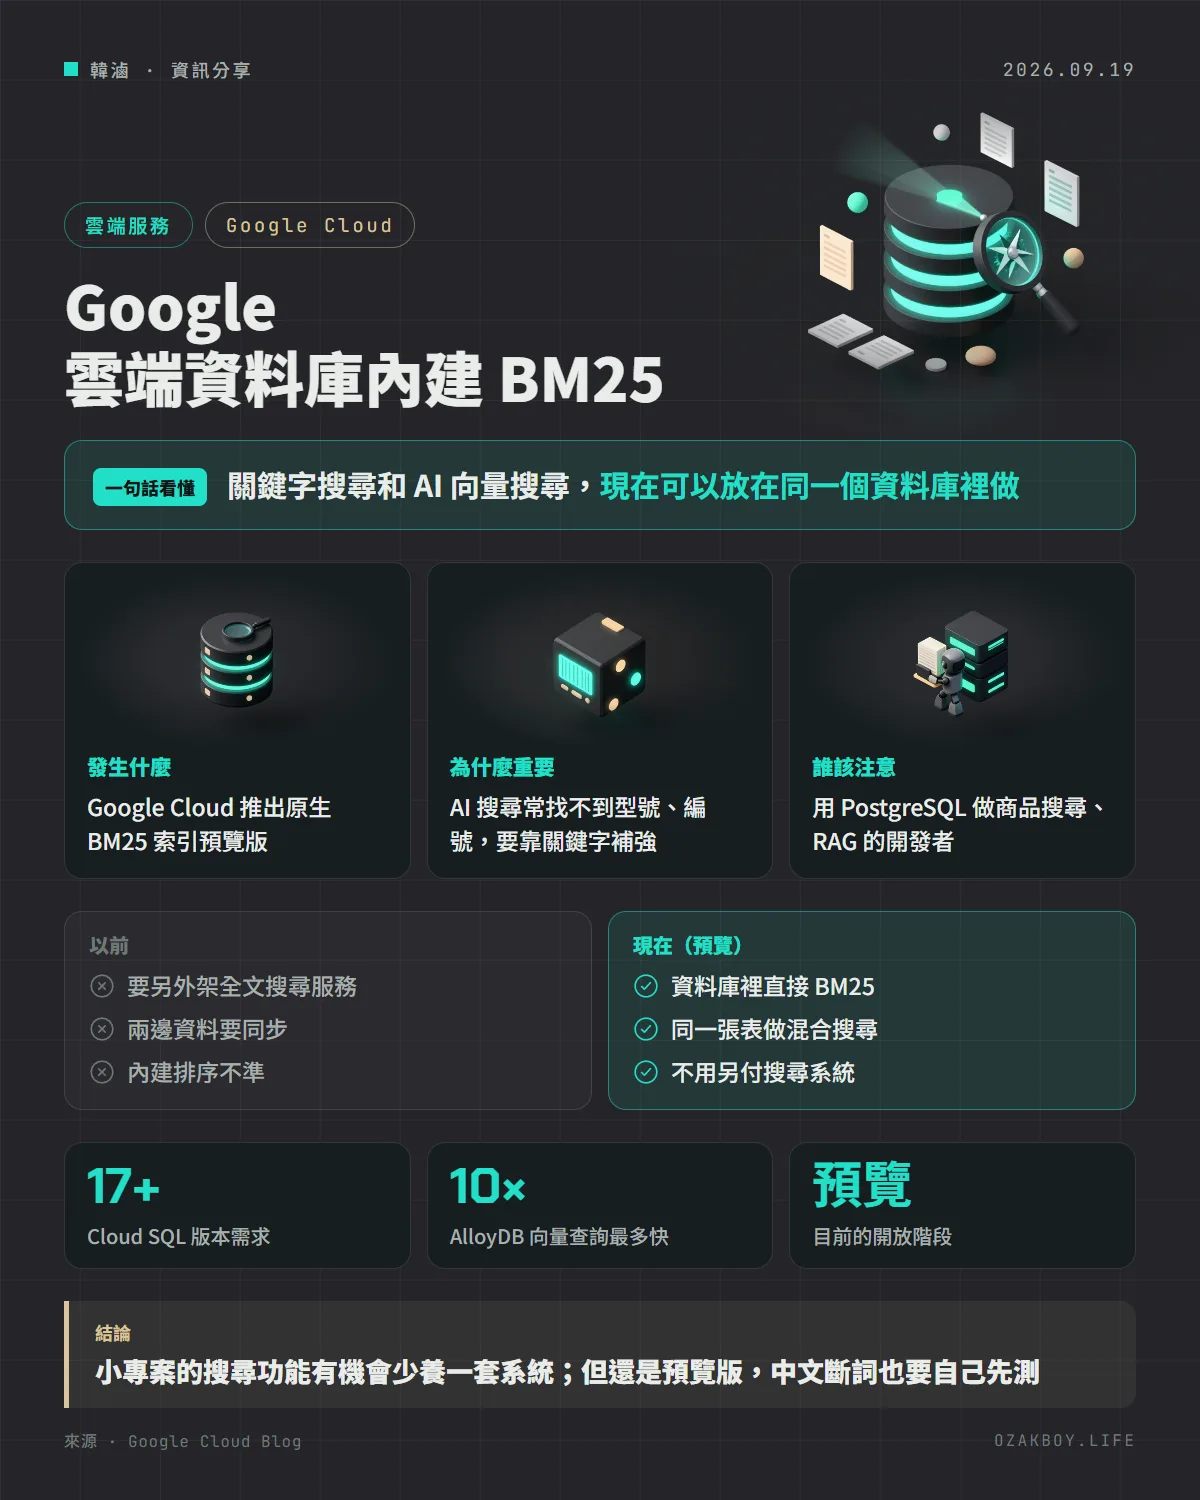
一句話看懂:Google Cloud 讓 AlloyDB 與 Cloud SQL 直接在資料庫裡做 BM25 關鍵字排序,搭配向量搜尋就能做混合搜尋,不必再多架一套搜尋引擎。
先用白話講:BM25 和「混合搜尋」是什麼?
想像你在圖書館找書,有兩種館員:
- 第一位館員很懂意思:你說「想找一本講樹長得比房子高的書」,他就算書名沒有這幾個字,也找得出來。這就是 AI 的向量搜尋
- 第二位館員很會比對字:你說「我要編號 A-1023 的那本」,他一字不差地翻出來。這就是關鍵字搜尋
BM25 是第二位館員最常用的排序方法:越罕見的詞越重要、同一個詞重複一百次也不會無限加分、還會考慮文章長短。
把兩位館員的結果合在一起排,就叫混合搜尋。問題是,以前在 Google Cloud 的 PostgreSQL 資料庫裡,只請得到第一位館員;第二位要另外花錢、另外架一套搜尋系統。
發生什麼事
Google Cloud 在 9 月 19 日(台灣時間)發表 AlloyDB 與 Cloud SQL 的原生 BM25 索引,目前是預覽版:
- 適用 AlloyDB,以及 Cloud SQL for PostgreSQL 17 以上
- 底層是 Tiger Data 開源的 pg_textsearch 擴充套件
- 關鍵字索引和向量索引可以建在同一張表上,不用再把資料複製到另一套搜尋系統
- AlloyDB 搭配 ScaNN、HNSW 向量索引,官方說向量查詢比標準 PostgreSQL 最多快 6 倍與 10 倍
跟以前比差在哪?
PostgreSQL 內建的 ts_rank 也能做全文檢索,但官方點出幾個問題:
| 類別 | 內建 ts_rank | BM25 |
|---|---|---|
| 罕見詞加權 | 沒有,常見字和罕見字一樣重 | 有,罕見詞更重要 |
| 重複詞 | 提到 50 次就容易排很前面 | 重複次數的影響有上限 |
| 資料量變大 | 排序品質下降 | 官方稱它是資訊檢索的標準做法 |
給開發者的技術細節
建立 BM25 索引與查詢的方式(改寫自官方範例):
CREATE EXTENSION pg_textsearch;

CREATE INDEX idx_products_bm25
ON products
USING bm25 (description)
WITH (text_config='english');

SELECT name, description <@> 'cherry tree' AS score
FROM products
ORDER BY score
LIMIT 5;
- 查詢用
<@>運算子,分數越負代表越相關,所以是由小到大排序 - AlloyDB 有內建的
ai.hybrid_search()函式,用 RRF(倒數排名融合)把向量與關鍵字結果合成一份清單 - Cloud SQL 沒有這個函式,官方示範用 CTE 各查一次,再自己算 RRF 分數合併
- 官方範例都用
text_config='english',中文斷詞的效果文章沒有說明,處理中文內容前一定要先測
我的看法
接案做電商或內部系統時,「搜尋」幾乎是必備功能,但規模不大的專案為了搜尋另外架 Elasticsearch,維護成本常常比功能本身還高。能在原本的資料庫裡直接做 BM25,對小團隊來說是很實在的簡化。
不過有兩點要保守看待:一是目前還是預覽版,不建議直接上正式環境;二是台灣的專案大多是中文內容,官方範例全是英文,中文要怎麼切詞、效果如何,現階段只能自己實測。如果你的客戶需要搜「料號」「型號」,這功能倒是很值得先試。
名詞小辭典
- BM25:搜尋引擎常用的關鍵字相關性排序方法,會考慮詞的稀有度、出現次數與文件長度。
- 向量搜尋:把文字轉成一串數字(向量),用「意思相近」來找資料,是 AI 搜尋的基礎。
- RAG:讓 AI 回答前先去資料庫找相關資料,再根據找到的內容回答。
- 擴充套件(Extension):PostgreSQL 的外掛功能,安裝後就能使用新的索引或函式。
資料來源
常見問題
BM25 和 PostgreSQL 原本的全文檢索差在哪?
PostgreSQL 內建的 ts_rank 在資料量變大時排序品質會下降:常見字和罕見字權重一樣,一個詞出現很多次的文件也容易被排到前面。BM25 會讓罕見詞更重要、限制重複字的影響,還會考慮文件長度,排序結果比較接近一般人對「相關」的感覺。
為什麼有了 AI 向量搜尋,還需要關鍵字搜尋?
向量搜尋擅長理解意思,例如「比房子還高的樹」;但遇到商品型號、料號這種一字不差的字串就容易失準。兩種一起用(混合搜尋),才能兼顧「懂意思」和「找得準」。
我用的是自己架的 PostgreSQL,也能用嗎?
pg_textsearch 是 Tiger Data 的開源擴充套件,這篇公告講的是 AlloyDB 與 Cloud SQL 的整合。自架環境能不能裝、相容哪些版本,要以 pg_textsearch 專案本身的說明為準,官方公告沒有涵蓋。
接著讀
全部觀點 →Firestore 內建全文搜尋與地理搜尋正式上線:找關鍵字、找附近店家,不用另外架搜尋服務Google Cloud 的 Firestore 全文搜尋與地理搜尋在 10 月 19 日轉為正式版。在 Enterprise 版資料庫建好索引後,就能直接查關鍵字、排除字詞,或找出某個座標方圓幾公尺內的資料。閱讀 →BigQuery 的 AI 函式可以設每日 token 上限了:一行 SQL 燒掉整月預算的風險變小Google 宣布 BigQuery 生成式 AI 函式的 token 配額正式上線,可以替整個專案或每位使用者設每日的輸入、輸出 token 上限,調低立即生效,避免一次查詢就把預算燒光。閱讀 →Google Cloud 預算終於能「踩煞車」:Gemini API、Cloud Run 花超過上限就自動暫停Google Cloud 的支出上限預算正式上線:替 Gemini API、Cloud Run 等服務設一個月預算,估計花費超過就自動暫停新請求,下個月一號自動恢復。以前的預算只會寄信提醒,帳單爆掉也擋不住。閱讀 →