觀點 · 資訊分享
不想讓網站內容拿去訓練 AI?OpenAI 宣布支援 robots.txt 共用標記,一組規則告訴多家 AI
OpenAI 宣布未來幾個月內會遵守一個寫在 robots.txt 的共用標記,網站主只要寫一組規則,就能同時告訴多家 AI 廠商「這些內容不要拿去訓練」,不必再逐一列出每家的爬蟲名稱。
- 發布
- 2026-10-31
- 篇幅
- 約 4 分鐘 · 1,915 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
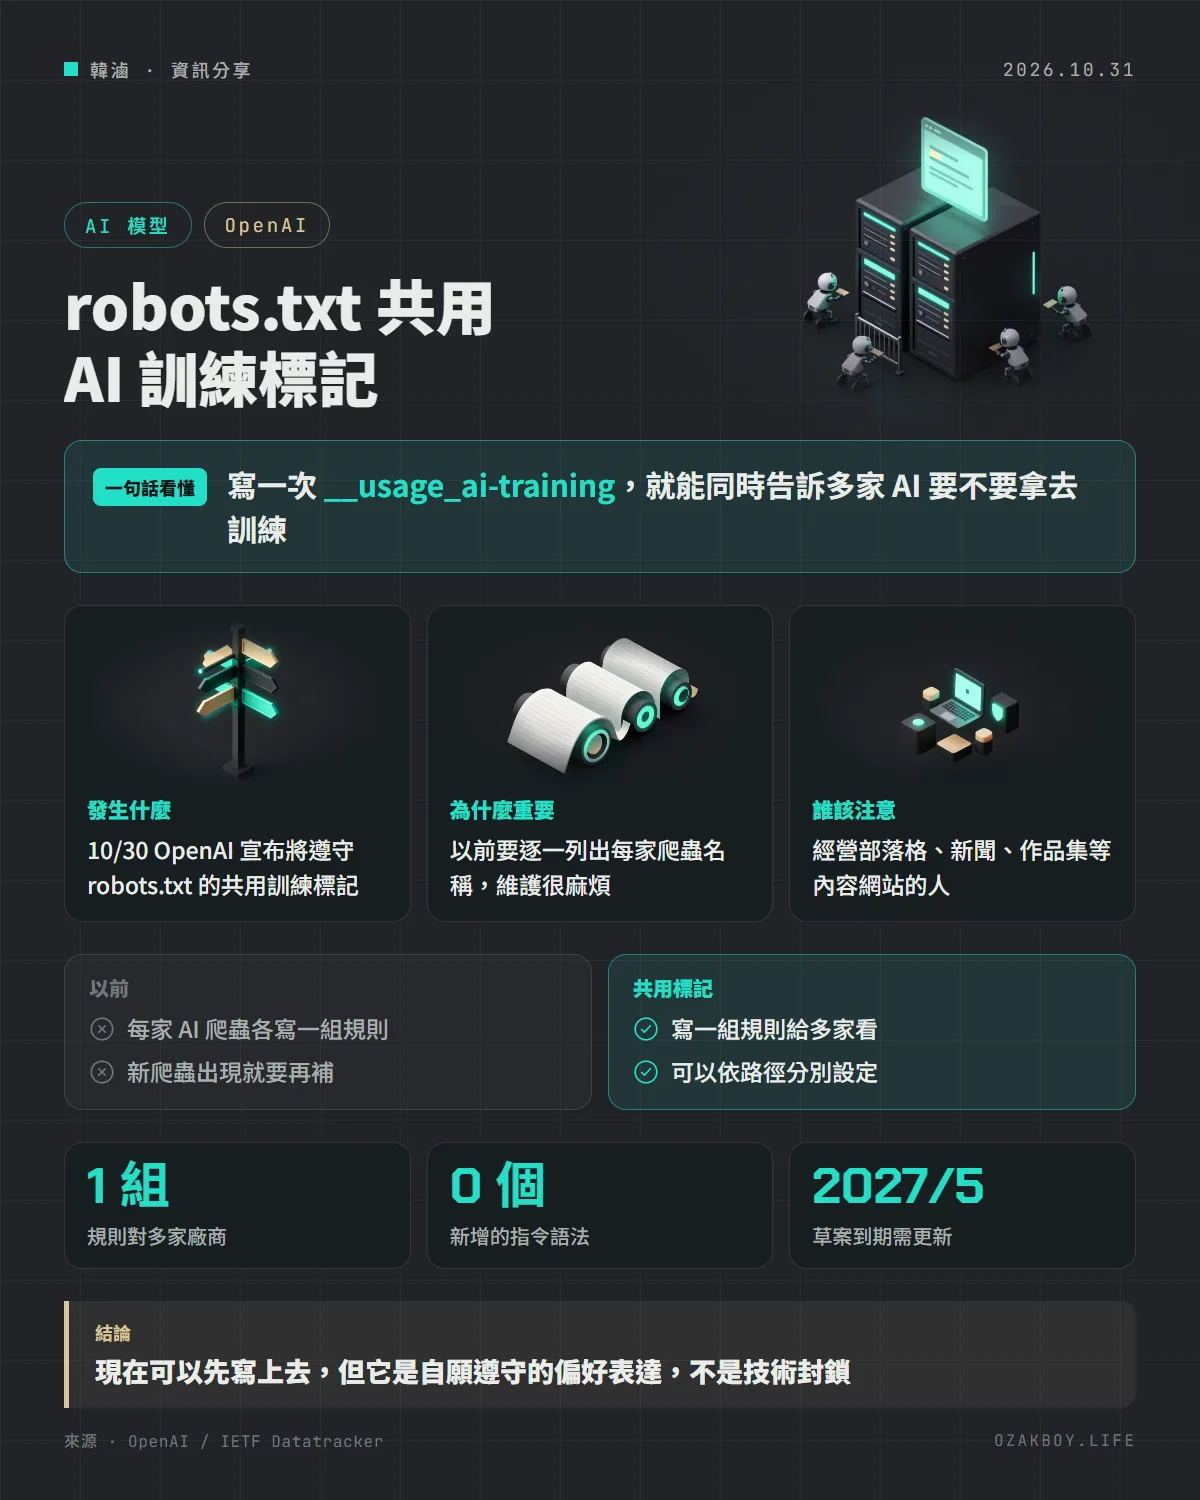
一句話看懂:OpenAI 宣布會遵守一個寫在 robots.txt 的共用標記,網站主寫一組規則,就能同時告訴多家 AI 廠商「這些內容不要拿去訓練」。
先用白話講:robots.txt 是什麼?
想像你家門口貼了一張告示:「推銷員請勿進入,送信的可以」。這張告示沒有鎖,真的要闖還是闖得進來,但守規矩的人看到就會照做。
robots.txt 就是網站門口的這張告示,放在網站根目錄,告訴各種自動化程式(爬蟲)哪些頁面可以抓、哪些不要。
過去幾年,AI 廠商紛紛推出自己的爬蟲,想擋 AI 訓練的網站主只好在告示上逐一寫「A 公司的爬蟲請勿進入」「B 公司的也是」……廠商越來越多,告示就越寫越長,還常常漏掉新出現的那一家。
發生什麼事
OpenAI 在 10 月 30 日發布公告:
- 將遵守 robots.txt 裡一個共用的 AI 訓練偏好標記,讓網站主一次對多家參與的廠商表達同樣的偏好
- 預計在未來幾個月內實作,屆時會再公布實作細節
- 這個標記不會取代 OpenAI 現有的爬蟲控制規則,原本的設定照樣有效
- 這項做法來自 IETF「AI Preferences」工作小組的討論,OpenAI 表示是和工作小組其他參與者一起宣布,也鼓勵其他 AI 廠商跟進
公告連結的規格是同日更新的 IETF 個人草案《Machine-Readable Training Preference Signal》,作者所屬單位標示為 Anthropic。
標記怎麼寫?
草案的核心很簡單:拿一個特殊名稱 __usage_ai-training 當作 User-Agent,底下沿用原本的 Disallow / Allow 規則。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
上面這段的意思是:整個網站都不希望被拿去訓練生成式 AI,只有 /press-kit/ 底下的內容可以。
| 情況 | 草案的解讀 |
|---|---|
| 路徑被 Disallow | 表達「反對」拿去訓練 |
| 路徑被 Allow | 表達「同意」拿去訓練 |
| 檔案裡沒有這個名稱 | 視為沒有表達偏好 |
只有 User-Agent: * |
不能當成符合這個標記 |
給開發者的技術細節
- 不新增語法:沒有新的指令名稱,路徑規則與最長比對優先的原則都跟 RFC 9309 一樣,舊的解析器會把它當成不認識的爬蟲直接忽略
- 不是爬取指令:草案寫明這個標記表達的是「內容用途」偏好,和「能不能爬」是兩件事;要限制爬取,仍要針對各家爬蟲名稱寫規則
- 訓練的定義:沿用工作小組的詞彙草案,指「用內容來修改生成式 AI 模型的參數」;只做分類、排序、評分的模型不算
- 優先順序:較具體的規則優先;廠商可以聲明自家專屬的名稱比共用標記更具體,私下簽的授權協議也可以凌駕這個偏好
- 草案狀態:目前是個人提交的 Internet-Draft,不代表 IETF 已經認可,到期日為 2027 年 5 月 3 日,內容可能還會修改
我的看法
幫客戶做形象網站、部落格時,常被問「能不能不要讓 AI 拿我的文章去訓練」。以前的答案很瑣碎:要去查每家 AI 爬蟲叫什麼名字、寫一長串規則,還要定期回頭補。共用標記如果真的被多家採用,維護成本會低很多。
但要講清楚兩件事:第一,這只是偏好表達,遵守與否靠廠商自律,不是防火牆;真的在意的話,伺服器端或 CDN 的爬蟲阻擋還是要做。第二,OpenAI 說的是「未來幾個月」才實作,目前寫上去不會立刻有效果。我的建議是可以先把這三行加進 robots.txt,原本針對各家爬蟲的規則也先留著,等各家正式公布實作再調整。
名詞小辭典
- robots.txt:放在網站根目錄的純文字檔,告訴爬蟲哪些頁面可以抓、哪些不要,屬於君子協定。
- 爬蟲(Crawler):自動瀏覽網頁、抓取內容的程式,搜尋引擎和 AI 廠商都會用。
- IETF:制定網際網路標準的國際組織,HTTP、robots.txt 規範(RFC 9309)都出自這裡。
- Internet-Draft:提交給 IETF 討論中的文件草稿,有效期最長 6 個月,可能被修改或取代。