觀點 · 資訊分享
OpenAI 推出 GPT-6.1 Terra:主打看圖與操作電腦,API 輸入 1 美元、輸出 5 美元,只有 Sol 一半
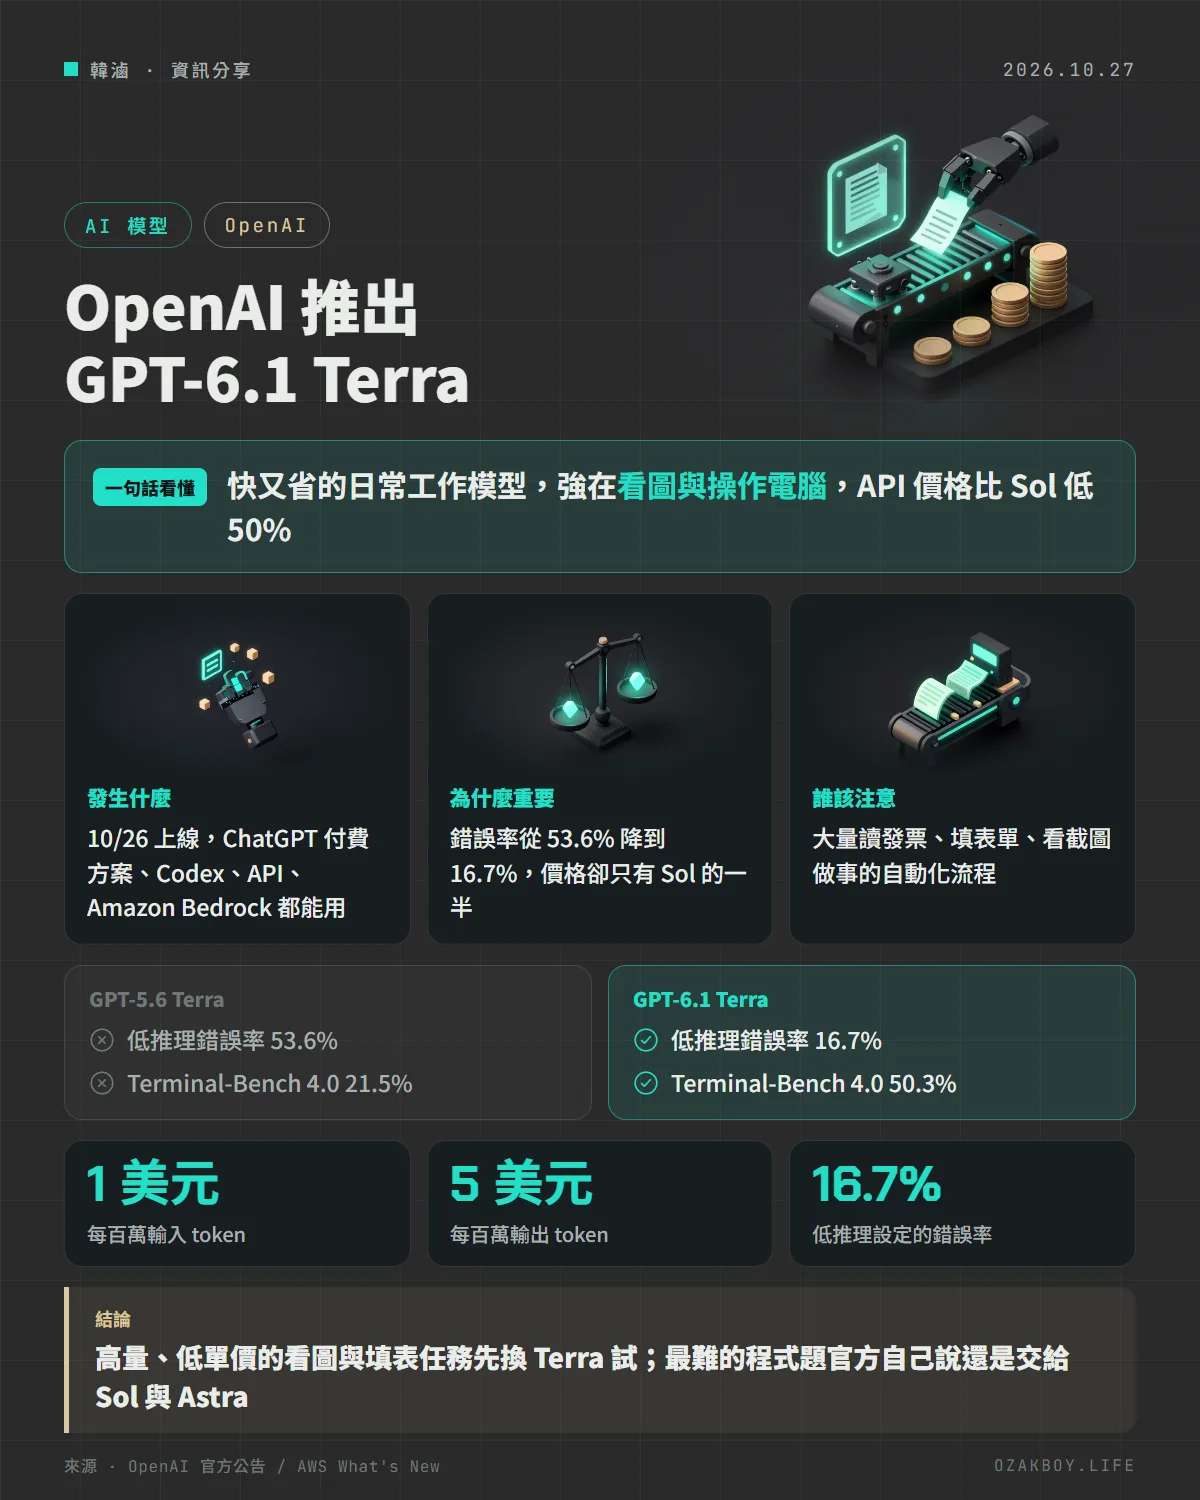
OpenAI 在 10 月 26 日推出 GPT-6.1 Terra,定位是快又省的日常工作模型,強在視覺理解與操作電腦。API 每百萬 token 輸入 1 美元、快取輸入 0.05 美元、輸出 5 美元,比 GPT-5.6 Terra 與 GPT-6.1 Sol 低 50%,同日上架 Amazon Bedrock。
- 發布
- 2026-10-27
- 篇幅
- 約 5 分鐘 · 2,192 字
- 結構
- 7 節 + 5 題常見問題
- 標籤
一句話看懂:OpenAI 在 10 月 26 日推出 GPT-6.1 Terra,一款快又省、強在看圖與操作電腦的日常工作模型;API 每百萬 token 輸入 1 美元、輸出 5 美元,比 GPT-5.6 Terra 與 GPT-6.1 Sol 便宜一半,同日也上架 Amazon Bedrock。
先用白話講:Terra 是哪一種模型?
OpenAI 的 GPT-6 系列像一家公司的不同職級:Astra 是最資深的旗艦,Sol 是高階,Terra 則是那個動作快、薪水低、每天幫你處理大量雜事的同事。這次的 GPT-6.1 Terra 就是這個「雜事同事」的新版本。
它的特長不是解最難的數學題,而是看懂畫面、然後動手:讀一張發票並把金額填進會計系統、看工程圖、填表單、按照截圖操作軟體。這類工作量大、單價低,模型便宜與否直接決定能不能大規模自動化。
發生什麼事
- 10 月 26 日,OpenAI 發表 GPT-6.1 Terra,接替 GPT-5.6 Terra
- API 標準價:每百萬 token 輸入 1 美元、快取輸入 0.05 美元、輸出 5 美元,官方說比 GPT-5.6 Terra 與 GPT-6.1 Sol 低 50%;模型名稱
gpt-6.1-terra - ChatGPT:Plus、Pro、Enterprise、Edu 方案在 ChatGPT Work 與 Codex 當天可用,同樣的用量額度能做更多任務
- AWS 同日公告:GPT-6.1 Terra 在 Amazon Bedrock 正式可用
官方給的成績單
| 測試 | GPT-5.6 Terra | GPT-6.1 Terra |
|---|---|---|
| 事實錯誤率(低推理) | 53.6% | 16.7% |
| 事實錯誤率(最高推理) | 降 18 個百分點後 | 4.3% |
| Terminal-Bench 4.0(最高推理) | 21.5% | 50.3% |
| Agents’ Last Exam(中等推理) | 基準 | 高 15 個百分點,成本約三分之一 |
其他官方說法:
- 在 Agents’ Last Exam 上與 GPT-6 Astra 持平,但每 token 價格只有 Astra 的十分之一
- 最高推理設定下,token 效率是 Claude Opus 5.5 的三倍以上、每 token 價格四分之一,換算成每項任務成本約低 9 倍(這是 OpenAI 自己的估算)
- 完成任務的速度比 GPT-6 Astra 與 GPT-6.1 Sol 快三倍以上
- 視覺推理 MMMU-Pro 在每個推理設定都勝過 GPT-5.6 Terra;桌面操作 OSWorld 2.1 在中等推理就超過 GPT-5.6 Terra 的最佳成績
官方也坦白寫了:最複雜的程式任務,GPT-6.1 Sol 與 GPT-6 Astra 仍是更好的選擇。
給開發者的技術細節
- API 模型 ID:
gpt-6.1-terra - 價格是「標準」費率,快取輸入 0.05 美元是輸入價的二十分之一,重複前綴多的批次任務特別划算
- 安全:官方表示它在 Preparedness Framework 的網路安全類別達到 Critical 門檻,沿用 GPT-6 Astra 的防護;提示詞注入測試中對「把模型帶離使用者任務」的惡意指令有較強抵抗力,細節在系統卡補遺
- 行為面:官方評估它比 GPT-5.6 Terra 更會守在任務範圍內、更會老實說出做不到的地方與卡關點
- 不想自己管 OpenAI 帳號的 AWS 使用者,可直接從 Bedrock 呼叫,區域與價格以 Bedrock 文件為準
我的看法
接案時最常被問的不是「哪個模型最聰明」,而是「這個流程全部自動化要花多少錢」。讀發票、對帳單、填後台表單這類事,一天幾千筆,模型單價差一倍就是一倍的成本。Terra 這一代把價格壓到輸入 1 美元、輸出 5 美元,又主打看圖與操作畫面,正好打在這個需求上。
我的做法會是:先拿既有流程裡最無聊、量最大的那一段換成 Terra 跑一週,看錯誤率與人工補救的時間,再決定要不要全面換。至於核心邏輯、難題拆解,照官方自己的說法,還是留給 Sol 或 Astra。另外提醒,評測數字都是 OpenAI 自己量的,跟 Opus 5.5 的比較也是它的估算,實際表現要在自己的資料上測。
名詞小辭典
- token:模型計價與處理文字的最小單位,中文大約一到兩個字算一個 token。
- 快取輸入(cached input):同一段前綴重複送進模型時,命中快取的部分用更低價計費。
- 電腦操作(computer use):模型看畫面截圖、自己點按鍵盤滑鼠完成任務的能力。
- Preparedness Framework:OpenAI 用來評估模型在生化、網路安全等高風險領域能力等級的內部框架。