觀點 · 資訊分享
Google Cloud Z4M 儲存型主機正式推出:一台接 168,000 GiB 本機 SSD,讀取比上一代快最多 70%
Google Cloud 推出專給 AI 訓練存檔、平行檔案系統用的 Z4M 主機:本機 SSD 最多 168,000 GiB,配 400 Gbps RDMA 網路,官方說延遲比 TCP 最多少 60%。
- 發布
- 2026-11-08
- 篇幅
- 約 4 分鐘 · 1,655 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
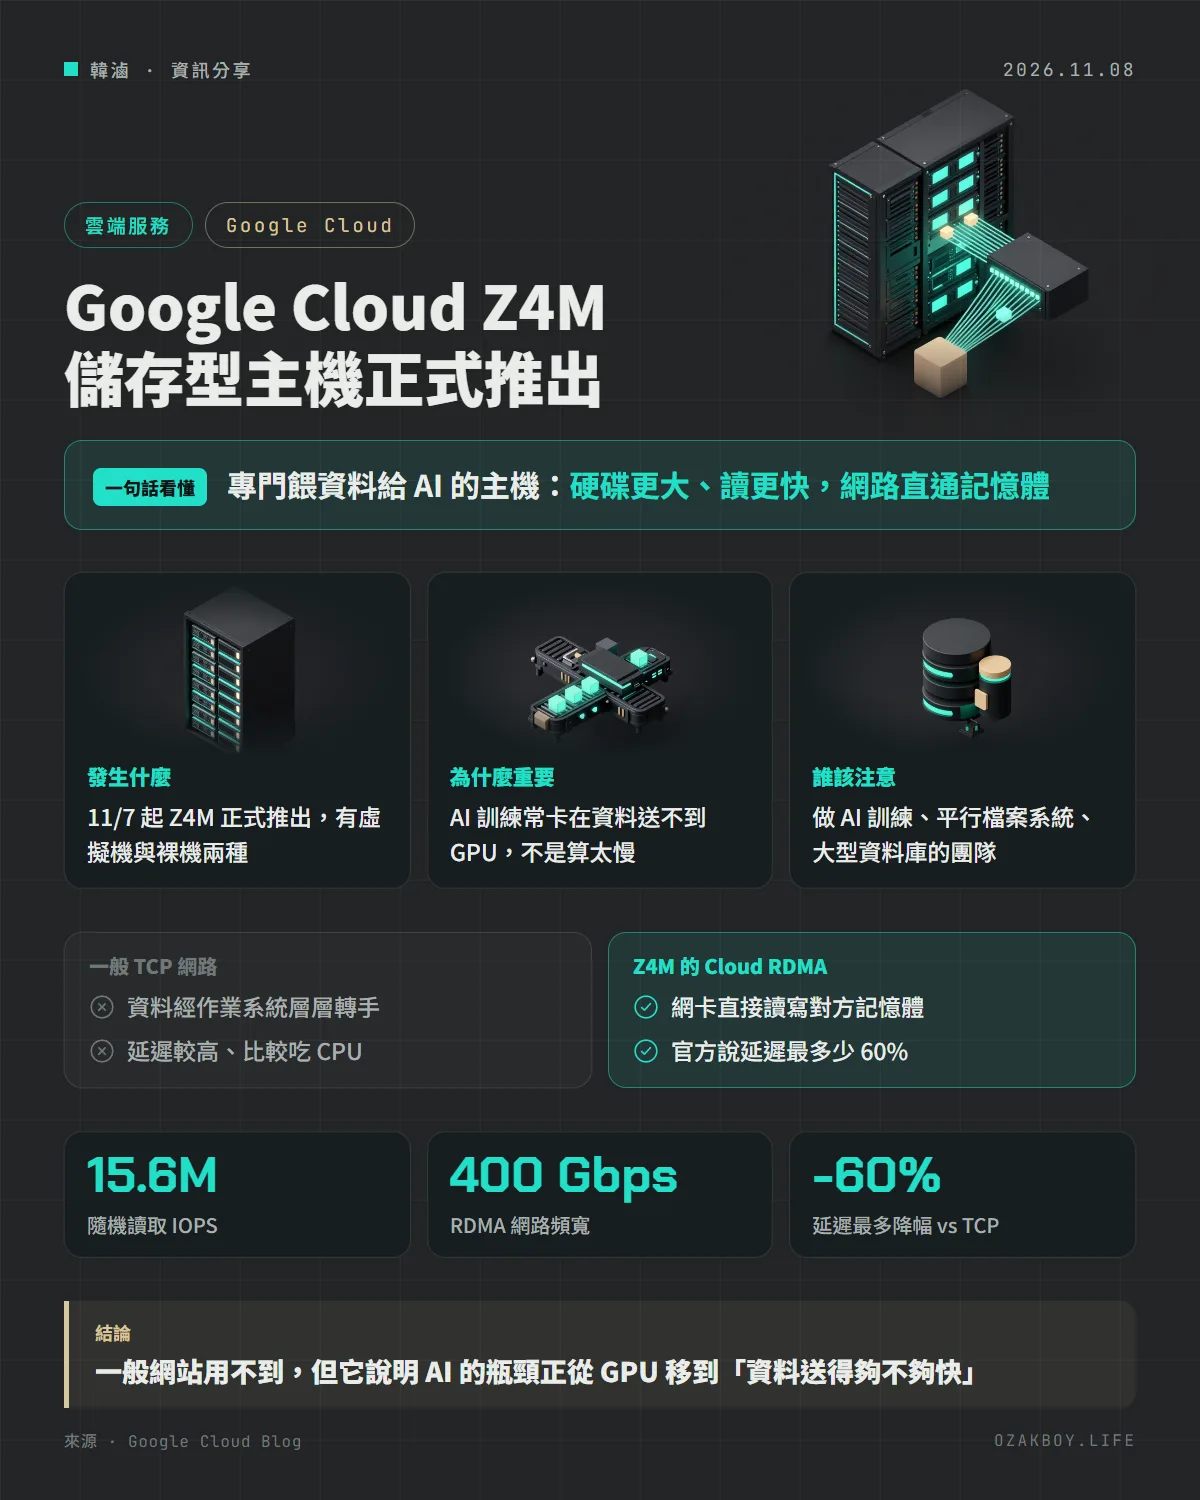
一句話看懂:Google Cloud 推出 Z4M 儲存型主機,一台最多接 168,000 GiB 本機 SSD、配 400 Gbps 的 RDMA 網路,目標是讓 AI 訓練用的 GPU、TPU 不再等資料。
先用白話講:儲存型主機是什麼?
雲端主機大致分成幾種:有的 CPU 特別多,適合拚命計算;有的記憶體特別大,適合把大量資料放在手邊;儲存型主機則是硬碟特別大、特別快。
想像一間餐廳的廚房:GPU 是手腳很快的廚師,但如果食材從倉庫送來太慢,廚師只能站著等。儲存型主機就像蓋在廚房旁邊的大冰箱,再加一條專用輸送帶,讓食材(訓練資料、模型存檔)不斷送到廚師手上。
發生什麼事
Google Cloud 在 11 月 7 日的官方部落格宣布,Compute Engine 的 Z4M 系列正式推出(GA),有一般虛擬機與裸機(bare metal)兩種。官方列出的重點規格:
- 處理器:第五代 Intel Xeon Scalable
- 最多 192 vCPU、1,536 GiB 記憶體
- 本機 SSD 最多 168,000 GiB,平均每個 vCPU 配 875 GiB
- 隨機讀取最高 1,560 萬 IOPS、循序讀取最高 75,600 MiB/s,比上一代 Z3 分別提升最多 70% 與 110%
- 400 Gbps 的 Cloud RDMA 網路,官方說資料存取延遲比 TCP 最多少 60%
目前在「全球部分區域」提供,官方文章沒有列出區域清單,也沒有寫價格。
主要用在哪裡
| 用途 | 例子 | Z4M 的強項 |
|---|---|---|
| AI 訓練與推論 | 訓練中途存檔(checkpoint)、分散式 KV 快取 | 大容量本機 SSD 加 RDMA,GPU、TPU 不用等資料 |
| 平行檔案系統 | Weka、Sycomp、Silk、VDURA | 在本機處理資料,同時用滿網路頻寬傳給用戶端 |
| 企業資料庫 | SQL、NoSQL、向量資料庫 | 長時間維持高讀寫效能 |
給開發者的技術細節
- 建立 VM 或 GKE 節點集區時,在「儲存最佳化」機器系列選 Z4M 即可
- 支援 NVIDIA GPUDirect Storage 與 TPUDirect Storage,資料可以直接送進加速器
- 也能掛 Hyperdisk(Balanced、Throughput、Extreme),每台最多 512 TiB;Hyperdisk Extreme 每台最高 50 萬 IOPS
- 維護方式要先搞懂:本機 SSD 在 42,000 GiB 以下的 VM 可以熱遷移;84,000 GiB 以上的 VM 與裸機遇到計畫性維護時必須關機重啟(資料會保留),系統會提前幾天通知
- 可以用 Cluster Director 管理大型叢集,選擇緊密排列(拚效能)或分散到不同可用網域(拚可用性)
我的看法
老實說,Z4M 這種等級的機器,一般接案做的中小企業網站完全用不到:一台就有 192 vCPU,價格想必不便宜(官方文章沒寫)。但它透露一個趨勢:AI 訓練的瓶頸已經不只在 GPU,而是「資料能不能及時送到 GPU 手上」,雲端廠商開始把儲存和網路當成 AI 基礎設施的主角來設計。
對小團隊或自架玩家來說,比較實際的啟示是:在 NAS 或家用主機跑本地模型時,模型檔放在 SSD 還是傳統硬碟、內網速度夠不夠,對載入時間的影響可能比想像中大。升級顯卡之前,先看看資料路徑是不是卡住了。
名詞小辭典
- IOPS:每秒能完成幾次讀寫動作,數字越大,處理大量小檔案越快。
- RDMA:遠端直接記憶體存取,讓一台機器直接讀寫另一台的記憶體,不用作業系統層層轉手,所以延遲低、也比較不吃 CPU。
- 本機 SSD(Local SSD):直接裝在主機上的固態硬碟,速度比透過網路掛載的雲端硬碟快。
- 裸機(Bare metal):沒有虛擬化層,直接使用整台實體機器。