觀點 · 資訊分享
Ollama 0.40.16 上架 65B 寫程式模型 Ripple Preview:Apache 2.0 可商用,檔案 39~46GB
Ollama 0.40.16 把 Ricursive Intelligence 的 65B 寫程式模型 Ripple Preview 收進模型庫,一行指令就能下載到自己的電腦跑。同一版還讓 Qwen3.8 Flash Next 在 Apple 晶片上少用約 27 GiB 記憶體。
- 發布
- 2026-11-10
- 篇幅
- 約 4 分鐘 · 1,684 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
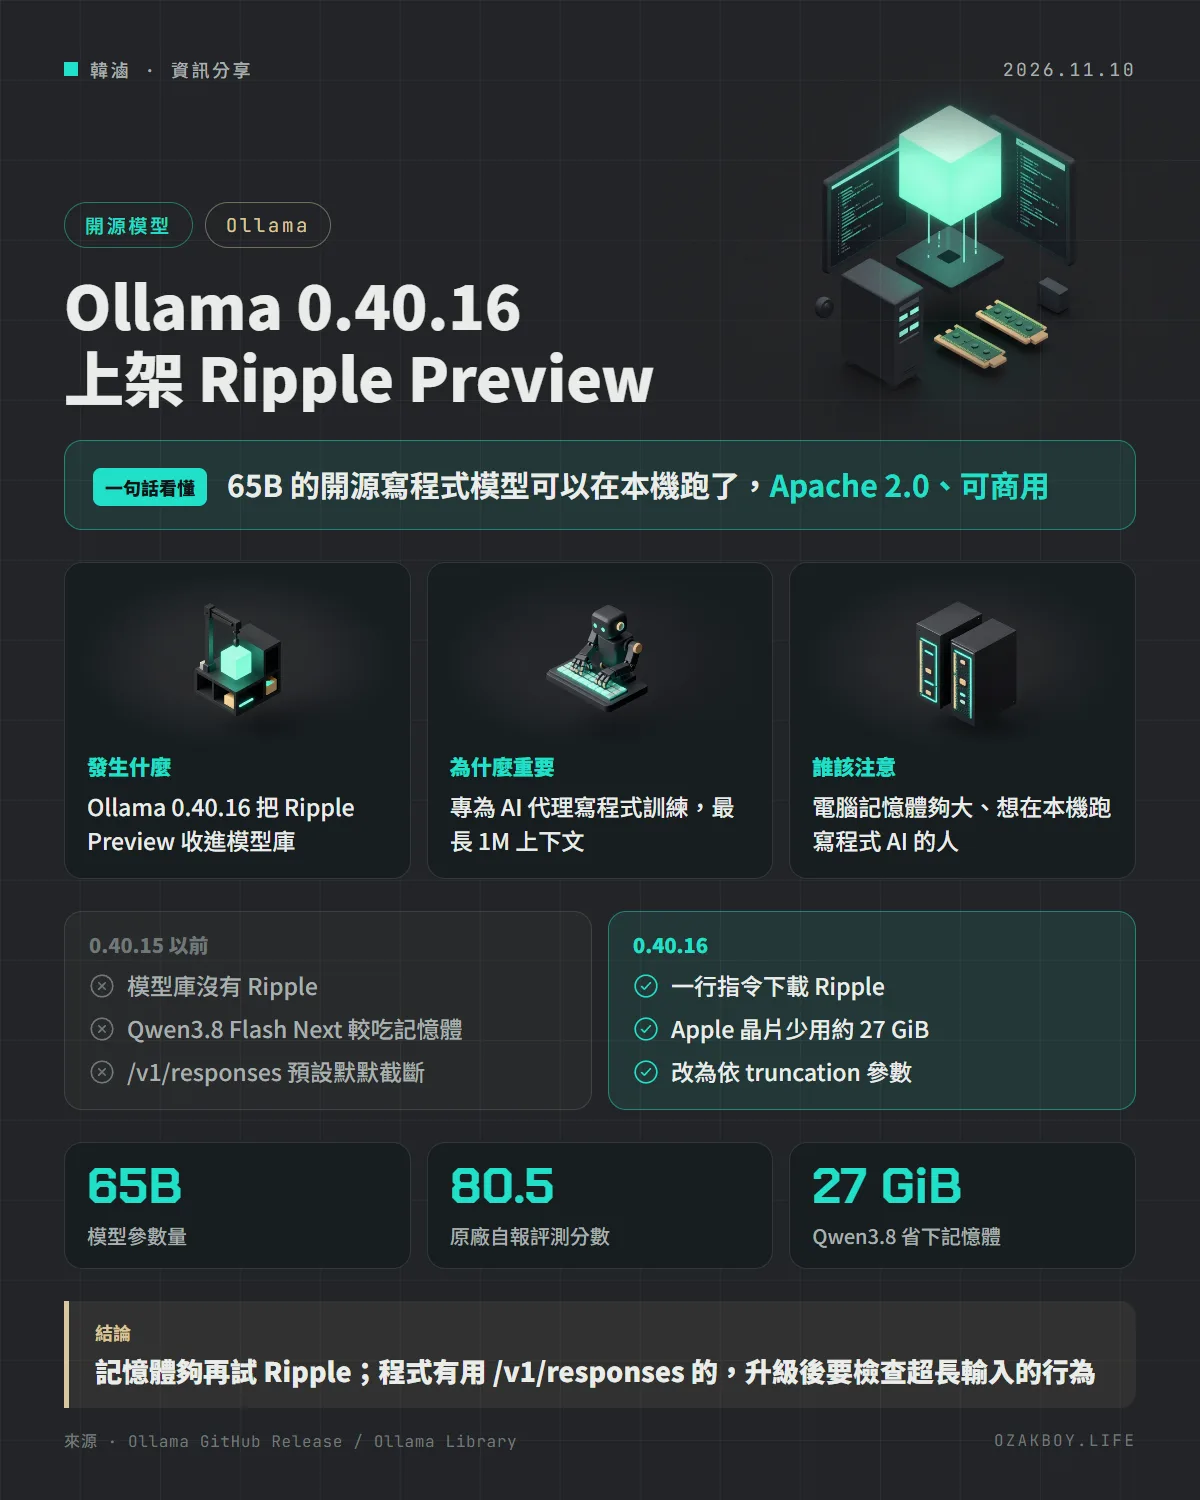
一句話看懂:Ollama 0.40.16 把 65B 的開源寫程式模型 Ripple Preview 收進模型庫,一行指令就能下載到自己電腦跑,而且可以商用。
先用白話講:Ollama 和 Ripple Preview 是什麼?
Ollama 像是「AI 模型的 App 商店」:你打一行指令,它就把模型下載到你的電腦,之後不用連上別人的伺服器也能用,資料不會離開自己的機器。
Ripple Preview 是這次新上架的模型,由 Ricursive Intelligence 推出。它的專長是「代理式寫程式」:不只是回答問題,而是像工程師一樣,在終端機裡一步一步下指令、改檔案、把任務做完。
名字裡的 65B 指的是它有 650 億個參數。參數可以想成模型腦袋裡的旋鈕,數量越多通常越聰明,但也越吃記憶體。
發生什麼事
Ollama 在美國時間 11 月 9 日(台灣時間 11 月 10 日凌晨)發布 v0.40.16,主角是 Ripple Preview。依 Ollama 模型頁的說明:
- 65B dense 模型:每處理一個 token,全部參數都會參與運算
- 最長 1M tokens 上下文:足以放進大型程式庫與很長的代理工作階段
- Apache 2.0 授權:允許商業使用
- 原廠自報成績:Terminal-Bench 2.1 拿到 80.5 分
- 檔案大小:39GB~46GB
同一版還改了什麼
| 項目 | 變化 |
|---|---|
| Qwen3.8 Flash Next | 在 Apple 晶片上少用約 27 GiB 記憶體 |
ollama launch claude |
一律把 Claude Code 導向你選的模型 |
ollama launch |
雲端模型下架時會說明原因 |
/v1/responses |
依 truncation 參數處理,不再預設默默截斷 |
/v1/models |
沒裝模型時回空清單,不再回 null |
| Windows on ARM | 支援 CUDA 13.5 |
給開發者的技術細節
下載並執行:
ollama run ripple-preview
想直接接到寫程式工具,模型頁列的用法是:
ollama launch claude --model ripple-preview
- 上下文長度要留意:模型頁的文字說明寫最長 1M tokens,但同一頁的模型列表欄位顯示 2M,兩處不一致,本文採用文字說明的 1M
- 加速方式:在 Ollama 的 MLX 引擎上,Ripple 會用 DFlash 2 推測解碼加快生成
/v1/responses行為改變:以前超長輸入會被默默截掉,現在改看truncation參數。發布說明沒有寫超長時會回什麼,升級後請自己測一次/v1/models回傳型別改變:程式如果有判斷null,要改成判斷空陣列
我的看法
對自架本地 AI 的人來說,這則新聞要分兩半看。
Ripple Preview 很吸引人:開源、可商用、專門練寫程式。但 39GB~46GB 的檔案代表它不是一般電腦玩得起的,手上的機器記憶體不夠就先別下載,省得白等。80.5 分也是原廠自己公布的,我會等社群的實測出來,再拿自己的專案試。
比較實際的反而是那幾條小修正。接案時如果用 Ollama 的 OpenAI 相容介面做客戶的系統,/v1/responses 不再默默截斷是好事——以前輸入被截掉,模型答非所問卻查不出原因;現在行為明確了,但升級後一定要拿長輸入測一次,確認程式的錯誤處理有接住。
名詞小辭典
- 參數(Parameter):模型內部用來計算的數值,65B 就是 650 億個。
- Dense 模型:每次運算都動用全部參數的模型;相對的做法是每次只啟用其中一部分。
- 上下文(Context):模型一次能「看到」的文字量,越長就能讀進越多程式碼。
- 代理式寫程式(Agentic coding):讓 AI 自己規劃步驟、執行指令、修改檔案來完成任務,而不只是給建議。