觀點 · 資訊分享
Flint 開源程式模型上架 Ollama:約 400 億參數、每次只動 25 億,Apache 2.0 授權
Recursive 的開源程式模型 Flint 在 10 月 21 日登上 Ollama,一行指令就能在自己電腦跑。它是混合專家架構,總共約 400 億參數,處理每個 token 只動用約 25 億,下載大小 23GB。
- 發布
- 2026-10-22
- 篇幅
- 約 4 分鐘 · 2,013 字
- 結構
- 8 節 + 4 題常見問題
- 標籤
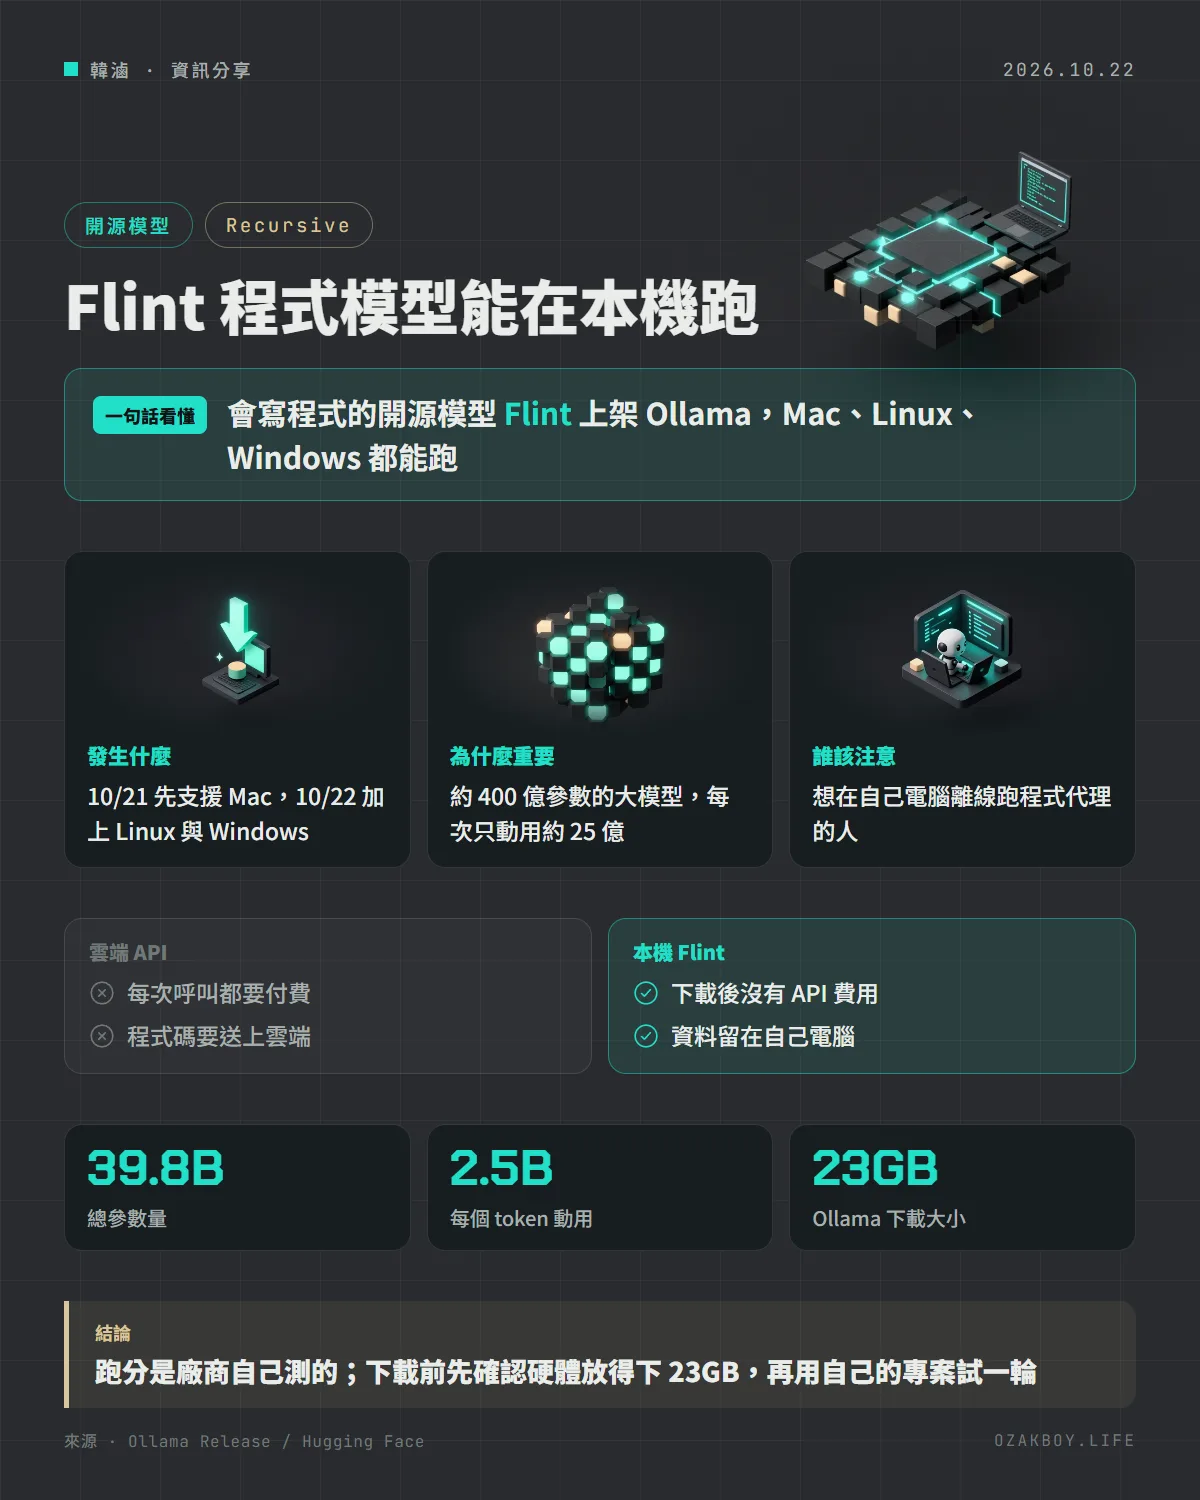
一句話看懂:Recursive 的開源程式模型 Flint 登上 Ollama,約 400 億參數卻只動用約 25 億,Mac、Linux、Windows 都能在自己電腦跑。
先用白話講:Flint 是什麼?
想像一間有 256 位專家的顧問公司:有人懂資料庫、有人懂前端、有人懂除錯。每次客戶丟來一個問題,公司不會叫全部專家開會,只挑最相關的 6 位出面,其他人休息。公司很大,但每次的人力成本很小。
Flint 就是這種模型。它是新創公司 Recursive 做的混合專家(Mixture of Experts,MoE)語言模型,專門給寫程式的 AI 代理用:讀懂陌生專案、追蹤 bug、實作功能、補上測試。
發生什麼事
- 10 月 21 日:Ollama 0.40.8 版加入 Flint,一開始只支援 macOS
- 10 月 22 日:Ollama 0.40.9 版宣布 Flint 也能在 Linux 和 Windows 上執行
- 授權是 Apache 2.0,可以自由下載與使用;官方也說明,Recursive 的雲端 API 條款和資料處理方式是另一回事
關鍵數字一次看
| 項目 | 數字 |
|---|---|
| 總參數量 | 39.8B(約 398 億) |
| 每個 token 動用的參數 | 約 2.5B(約 25 億) |
| 專家數量 | 每層 256 位,每次挑 6 位,另有 1 位常駐 |
| 脈絡長度 | 262,144 tokens(Ollama 頁面標為 256K) |
| Ollama 下載大小 | 23GB |
| Terminal-Bench 2.1 | 54.9%(官方自評) |
| SWE-bench Verified | 74.2%(官方自評) |
token 可以想成模型讀寫文字的最小單位,大約是一個字或半個英文單字。
給開發者的技術細節
ollama run flint
- Ollama 模型頁也列出用
ollama launch把 Flint 接到 opencode、Hermes Agent、OpenClaw 等工具的指令,例如ollama launch opencode --model flint - 官方建議的取樣設定是 temperature 1.0、top-p 0.95、top-k 20;困難問題的輸出預算至少 32768 tokens,因為推理過程也算在裡面
- 要自己用 SGLang 跑原始 BF16 版本的話,官方寫明每個副本需要一張 B300 或 H200 GPU,光是下載就約 80GB;量化版是另外提供給 NVIDIA 與 Apple Silicon 的
- 跑分用的是 Terminus 2 與 mini-swe-agent 這類測試環境;官方自己提醒,比較對象的分數多半是各家自行公布,測試設定未必相同
能不能信這些跑分?
模型卡寫得算誠實:Flint 的分數是 Recursive 自己測的,比較對象很多是別人公布的數字,而且 Terminal-Bench 的成績把「靠上網查答案」的解法算失敗,別家未必用同樣標準。換句話說,這些數字能當參考,但不能當成排名。官方還提醒,模型可能寫出有問題的程式,或做出不恰當的工具呼叫,重要的變更要自己審查。
我的看法
對自架服務、又想用本地 AI 的人來說,這類模型的吸引力很直接:程式碼不用離開自己的電腦,也沒有每次呼叫的 API 帳單。混合專家的設計也讓它在「大模型能力」和「跑得動」之間找到一個平衡點。
但我會先冷靜一下。23GB 的下載得先確認自己的機器放得下,而且官方跑分是自己測的,我不會只看數字就換掉現有工具。比較實際的做法是挑一個自己熟悉的小專案,讓它修一個已知的 bug、補一組測試,跟手上的工具比較結果與速度。如果你的接案專案有客戶原始碼不能上雲端的限制,本機模型就值得認真試。還有,Ollama 一開始只支援 macOS、隔天才擴到其他平台,這種新模型的早期版本多半還有些粗糙,晚幾週再試通常比較順。
名詞小辭典
- Ollama:在自己電腦上下載、執行開源 AI 模型的工具,一行指令就能啟動。
- 混合專家(MoE):把模型拆成很多「專家」,每次只啟動少數幾個,所以能同時兼顧能力和速度。
- Apache 2.0:寬鬆的開源授權,允許商用、修改與散布,但要保留授權聲明。
- Terminal-Bench / SWE-bench:測試 AI 能不能在終端機做事、修真實開源專案 bug 的評測集,常用來比較程式代理模型。