觀點 · 資訊分享
Ollama 0.40 在 Mac 上預設改用 MLX:本地跑 Qwen、Gemma 不用再手動切換
本地 AI 工具 Ollama 發布 0.40 版,Apple Silicon 的 Mac 上只要模型架構有支援,就會自動用蘋果的 MLX 框架來跑。3 月預覽時官方測得輸出速度約快 1.9 倍。
- 發布
- 2026-09-25
- 篇幅
- 約 3 分鐘 · 1,499 字
- 結構
- 7 節 + 4 題常見問題
- 標籤
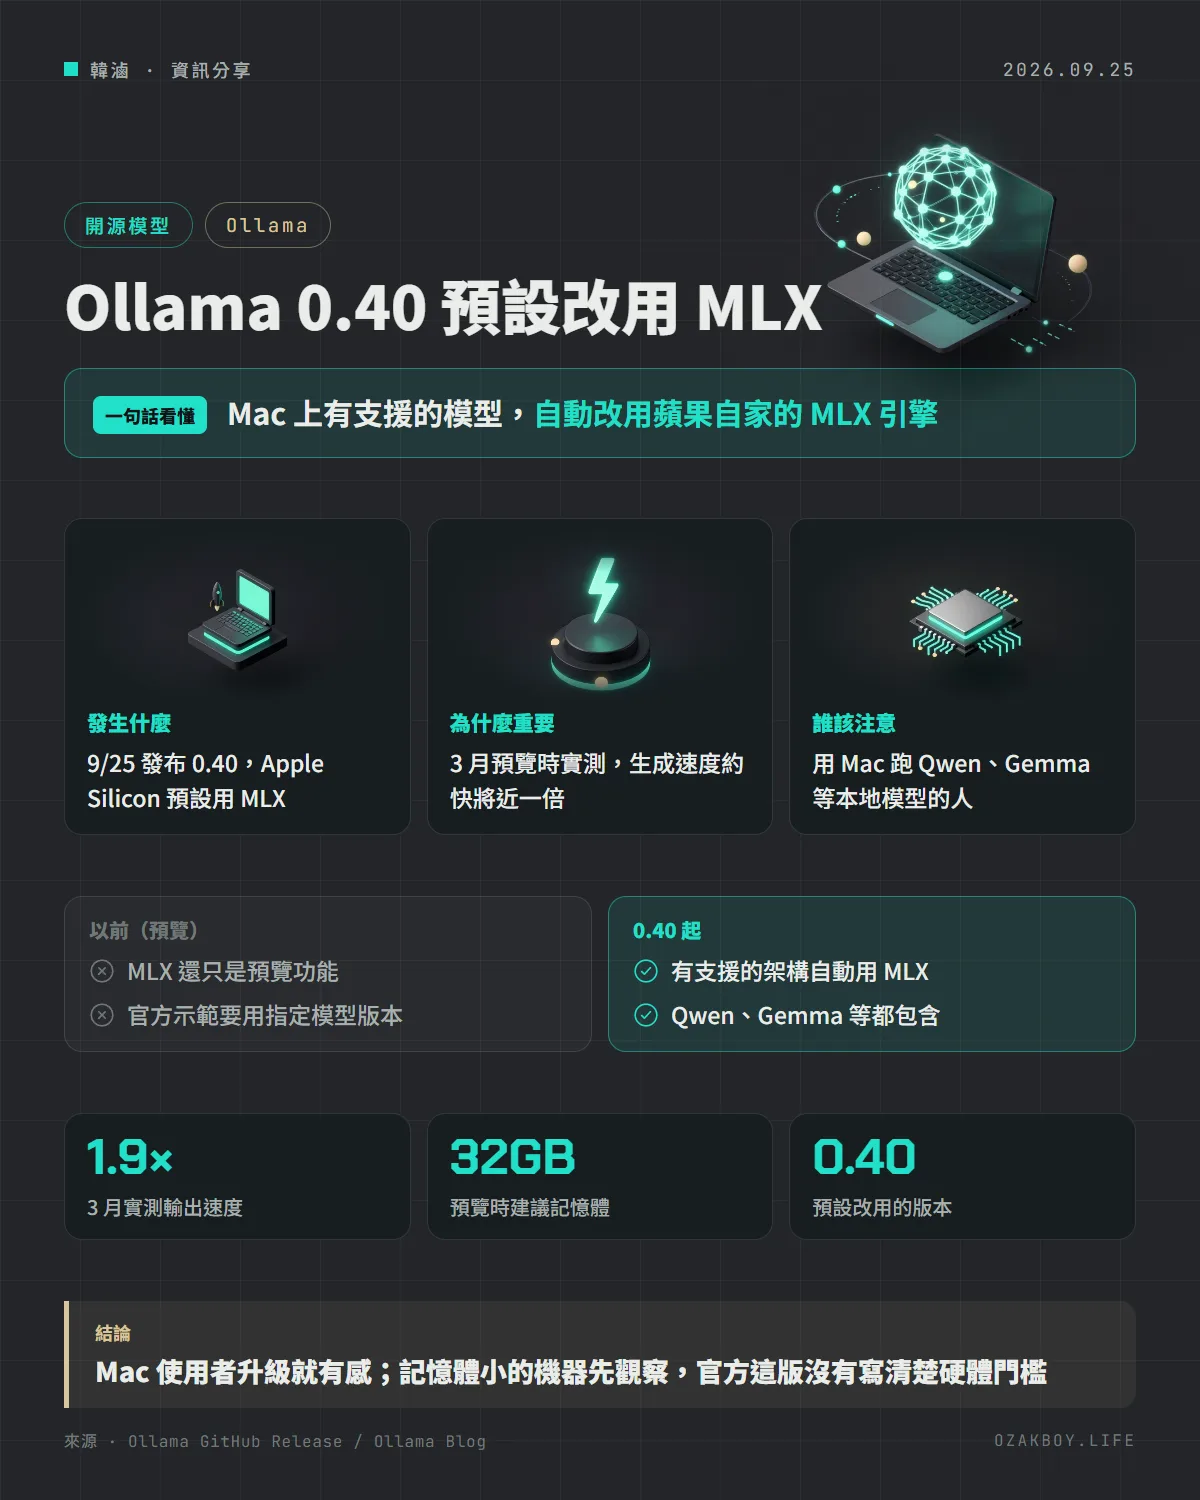
一句話看懂:Ollama 0.40 讓 Mac 上有支援的模型自動改用蘋果的 MLX 引擎執行,本地跑 AI 不用再特別挑版本或手動設定。
先用白話講:Ollama 和 MLX 是什麼?
Ollama 是一個讓你在自己電腦上跑 AI 模型的工具,下一行指令就能把 Qwen、Gemma 這類開源模型下載下來,不必連網路、資料也不會傳出去。
MLX 則是蘋果專門為 M 系列晶片打造的機器學習引擎。打個比方:同一台車(你的 Mac),以前 Ollama 開的是通用的引擎,現在換上原廠專門調校的引擎,同樣的路跑起來更順。
發生什麼事
Ollama 在 9 月 25 日發布 0.40.0,最大的改變是:在 Apple Silicon 上,MLX 有支援的模型架構會自動改用 MLX 執行。
這一版同時擴大了 MLX 的支援範圍:
- 對話模型:Qwen 3.8、Qwen 3.6、Qwen 3.5、Gemma 4
- 決策模型:Nimble、tev1、clef、clef-flash
- 嵌入模型:embeddinggemma-2(拿來做搜尋、RAG 的那種)
官方說會繼續測試、陸續開放更多模型。
會快多少?
0.40 的更新說明沒有附速度數字。比較能參考的是 2026 年 3 月 MLX 剛以預覽形式加入 0.19 版時,官方用 Qwen3.5-35B-A3B 做的測試:
| 指標 | 0.18(舊引擎) | 0.19(MLX 預覽) |
|---|---|---|
| 讀取提示詞(prefill) | 每秒 1,154 token | 每秒 1,810 token |
| 產生回答(decode) | 每秒 58 token | 每秒 112 token |
產生回答的速度大約是 1.9 倍(自行換算:112 ÷ 58)。要注意兩個版本用的量化格式不同(舊版 Q4_K_M、新版 NVFP4),不是完全一樣的比較基準。
給開發者的技術細節
- 用法不變:照常下載、執行即可,例如
ollama pull qwen3.8
ollama run qwen3.8
- 硬體門檻沒寫:0.40 的說明沒有提記憶體需求;3 月預覽時官方寫明需要 32GB 以上的統一記憶體
- 只影響 Mac:這次的預設切換限定 Apple Silicon,Windows 與 Linux 的執行方式沒有提到變動
- 升級後如果某個模型速度或輸出變怪,先確認是不是剛好換到 MLX 執行,再回報給官方
我的看法
在 Windows 加獨立顯卡上跑本地 AI 的人,這次的改動沒有直接影響。但很多接案的工程師手上是 MacBook,以前要在 Mac 上跑得快,得自己去找 MLX 專用的工具或特定模型版本,現在 Ollama 直接幫你切好,門檻低很多。
比較讓我在意的是官方沒寫清楚記憶體門檻。3 月預覽時明講要 32GB 以上,這次變成預設卻沒提,16GB 的 MacBook Air 升級後表現如何還不確定。建議先在不重要的工作上試跑,確認穩定再拿來處理客戶的資料。
名詞小辭典
- Apple Silicon:蘋果自家設計的 M 系列晶片,例如 M3、M4、M5。
- 統一記憶體:CPU 和 GPU 共用同一塊記憶體,跑 AI 時不必來回搬資料。
- 量化(Quantization):把模型的數字精度降低、檔案變小,讓一般電腦也跑得動,代價是可能稍微不準。
- Token:AI 處理文字的單位,每秒產生的 token 數越多,回答出現得越快。