觀點 · 資訊分享
Gemma 4 26B 上了 Cloudflare Workers AI:沒有顯卡也能用 API 呼叫,上下文視窗 256K
Cloudflare 4/4 宣布與 Google 合作,把 Gemma 4 26B A4B 放上 Workers AI。這是總共 26B 參數、每次只啟用 4B 的 MoE 模型,可用 Workers 綁定、REST API 或相容 OpenAI 的端點呼叫。
- 發布
- 2026-04-05
- 篇幅
- 約 3 分鐘 · 1,527 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
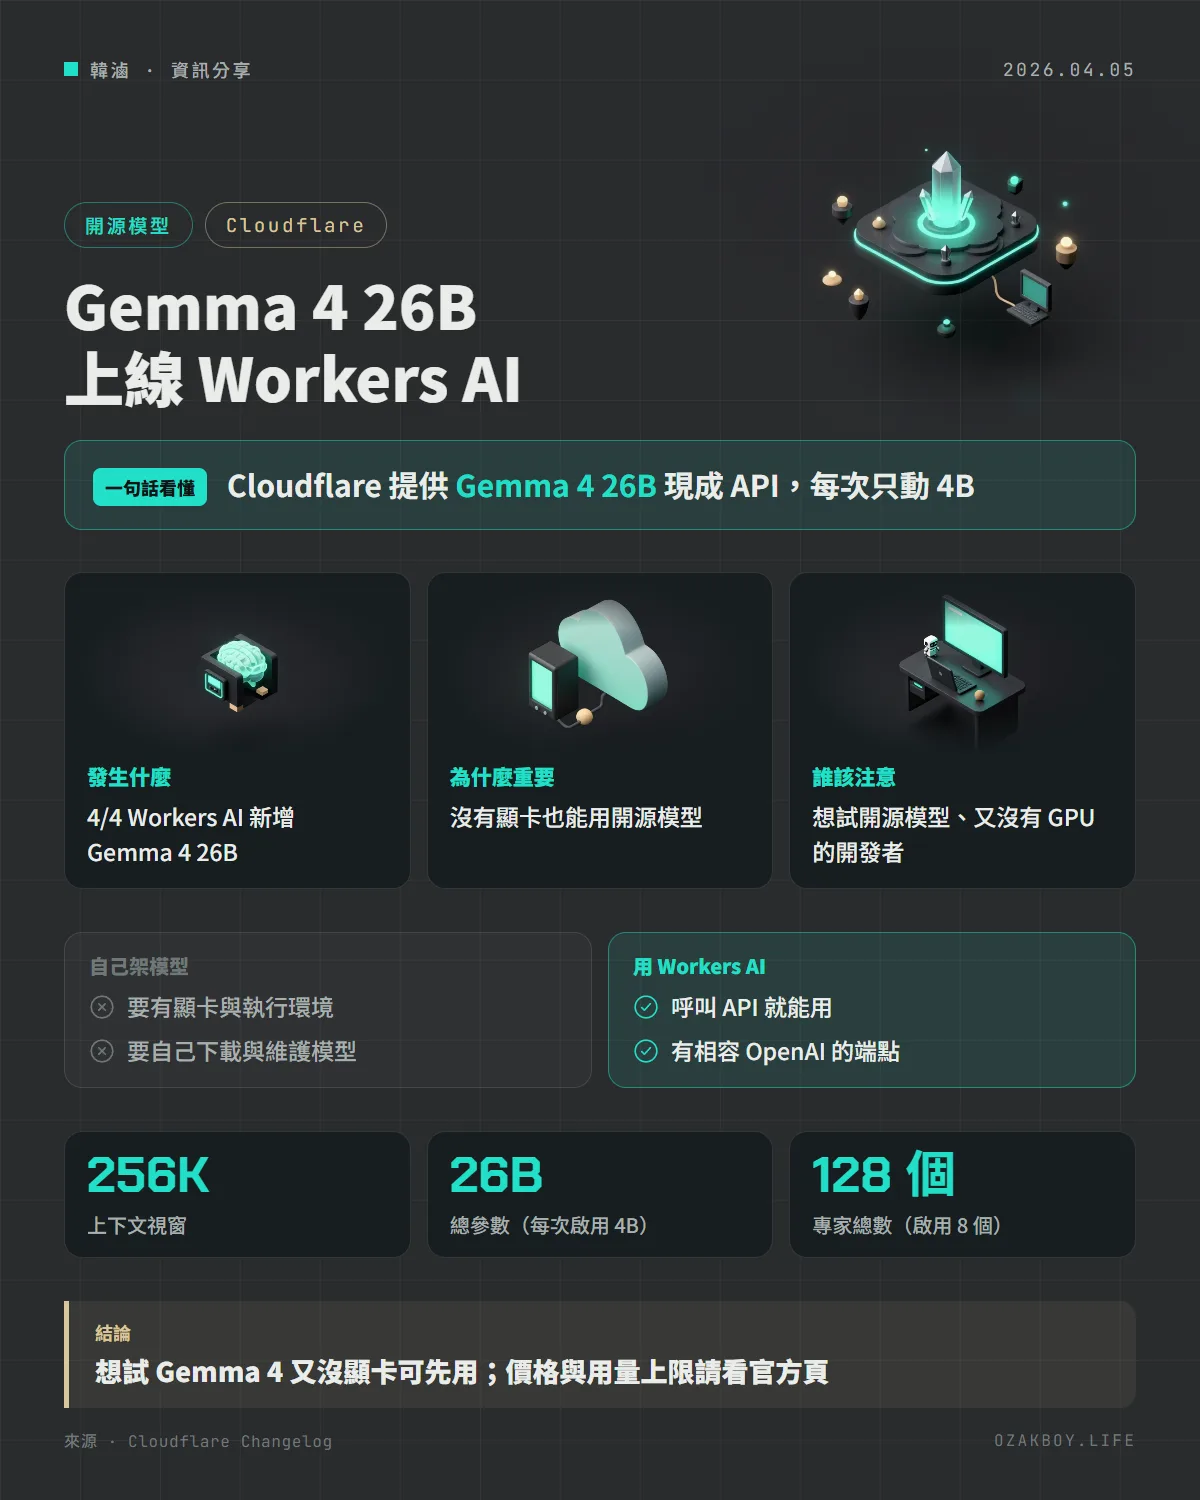
一句話看懂:Cloudflare 把 Google 的 Gemma 4 26B A4B 放上 Workers AI,不需要自己的顯卡,用 API 就能呼叫這個 256K 上下文的開源模型。
先用白話講:這是什麼?
上一次聊 Gemma 4,重點是「可以下載回家自己跑」。這次是另一條路:不下載,直接「租用」。
就像你想吃牛排,可以自己買廚房設備煮,也可以去餐廳點。Cloudflare Workers AI 就是那間餐廳,Gemma 4 26B 是新上的菜色,你只要透過 API 點餐,不用自己準備顯卡。
發生什麼事
Cloudflare 在 4 月 4 日的更新日誌說,與 Google 合作把 @cf/google/gemma-4-26b-a4b-it 放上 Workers AI。官方介紹的重點:
- MoE(混合專家)架構:128 個專家中每次啟用 8 個,另有 1 個共用專家;總參數 26B,每次推論只啟用 4B。Cloudflare 的說法是,它跑起來幾乎跟 4B 模型一樣快,品質卻接近大得多的模型
- 上下文視窗 256,000 token:可以放進完整的對話歷史、工具定義與長文件
- 內建思考模式:回答前先一步步推理,用來提升複雜任務的準確度
- 視覺理解:物件偵測、文件與 PDF 解析、螢幕與介面理解、圖表理解、OCR(含多語言)與手寫辨識
- 函式呼叫:原生支援結構化的工具呼叫,適合做多步驟的 Agent
- 多語言:開箱即用支援 35 種以上語言,預訓練涵蓋 140 種以上
自己架 vs 用 Workers AI
| 項目 | 自己架(例如 Ollama) | Workers AI |
|---|---|---|
| 硬體 | 需要自備顯卡或高階電腦 | 不需要 |
| 資料 | 留在自己的機器 | 請求會送到 Cloudflare |
| 維護 | 自己下載、更新模型 | 由 Cloudflare 提供 |
| 呼叫方式 | 依你的部署而定 | Workers 綁定、REST、相容 OpenAI 端點 |
給開發者的技術細節
官方列出三種呼叫方式:Workers AI 綁定 env.AI.run()、REST API 的 /run 或 /v1/chat/completions,以及相容 OpenAI 的端點。以下是 Worker 裡的示意寫法(參數格式請以模型頁為準):
export default {
  async fetch(request, env) {
    const result = await env.AI.run("@cf/google/gemma-4-26b-a4b-it", {
      messages: [{ role: "user", content: "用三句話解釋什麼是 MoE 模型" }],
    });
    return Response.json(result);
  },
};
公告沒有列出價格與用量上限,上線前請到 Workers AI 的定價與模型頁確認。
我的看法
我自己在家用 Ollama 跑本地模型,好處是資料完全不出門、不怕斷網;但家裡的顯卡要同時給 ComfyUI 用,常常排不開。這種時候,能有一個「用 API 就叫得到 Gemma 4」的備案很實用,特別是做小型的客戶專案,不想在客戶機房裝顯卡的時候。
要記得取捨:呼叫雲端就代表請求內容會送出去,涉及客戶個資的場合要先確認隱私與合約。另外 MoE 模型的「4B 啟用」指的是速度與算力,不代表所需記憶體只要 4B,這點在自己架的時候尤其要留意。
名詞小辭典
- Workers AI:Cloudflare 提供的 AI 推論服務,用 API 呼叫現成模型。
- MoE(Mixture of Experts):模型內有很多「專家」,每次只叫出其中一部分工作,所以又大又快。
- 上下文視窗(Context window):模型一次能讀進去並記住的內容長度上限。
- 函式呼叫(Function calling):讓模型能指定要呼叫哪個工具、帶什麼參數,用來做 AI Agent。