觀點 · 資訊分享
DeepSeek V4.1 Flash 開源:552B 參數每次只動 8B,對話記憶只佔上一代的 1/4
DeepSeek 以 MIT 授權開放 V4.1 Flash:總參數 552B,但讀輸入時只動用 8B、寫輸出時 16B,對話記憶(KV 快取)縮到上一代的 1/4。官方說它比自家旗艦 V4 Pro 還強,V4 Pro 的 API 請求將改由它處理。
- 發布
- 2026-09-10
- 篇幅
- 約 4 分鐘 · 1,788 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
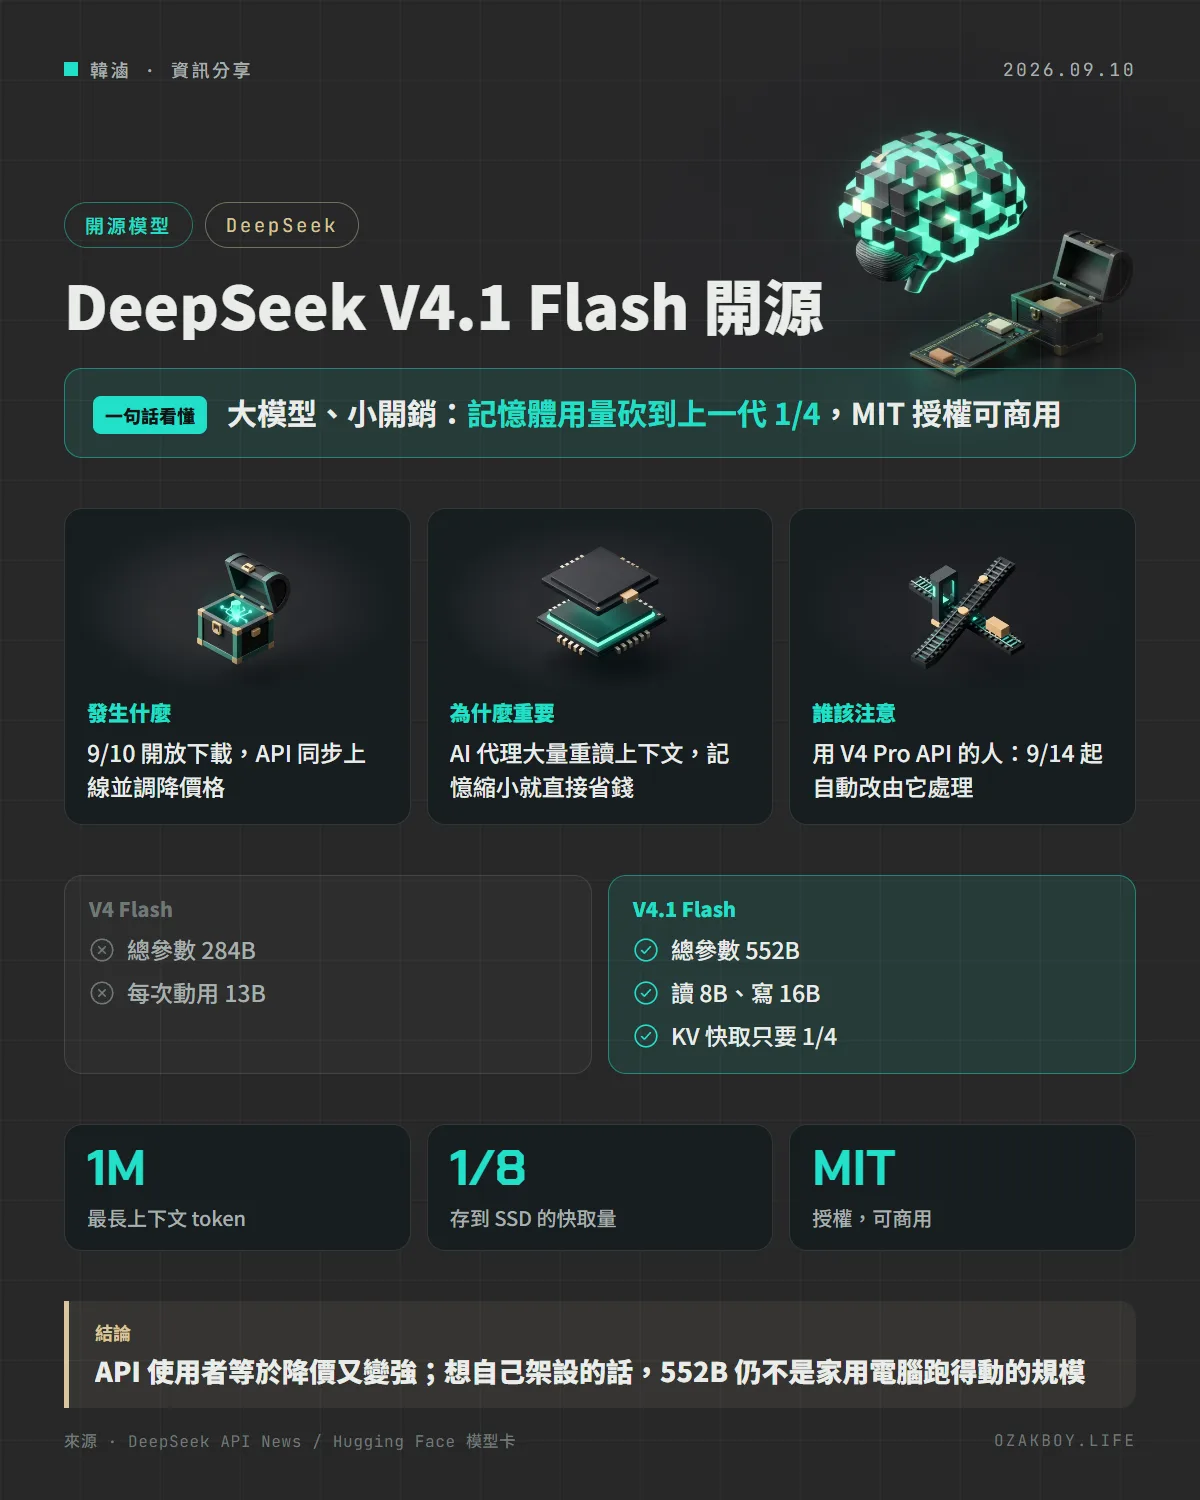
一句話看懂:DeepSeek 開源 V4.1 Flash,總參數 552B 但每次只動用一小部分,對話記憶縮到上一代的 1/4,官方說它已經比自家旗艦 V4 Pro 更強。
先用白話講:「552B 參數只動 8B」是什麼意思?
想像一間有好幾百位專家的大型顧問公司。每來一個問題,櫃台只會叫最相關的幾位出來回答,其他人繼續休息。公司的「總人數」很多,所以懂得廣;但每次真正上工的人很少,所以付的鐘點費不高。
這就是 MoE(混合專家) 模型的做法。DeepSeek V4.1 Flash 的總參數是 552B(5520 億),但讀你的輸入時只動用 8B,寫回答時動用 16B。
另一個重點是 KV 快取:模型讀過的內容要先記在一份「筆記」裡,後面才能接著回答。AI 代理動不動就讀進整個專案的程式碼,這份筆記越大,佔的 GPU 記憶體越多、成本越高。V4.1 Flash 把這份筆記大幅縮小了。
發生什麼事
DeepSeek 在 2026 年 9 月 10 日發布並開源 V4.1 Flash:
- 授權:模型權重與程式碼採 MIT 授權
- 架構:新的「因果編碼器-解碼器」設計,讀輸入只動 8B 參數、產生輸出動 16B
- 記憶更省:跟上一代相比,KV 快取在 GPU 記憶體(HBM)上只要 1/4、存到 SSD 的部分只要 1/8;模型卡寫明每個 token 約 890 bytes
- 能力:原生支援圖片輸入,上下文最長 100 萬 token,預訓練資料 45T token
- API:同日上線,模型名稱設
deepseek-flash;新價格自 9 月 10 日 UTC 04:00 生效,離峰時段價格是尖峰的 50%
為什麼說它「超車自家旗艦」?
官方公告說,多方測試都顯示 V4.1 Flash 在效能、成本、速度上贏過 V4 Pro,因此要讓 V4 Pro 退場:
| 比較 | V4 Flash | V4 Pro | V4.1 Flash |
|---|---|---|---|
| 總參數 | 284B | 1.6T | 552B |
| 每次動用參數 | 13B | 49B | 8B/16B |
| Terminal-Bench 2.1 | 82.7 | 87.9 | 90.6 |
| DeepSWE v1.1 | 54.4 | 62.7 | 74.2 |
分數取自官方模型卡,為 DeepSeek 自家測試、最高推理強度的結果。
在模型卡的同一張表裡,比較難的 Terminal-Bench 3.0、4.0,V4.1 Flash 仍明顯落後表中的 Opus 5.0 與 GPT-5.6 Sol,不是全面領先。
給開發者的技術細節
- 舊模型名稱:
deepseek-v4-flash與deepseek-v4-flash-vision-exp暫時會導向 V4.1 Flash - V4 Pro 自動切換:2026-09-14 UTC 04:00 起,
deepseek-v4-pro的請求改由 V4.1 Flash 處理、以 Flash 價格計費,直到 V4.1 Pro 推出 - 推理強度可調:支援 1~100 的連續推理強度設定,用成本換準確度
- 沒有附 Jinja 對話範本:官方改提供 Python 參考實作與 Rust 工具庫
deepseek-recipe來組提示格式,自己架推論服務的人要留意
我的看法
對用 API 的小團隊來說,這是很直接的好消息:同樣的錢能做更多事,原本用 V4 Pro 的人甚至不用改程式就會被換到更便宜的模型。不過「自動換模型」也代表回答風格可能改變,有在用它跑正式流程的,最好先拿自己的測試案例跑一輪再放心。
至於自架派,552B 的規模還是資料中心等級,家用 NAS 或一張顯示卡沒有機會。但 KV 快取縮小這類技術,通常會慢慢影響之後的小模型設計,值得持續關注。
名詞小辭典
- MoE(混合專家):模型裡有很多組「專家」,每次只叫出最相關的幾組來運算,省下大量計算。
- KV 快取:模型記住前面讀過內容的暫存資料,內容越長佔用越多記憶體。
- 上下文(Context):模型一次能讀進並記住的內容長度,以 token 計算。
- MIT 授權:很寬鬆的開源授權,可以商用、修改,保留授權聲明即可。