觀點 · 資訊分享
Ollama 0.30 改用 llama.cpp 擴大相容:Hugging Face 的 GGUF 模型與自己微調的模型更好跑
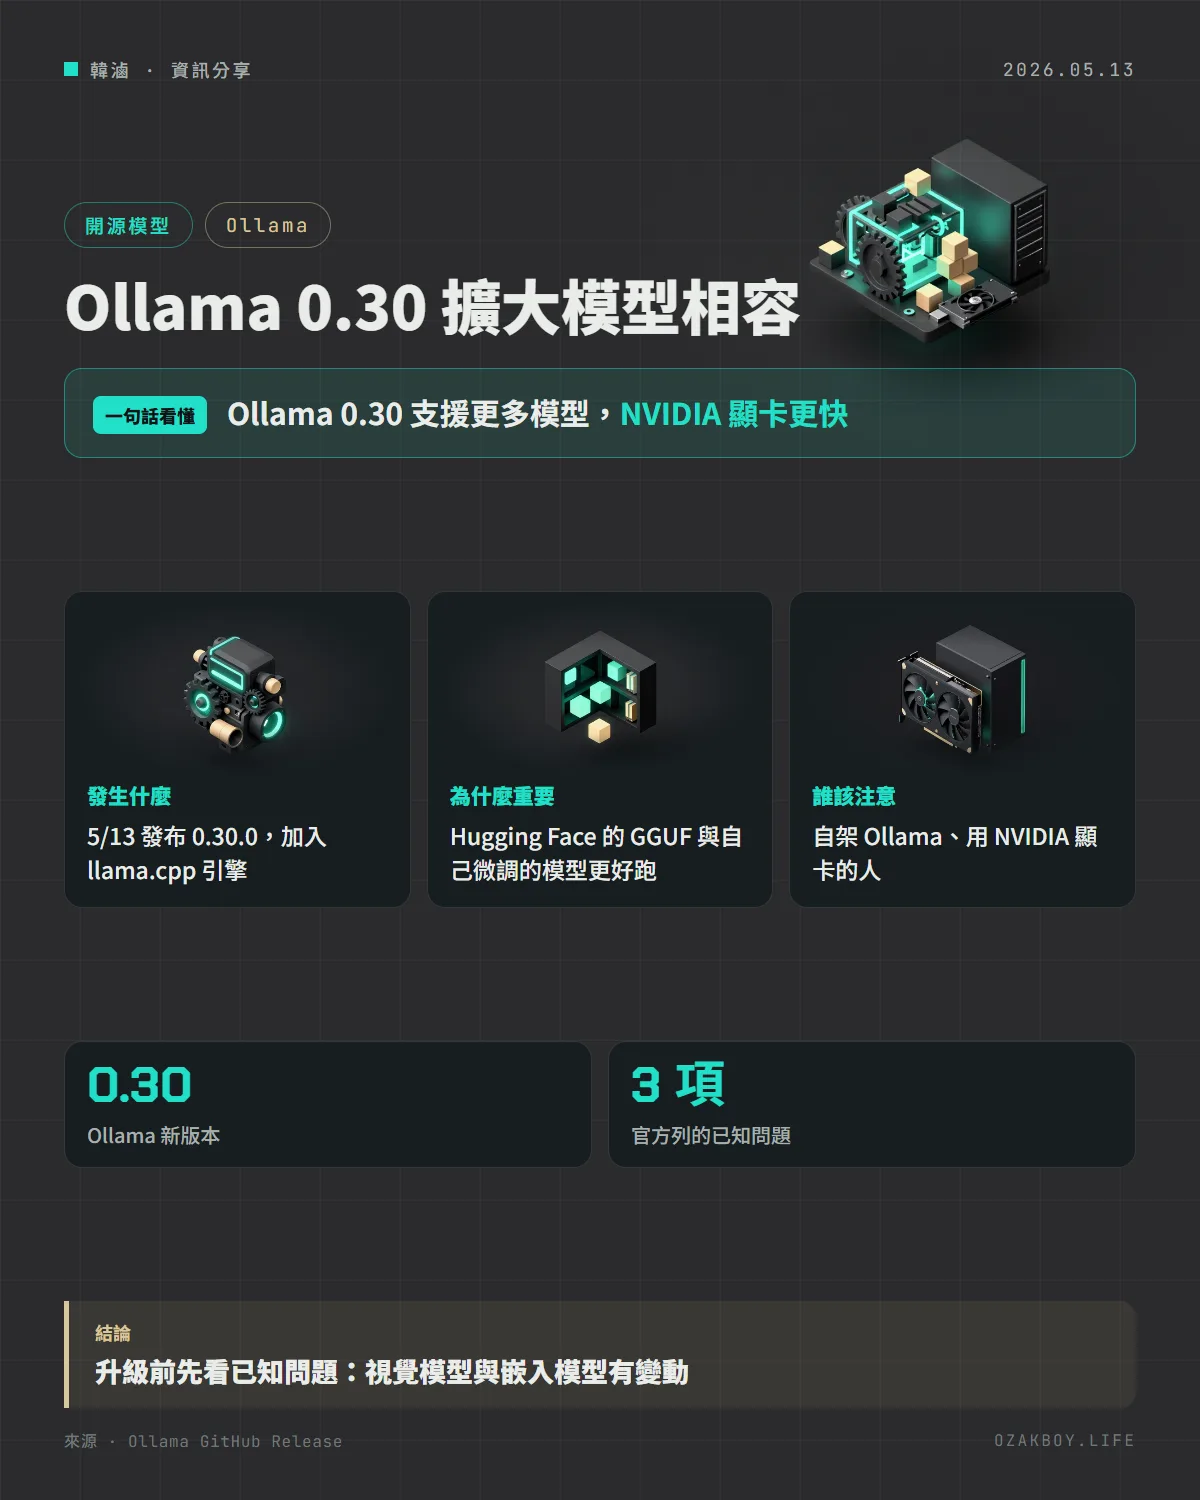
Ollama 在 5 月 13 日發布 0.30.0,官方說用 llama.cpp 強化相容與效能,能支援更多模型,包含 Hugging Face 上的 GGUF 模型與自行微調的模型,NVIDIA 顯卡也更快。升級前有三個已知問題要先看。
- 發布
- 2026-05-13
- 篇幅
- 約 3 分鐘 · 1,301 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
一句話看懂:Ollama 0.30 用 llama.cpp 擴大了能跑的模型範圍,NVIDIA 顯卡也更快,但有三個已知問題,升級前要先看。
先用白話講:Ollama 在做什麼?
想像 Ollama 是一台「萬用播放機」:你下載 AI 模型(像光碟),放進去就能在自己的電腦上播放,資料不必上傳到雲端。
問題是模型的格式很多,播放機認不得的光碟就放不進去。這次 0.30 的重點,就是讓它認得更多種類的「光碟」。
發生什麼事
Ollama 在 5 月 13 日發布 0.30.0。官方的說法是:
- 用 llama.cpp 強化相容性與效能
- 這個引擎補強原本在 Apple 晶片上使用的 MLX 引擎,讓更多種硬體都能受益
- 能支援更廣泛的模型,包含 Hugging Face 上的 GGUF 模型,以及你自己微調過的模型
- 在 NVIDIA 硬體上跑得更快
升級前要注意的事
官方明列了已知問題:
| 項目 | 狀況 |
|---|---|
| laguna-xs.2 | Windows 與 Linux 暫時不支援 |
| llama3.2-vision | 暫時不支援 |
| nomic-embed-text | 輸入現在會轉成小寫,舊版錯誤地保留大小寫 |
要不要馬上升級?
- 想試 Hugging Face 上的新模型、或手上有自己微調的模型:值得升級試試
- 用 NVIDIA 顯卡、想要更快的速度:官方說有效能提升,可以升級後自己量測
- 正在跑視覺模型 llama3.2-vision,或用 nomic-embed-text 做搜尋的人:先看已知問題,不要急著升級
給開發者的技術細節
- 如果你用 nomic-embed-text 做向量搜尋或 RAG(檢索增強生成),新版會依模型說明卡把輸入轉小寫,產生的向量可能和舊版略有不同。這是我自己的推論,官方公告沒有講到重新建立索引,但同一批資料最好用同一個版本算出向量,避免新舊混用
- 官方說這版也支援自己微調的模型,但沒有列出細節;實際能不能載入,還是要自己試
- 使用 llama3.2-vision 的人先不要升級,等官方補上支援
我的看法
我自己在家裡的主機上用 Ollama 跑本地模型,最常卡關的就是「想試的新模型,Ollama 還不支援」。這次擴大相容範圍,直接受惠的是喜歡從 Hugging Face 找模型來玩的人。
但我的習慣是:跑著正在用的服務,不要第一天就升級。尤其是用 llama3.2-vision 或是嵌入模型的流程,先在另一台機器或另一個環境試過,確認輸出沒變再換。小版本的已知問題清單,比功能亮點更值得先看完。
名詞小辭典
- llama.cpp:開源的模型執行引擎,讓一般電腦也能跑大型語言模型。
- GGUF:llama.cpp 使用的模型檔格式,很多開源模型都有提供。
- 微調(Fine-tune):拿現成的模型,再用自己的資料訓練一次,讓它更懂特定任務。
- 嵌入模型(Embedding):把文字轉成一串數字向量,用來做相似度搜尋的模型。
資料來源
常見問題
Ollama 是什麼?
一套讓你在自己電腦上跑大型語言模型的工具,下載模型之後,用幾行指令就能對話,也有 API 可以給自己的程式呼叫。
llama.cpp 和 GGUF 是什麼?
llama.cpp 是一套很常用的開源模型執行引擎;GGUF 是它使用的模型檔格式,許多 Hugging Face 上的模型都有提供這個格式。
升級後要注意什麼?
官方列出的已知問題包含 llama3.2-vision 暫不支援、laguna-xs.2 在 Windows 與 Linux 暫不支援。另外 nomic-embed-text 的輸入現在會轉小寫,用它做向量搜尋的人要留意結果可能和舊版不同。
接著讀
全部觀點 →Ollama 0.34.1:模型清單 API 冷啟動從 3.1 秒降到 294 毫秒,自己轉模型的規矩也跟著改了本地 AI 工具 Ollama 發布 0.34.1:模型很多時,列出模型的 /api/tags 快上許多;用 MLX 的 safetensors 建模型不再是實驗功能,但 GGUF 的轉檔與量化要改用 llama.cpp 工具,typical_p 參數也被棄用。閱讀 →Ollama 加入 d3 決策模型:本機就能做分類、是非題與評分,最小 2B 版約 3.6GB 記憶體Ollama 0.40.11 在 10 月 24 日帶進 vLLM Semantic Router 的 d3 決策模型。它不聊天,只回答「分到哪一類、是或不是、幾分」,有 2B 到 27B 四種大小,Apache 2.0 授權,可以在自己的電腦上跑。閱讀 →Flint 開源程式模型上架 Ollama:約 400 億參數、每次只動 25 億,Apache 2.0 授權Recursive 的開源程式模型 Flint 在 10 月 21 日登上 Ollama,一行指令就能在自己電腦跑。它是混合專家架構,總共約 400 億參數,處理每個 token 只動用約 25 億,下載大小 23GB。閱讀 →