觀點 · 資訊分享
Ollama 0.34.1:模型清單 API 冷啟動從 3.1 秒降到 294 毫秒,自己轉模型的規矩也跟著改了
本地 AI 工具 Ollama 發布 0.34.1:模型很多時,列出模型的 /api/tags 快上許多;用 MLX 的 safetensors 建模型不再是實驗功能,但 GGUF 的轉檔與量化要改用 llama.cpp 工具,typical_p 參數也被棄用。
- 發布
- 2026-09-14
- 篇幅
- 約 4 分鐘 · 1,743 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
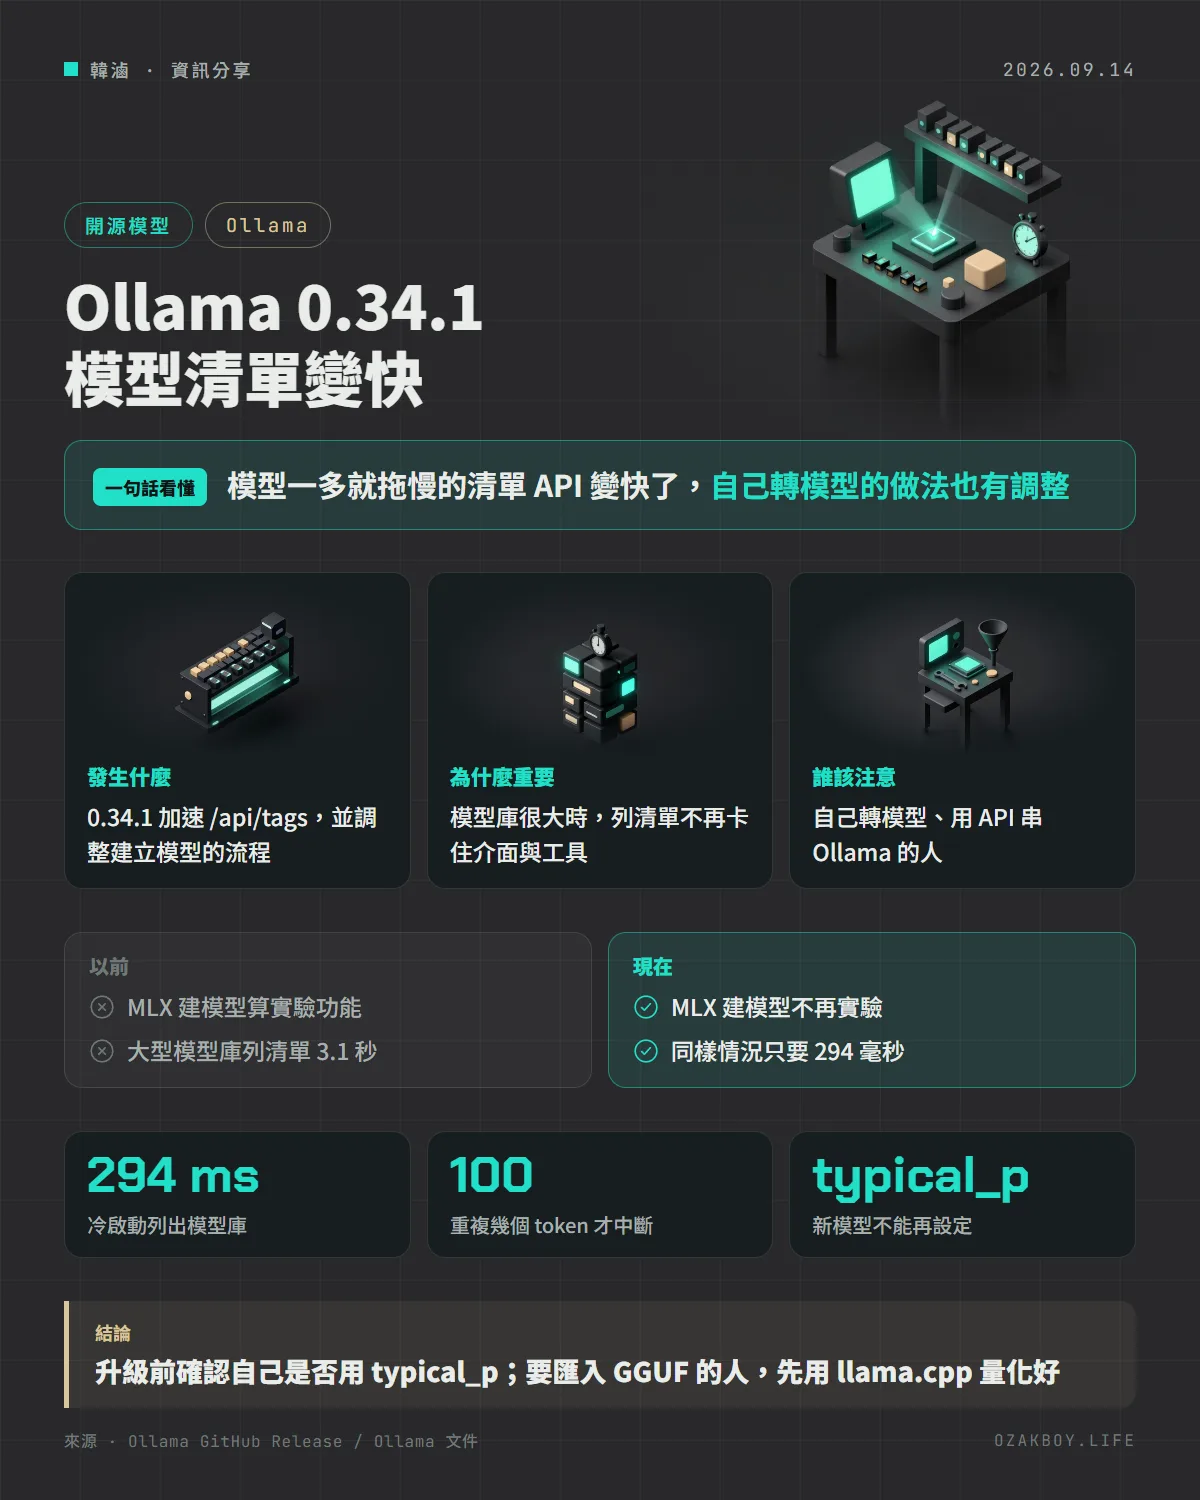
一句話看懂:Ollama 0.34.1 讓「列出模型清單」的 API 在大型模型庫下快了很多,同時調整了自己轉模型的做法:GGUF 的量化改靠 llama.cpp,MLX 的 safetensors 則不再是實驗功能。
先用白話講:Ollama 在幫你做什麼?
Ollama 是讓你在自己的電腦(或家裡的 NAS、伺服器)上下載、執行開源 AI 模型的工具。可以把它想成「模型的應用程式商店加播放器」:你說要哪個模型,它幫你下載、載入、對外提供一個 API 給別的程式呼叫。
這次 0.34.1 是個小改版,但有幾項改動,會直接影響自架的人。
發生什麼事
Ollama 在 2026 年 9 月 14 日(UTC)發布 0.34.1,release 說明列出:
- MLX safetensors 建模型不再是實驗功能:用
ollama create從 MLX 的 safetensors 權重建立模型,轉為正式支援;同時改善 Apple Silicon 上的 MLX 記憶體處理 - GGUF 要改用 llama.cpp 工具:建立 GGUF 模型時,從 safetensors 轉檔與量化的步驟,現在需要用 llama.cpp 的工具
/api/tags大幅變快:官方在大型模型庫的測試中,冷啟動從 3.1 秒降到 294 毫秒,同時模型的能力標籤(capabilities)現在回報得更一致- 重複輸出偵測更保守:偵測「模型卡住、一直重複」的機制,現在要累積 100 個重複的 token 才會觸發,減少像 OCR 這種本來就會有重複文字的情況被誤判
- 棄用
typical_p:新建立的模型不能再設定;既有的 GGUF 模型仍保留支援 - 另外更新了 MLX 與 llama.cpp
轉模型流程,現在長什麼樣?
依官方的匯入文件,主要有兩條路:
| 來源格式 | 做法 |
|---|---|
| Safetensors 權重 | Modelfile 寫 FROM /權重資料夾路徑,再執行 ollama create 名稱 |
| GGUF 檔 | 先用 llama.cpp 的 llama-quantize 等工具量化好;Ollama 匯入時不會幫你量化 |
給開發者的技術細節
建立一個模型的最小流程:
# Modelfile
FROM /path/to/model.gguf
ollama create my-model
ollama run my-model
- 如果 Modelfile 或你的腳本裡有設定
typical_p,升級前先拿掉,新建立的模型會拒絕這個參數 - 有用
/api/tags的圖形介面或自動化,升級後可以觀察清單載入是否變快 - 後續(9/15):Ollama 又發布 0.34.2,新增第一次執行
ollama時的設定流程(可選擇登入或繼續在本機使用),並修正 MLX 推測解碼(speculative decoding)長時間生成時記憶體不斷增加的問題
我的看法
自己架 Ollama 的人,模型庫常常越堆越大,一個 API 慢個幾秒,介面就會明顯卡頓,所以 /api/tags 變快雖然看起來是小事,實際上很有感。
比較需要留意的是 GGUF 流程的調整:如果你有自己轉模型的腳本,尤其是「safetensors 轉 GGUF 再量化」這一段,升級後最好在測試環境先跑一遍,確認流程沒有斷。我的習慣是先升級一台不重要的機器,把常用的幾個模型重新載入、跑一次,沒問題再升級主要的服務。
名詞小辭典
- Ollama:在本機或自己的伺服器上執行開源 AI 模型的工具。
- GGUF:本地模型常用的單一檔案格式,通常是已經壓縮(量化)過的版本。
- Safetensors:另一種常見的模型權重儲存格式,通常是未壓縮的原始權重。
- 量化(Quantization):把模型數字的精度降低,換取更小的檔案與更低的記憶體需求。
- MLX:蘋果為自家晶片(Apple Silicon)設計的機器學習框架。
資料來源
常見問題
/api/tags 是做什麼用的?
它是 Ollama 提供的 API,用來列出本機有哪些模型。很多圖形介面、外掛與自動化腳本一開始都會先呼叫它,所以模型數量多的時候,它變快會直接讓這些工具反應更快。
我已經建好的 GGUF 模型會壞掉嗎?
release 說明只提到:建立 GGUF 模型時,從 safetensors 轉檔與量化的步驟,現在要用 llama.cpp 的工具。已經存在的模型,官方沒有說會受影響;而 typical_p 則是明說既有 GGUF 模型仍保留支援。
匯入自己的 GGUF 模型要怎麼做?
官方匯入文件寫明:Ollama 不會在匯入時量化 GGUF,要先用 llama.cpp 的 llama-quantize 之類工具準備好,再用 Modelfile 的 FROM 指向 .gguf 檔,最後執行 ollama create。
接著讀
全部觀點 →Ollama 0.40 在 Mac 上預設改用 MLX:本地跑 Qwen、Gemma 不用再手動切換本地 AI 工具 Ollama 發布 0.40 版,Apple Silicon 的 Mac 上只要模型架構有支援,就會自動用蘋果的 MLX 框架來跑。3 月預覽時官方測得輸出速度約快 1.9 倍。閱讀 →Ollama 一行指令接上 DeepSeek Harness 與 Meta Muse Code,同一天也支援 Qwen3.8 27BOllama 0.32.11 的 launch 指令新增兩個程式代理:DeepSeek 的開源 Harness 與 Meta 的 Muse Code。同日的 0.32.12 又加入 Qwen3.8 27B,蘋果晶片還有專用的 MLX 版。閱讀 →Ollama 0.40.4:Codex CLI 可以直接挑本機模型,終端機一行指令就能讓 AI 判斷是或否Ollama 0.40.4 讓 ollama launch codex 的模型選單出現本機安裝的模型,決策模型也能直接在終端機用 ollama run 問是非題、分類與評分;另外改善推論效能、支援多模態嵌入,Gemma 4 在 NVIDIA 顯示卡上的前置處理也變快。閱讀 →