觀點 · 資訊分享
vLLM 0.22.0 釋出:459 次提交,DeepSeek V4 支援更成熟、Qwen3 預設換新引擎
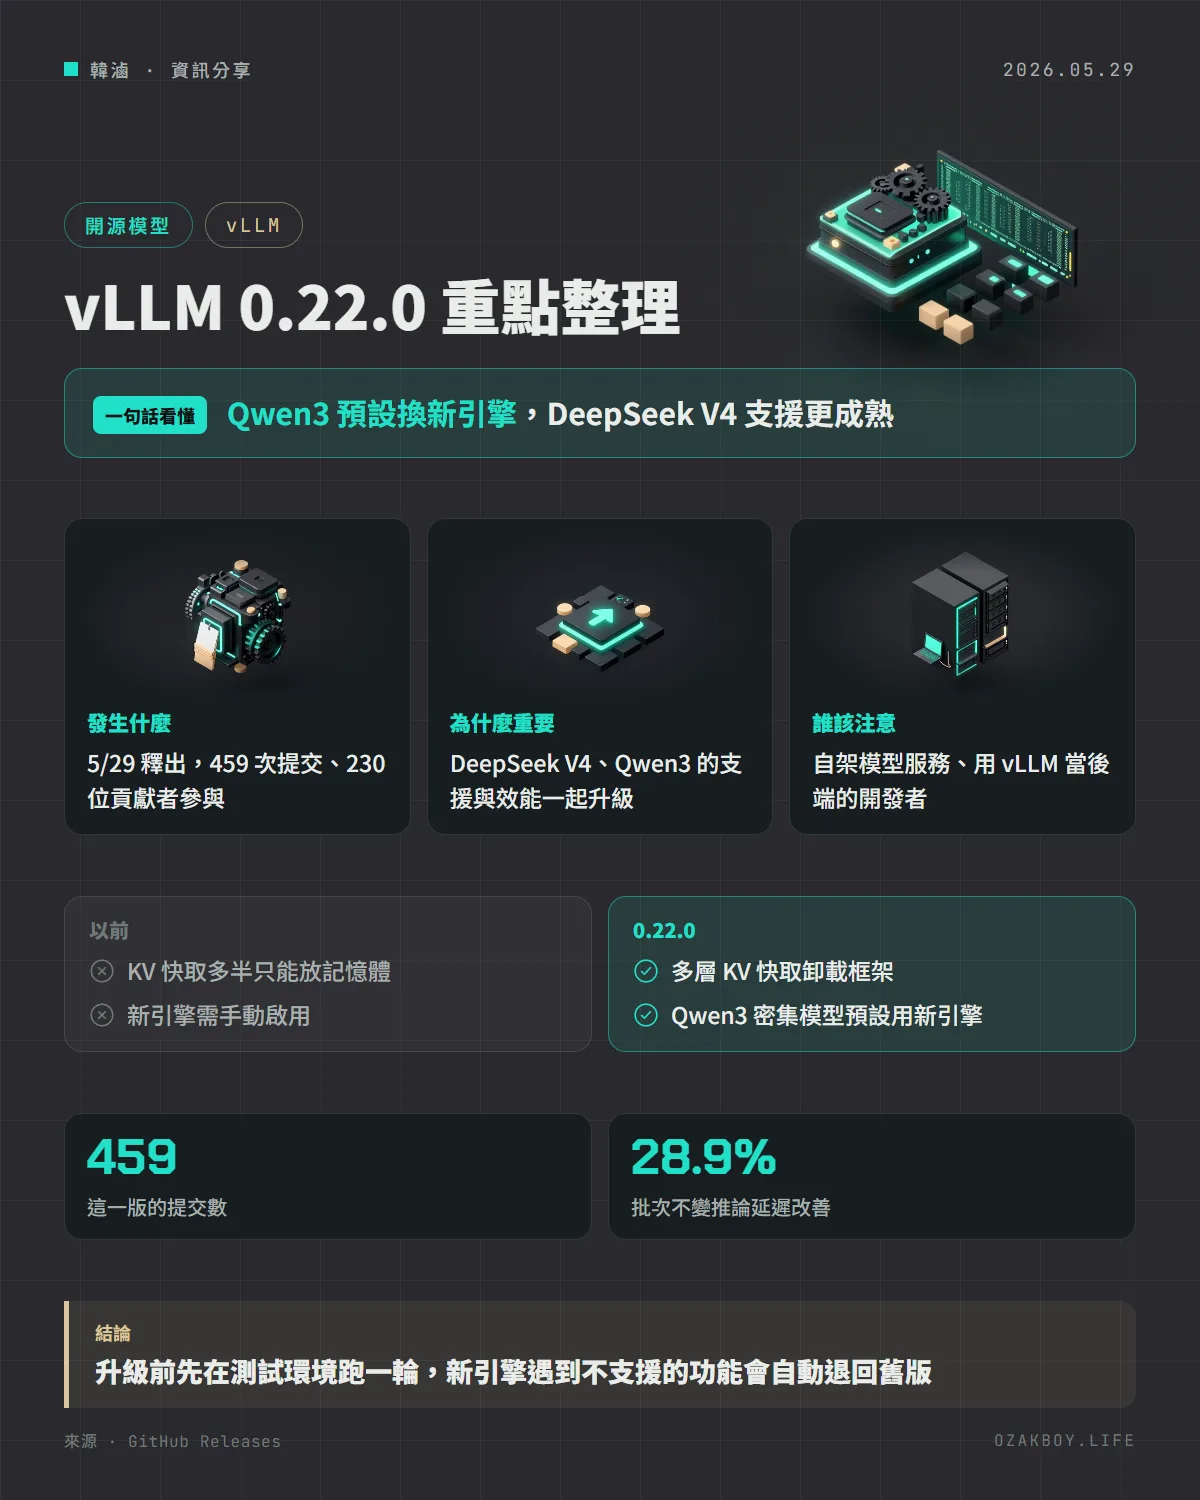
開源 AI 推論引擎 vLLM 在 5 月 29 日釋出 0.22.0。重點包括 DeepSeek V4 的完整強化、Qwen3 密集模型預設改用 Model Runner V2、實驗性的 Rust 前端,以及多層 KV 快取卸載。
- 發布
- 2026-05-29
- 篇幅
- 約 3 分鐘 · 1,365 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
一句話看懂:開源推論引擎 vLLM 釋出 0.22.0,Qwen3 密集模型預設改用新核心,DeepSeek V4 的支援也大幅補強。
先用白話講:vLLM 是什麼?
想像 AI 模型是一位很會做菜的大廚,但他一次只能煮一道菜,客人一多就大排長龍。vLLM 像是一間設計很聰明的廚房:幫大廚排流程、共用備料、把鍋爐的火力用滿,讓同一位大廚能同時服務更多客人。
它是開源的 AI 推論引擎,不少自架模型服務都用它當後端。
發生什麼事
vLLM 在 5 月 29 日釋出 0.22.0,官方說這一版包含 459 次提交、230 位貢獻者(其中 63 位是新人)。幾個主要亮點:
- DeepSeek V4 更成熟:模型程式碼整理成獨立套件,新增 NVFP4 融合 MoE、完整與分段 CUDA graph 以及 MTP 推測解碼
- Model Runner V2 往預設前進:Qwen3 密集模型預設改用;遇到不支援的功能會自動退回舊版
- 實驗性 Rust 前端:新增 Rust 版的前端整合,以及支援資料平行服務的監督程序
- 批次不變推論更快:加入 Cutlass FP8 支援,官方標示端到端延遲改善 28.9%
- 多層 KV 快取卸載:新框架讓快取不再只能放 CPU 記憶體,也可放到檔案系統,以及 Mooncake 磁碟
模型支援一覽
| 項目 | 這版的更新 |
|---|---|
| 新模型架構 | MiniCPM-V 4.6、InternS2 Preview、OpenVLA |
| 推測解碼 | 自訂提議器、EAGLE-3 相關、NemotronH 等 |
| Qwen3.5 / 3.6 | CUDA graph 與權重載入的多項改進 |
| Gemma3 / Gemma4 | 多解析度圖片批次、多 GPU 等修正 |
| 工具呼叫 | 新增 Apertus 工具解析器 |
給開發者的技術細節
- NVIDIA Blackwell(SM12x)新增 FlashInfer 的 MoE 與 FP4 GEMM 支援
- 效能項目:CutlassFP8 填充預處理讓首個 token 時間(TTFT)改善 13.5%、NVFP4 量化核心端到端改善 2.4 至 5.7%
- AMD ROCm 也有 DeepSeek V4 功能與精度修正
- 以上數字都是官方釋出說明裡的標示,實際效果依硬體與模型而定
- 上述只是節錄,完整清單請看 GitHub 的釋出說明
我的看法
我自己在家用 NAS 與一張顯卡跑本地模型,主要用 Ollama,所以 vLLM 這種偏伺服器端、追求吞吐量的工具不會天天碰。但看它的更新方向還是有參考價值:KV 快取卸載、推測解碼這些技術,之後多半會慢慢流到我們常用的工具裡。
如果你是用 vLLM 當正式服務的後端,升級前一定要在測試環境跑一輪,尤其是預設引擎換掉的 Qwen3 密集模型,要確認自己用到的功能沒有被退回舊版而影響效能。
名詞小辭典
- 推論(Inference):模型拿到輸入、產出答案的過程,跟「訓練」相對。
- KV 快取:模型生成文字時,暫存前面內容計算結果的記憶區,可避免重複運算。
- MoE:把模型切成多位「專家」,每次只啟用其中一部分,省算力。
- CUDA graph:把一串 GPU 操作先錄下來,之後一次重播,減少啟動的額外開銷。
資料來源
常見問題
vLLM 是什麼?
一套開源的 AI 模型推論引擎,目的是讓大型模型跑得更快、更省記憶體,很多自架模型服務都用它當後端。
Model Runner V2 是什麼?
vLLM 內部執行模型的新核心。這版起 Qwen3 密集模型預設使用它;官方說遇到它還不支援的功能時,會自動退回舊的 MRv1。
我一定要升到 0.22.0 嗎?
不用。如果目前的版本跑得穩,可以等有需要的功能(例如 DeepSeek V4 或新模型)再升,升級前建議先在測試環境確認。
接著讀
全部觀點 →vLLM 0.29 把新執行器 MRV2 設為所有模型的預設:舊版預計 0.32 移除,指令與預設值也有調整開源推論引擎 vLLM 發布 0.29.0:新一代執行器 Model Runner V2 成為所有模型的預設,舊版 MRV1 進入棄用、目標 0.32 移除。同時調整多項預設值,也有幾個指令與環境變數被移除。閱讀 →vLLM 0.21 發布:367 個提交、正式棄用 Transformers v4,建置也改要 C++20 編譯器開源推論引擎 vLLM 在 5 月 15 日發布 0.21.0,有 367 個提交、202 位貢獻者。重點包含新增多個模型架構、KV 快取卸載搭配混合記憶體配置器,以及兩項升級前要先看的變更:棄用 Transformers v4、要求 C++20。閱讀 →德國 Aleph Alpha 開源 Kolibri:78B 參數只動 3.5B,Apache 2.0 授權、最長 100 萬 token德國 AI 公司 Aleph Alpha 釋出開放權重模型 Kolibri,總共 780 億參數,但每個 token 只動用約 35 億,採 Apache 2.0 授權。它主打英文與德文,訓練到 25.6 萬 token 上下文,調整設定後可延伸到 100 萬。閱讀 →