觀點 · 資訊分享
Unsloth 0.1.43:CUDA 13.3 解掉「亂碼輸出」問題,Mac、Windows、AMD 的預編譯支援一起補齊
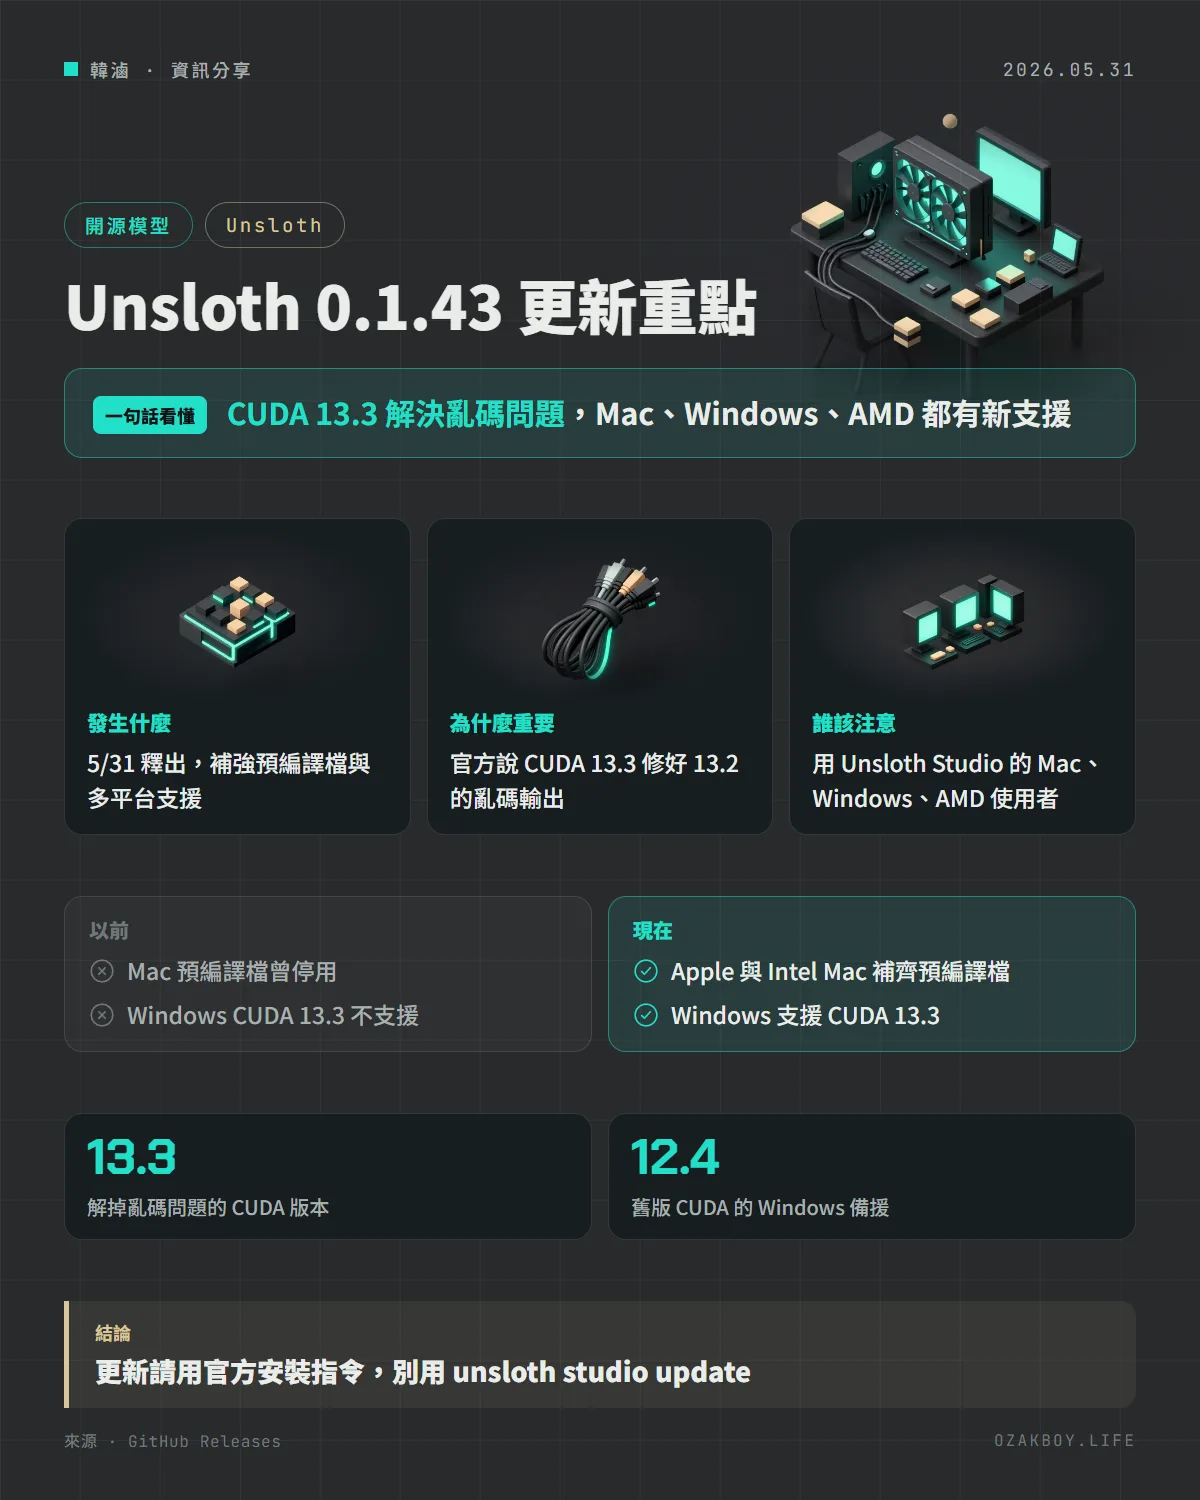
Unsloth 在 5 月 31 日釋出 v0.1.43-beta。官方說 CUDA 13.3 解決了 CUDA 13.2 的亂碼輸出問題,並補強 Mac 與 Windows 的 llama.cpp 預編譯檔、AMD ROCm 支援,以及 Studio 的遠端 MCP 與 Gemini 串接。
- 發布
- 2026-05-31
- 篇幅
- 約 3 分鐘 · 1,530 字
- 結構
- 8 節 + 3 題常見問題
- 標籤
一句話看懂:Unsloth 0.1.43 靠 CUDA 13.3 解掉模型輸出亂碼的問題,也補齊了 Mac、Windows 與 AMD 顯卡的預編譯支援。
先用白話講:這次更新在補什麼?
想像你要在家裡的電腦跑 AI 模型,就像要開一台高性能的跑車。引擎(模型)再好,也要配對的汽油與零件(CUDA 驅動與執行程式)。零件版本配不對,車就會異常,例如輸出一堆看不懂的亂碼。
Unsloth 是讓人在自己電腦上跑與微調模型的開源工具。這次更新主要是在處理「零件配對」這件事。
發生什麼事
Unsloth 在 5 月 31 日釋出 v0.1.43-beta。官方列出的重點:
- CUDA 13.3:官方說它解決了 CUDA 13.2 的亂碼輸出問題
- Windows:CUDA 13.3 的 llama.cpp 預編譯檔現在可用;CUDA 13.2、13.1 以下的裝置先用 CUDA 12.4 備援
- Mac:Apple Silicon(M1 到 M4)在 macOS 14、15、26 重新啟用預編譯檔;macOS 13 要自己從原始碼編譯;Intel Mac 在 13.3、14、15、26 使用預編譯檔
- Blackwell 顯卡:預編譯檔暫時延後,因為 CUDA 12.4 對它無效,官方說正在處理
Studio 介面的新東西
| 項目 | 說明 |
|---|---|
| Gemini 供應商 | 支援網頁搜尋、程式碼執行、提示快取與生圖 |
| 遠端 MCP 伺服器 | Studio 可連接遠端的 MCP 伺服器 |
| 多語系介面 | 新增前端 i18n 支援 |
| AMD | 支援 Strix Halo 與 Windows 上的 ROCm |
| 其他 | 可設定 CPU 執行緒上限、unsloth studio run 新增 --parallel 旗標 |
其他值得一看的小更新
- 訓練相關:新增 tool mask 支援,訓練介面可設定影像大小
- 修正非串流的 GGUF 聊天補全,用量統計不正確的問題
- 修正 Unsloth Studio 在 Colab 因代理與 iframe 設定而無法載入的問題
- 從較新的 nvidia-smi 輸出偵測 CUDA 驅動版本,避免誤判
- 修正
unsloth studio run轉送的--ctx-size等參數沒被納入上下文長度判斷的問題
給開發者的技術細節
- 更新方式:macOS、Linux、WSL 用
curl -fsSL https://unsloth.ai/install.sh | sh;Windows 用irm https://unsloth.ai/install.ps1 | iex - 官方特別警告:不要用
unsloth studio update,因為打包不會拿到最新更新 - 官方指出 CUDA 13.3 的修正對應 GitHub issue #4849
- 這是 beta 版,行為可能再調整
我的看法
我自己在家用 NAS 與一張顯卡跑本地模型,最怕的就是升級驅動後輸出變成亂碼,卻要花很久才查出是 CUDA 版本的問題。官方直接點名 13.2 有問題、13.3 才修好,這種資訊對自架的人很實用。
如果你正好用 CUDA 13.2,建議先確認自己是不是遇到同樣情況,再決定要不要升。不過這是 beta,我會先在非主力的環境測過,確認模型輸出正常,再動主要的機器。
名詞小辭典
- CUDA:NVIDIA 顯卡用來做平行運算的平台,跑 AI 模型常用到。
- 預編譯檔(Prebuilt binary):已經編譯好的執行檔,不用自己從原始碼編譯。
- llama.cpp:在個人電腦上跑大型語言模型的熱門開源引擎。
- MCP:讓 AI 工具連接外部服務的標準做法。
資料來源
常見問題
Unsloth 是什麼?
一套讓大型語言模型微調與執行更省資源的開源工具,Studio 是它的圖形介面,可以載入模型聊天,也可以做訓練。
CUDA 13.2 的亂碼問題是什麼?
官方的說法是使用 CUDA 13.2 時,模型輸出會變成亂碼;升到 CUDA 13.3 可以解決,詳細請看官方指出的 GitHub issue。
我要怎麼更新?
macOS、Linux、WSL 用 curl 的安裝指令;Windows 用 PowerShell 的安裝指令(官方 Release 頁有完整指令)。官方明講不要用 unsloth studio update,因為打包不會拿到最新更新。
接著讀
全部觀點 →llama.cpp 週末更新:GLM-5.2 終於能載入,CORS 代理也不再轉送你的登入標頭llama.cpp 週末(UTC)釋出 18 個版本,重點有三:GLM-5.2 的 GGUF 能載入了、內建 CORS 代理預設不再轉送認證與 Cookie 標頭、新增模型載入進度的即時串流。閱讀 →llama.cpp 加入 DFlash 推測解碼:本機跑大模型最高快約 8 倍,但要看模型與題目本機跑模型的核心工具 llama.cpp 在 6/28 合併 DFlash 推測解碼:讓小模型一次猜一整段字,大模型再批次檢查。PR 實測 Qwen3-8B 最高快 8.08 倍,但開啟思考或換成 MoE 模型時,加速有限,甚至會變慢。閱讀 →Unsloth Studio 大更新:Gemma 4 開 MTP 約快 2 倍,還能跑 DiffusionGemma 與聊文件本機跑開源模型的工具 Unsloth Studio 在一週內合併 150 多個 PR,新版支援 DiffusionGemma、Gemma 4 MTP(約 2 倍速)、MiniMax-M3,還新增模型 Hub 與文件問答。閱讀 →