觀點 · 資訊分享
Unsloth Studio 大更新:Gemma 4 開 MTP 約快 2 倍,還能跑 DiffusionGemma 與聊文件
本機跑開源模型的工具 Unsloth Studio 在一週內合併 150 多個 PR,新版支援 DiffusionGemma、Gemma 4 MTP(約 2 倍速)、MiniMax-M3,還新增模型 Hub 與文件問答。
- 發布
- 2026-06-13
- 篇幅
- 約 3 分鐘 · 1,557 字
- 結構
- 9 節 + 3 題常見問題
- 標籤
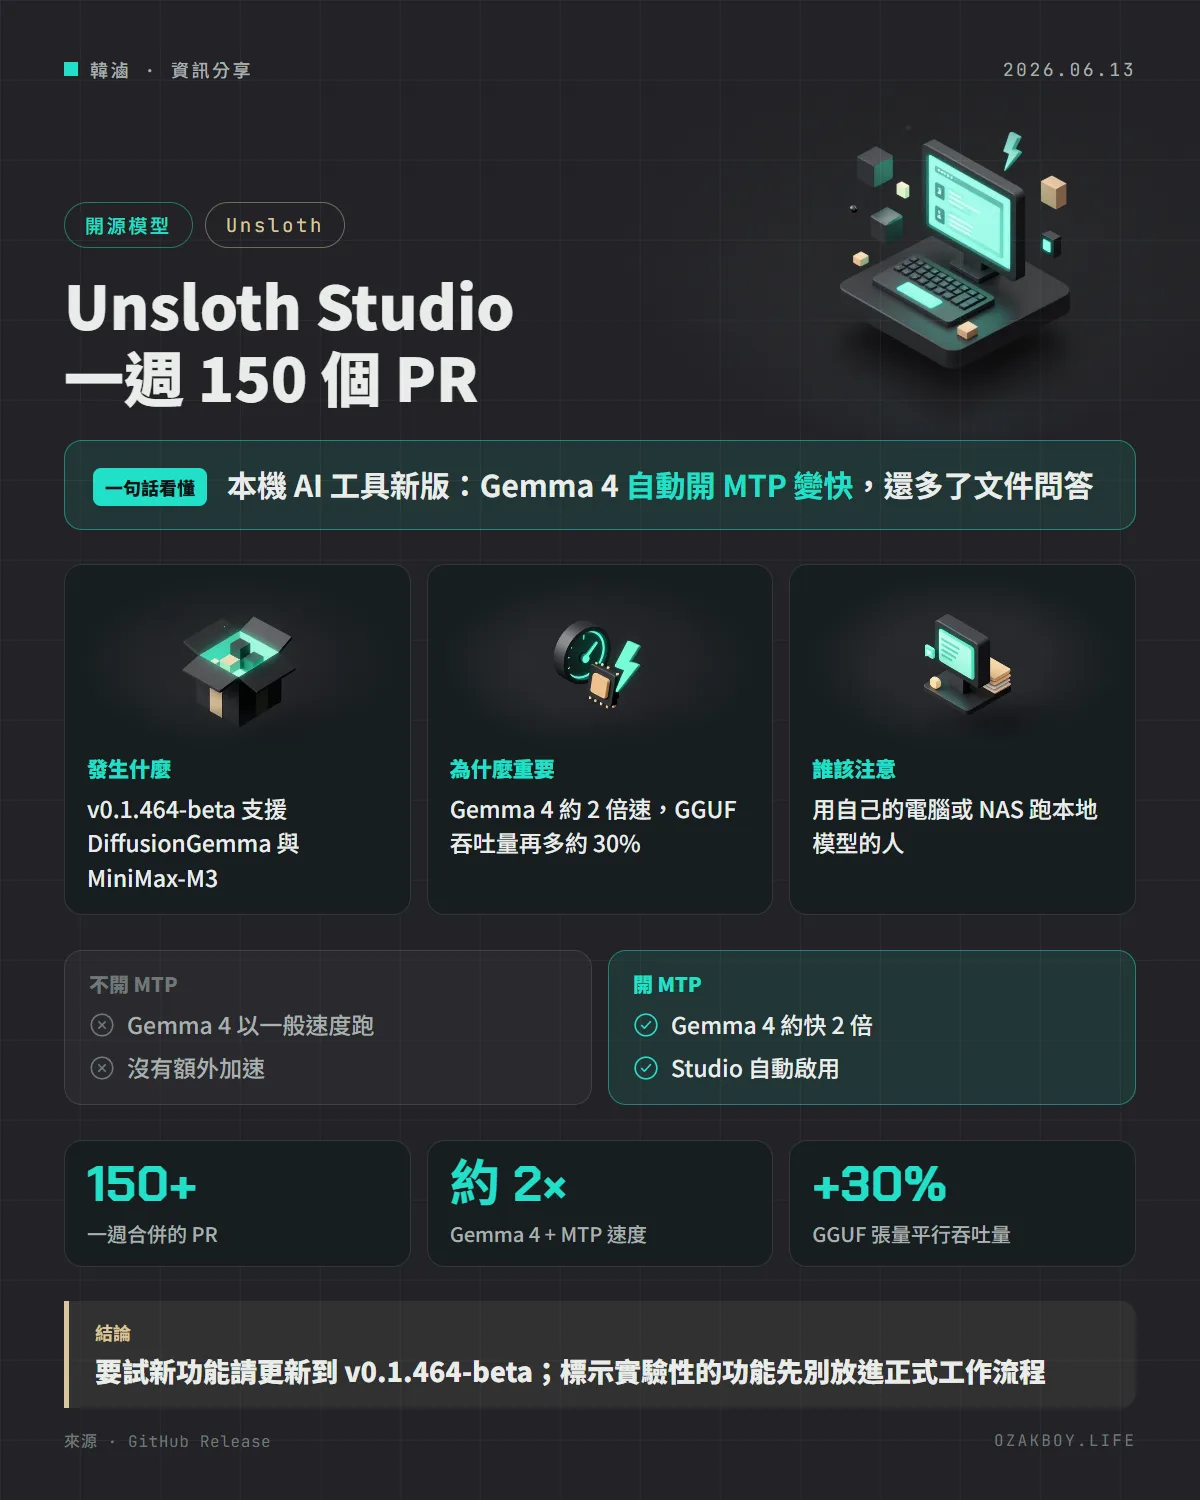
一句話看懂:本機跑開源模型的 Unsloth Studio 發布大更新,Gemma 4 搭配 MTP 約快 2 倍,還新增文件問答與模型 Hub。
先用白話講:Unsloth Studio 是什麼?
你可以把它想成「自己電腦上的 ChatGPT 工作台」:下載開源模型、在家就能聊天,也能拿來微調訓練。資料不用送到雲端,對不想外流資料的人很實用。
發生什麼事
Unsloth 在 2026 年 6 月 12 日發布 v0.1.464-beta(也標為 2026.6.7)。官方說一週內合併了 150 多個 PR,重點如下:
- 新模型支援:DiffusionGemma、Gemma 4 MTP、MiniMax-M3
- Gemma 4 約快 2 倍:搭配 MTP,並在 Studio 自動啟用
- Gemma 4 音訊聊天:支援 wav、mp3、m4a、flac、webm
- Gemma 4 加入 Preserve Thinking
其他實用更新
- Hub(實驗性):瀏覽、下載、管理 Hugging Face 的模型與資料集,也能偵測電腦裡已有的模型
- Chat with Files(實驗性):針對自己的文件與知識庫提問,支援混合搜尋、引用、PDF 預覽
- Update llama.cpp 按鈕:不用重裝 Studio 就能更新本機後端
- GGUF 張量平行:官方說吞吐量可增加約 30%
- 工具呼叫:官方說「催促」問題減少 50% 到 90%,且不影響準確度
- 加密通道:新增 Cloudflare HTTPS 免費通道,可讓 Studio 端到端加密對外
開 MTP 跟不開差多少?
| 不開 MTP | 開 MTP | |
|---|---|---|
| Gemma 4 速度 | 一般速度 | 官方說約 2 倍 |
| 要不要自己設定 | - | Studio 自動啟用 |
官方只給「約 2 倍」這個說法,沒有附測試條件,實際倍數會因硬體而異。
誰適合現在更新?
- 已經在用 Gemma 4、想讓回應變快的人:更新後 MTP 會自動開啟
- 想在自己電腦上問自己文件的人:可以試試 Chat with Files,但它標示為實驗性
- 需要一個管理本機模型的畫面的人:新的 Hub 頁面能列出電腦裡已有的模型
這是 beta 版,要用在重要的工作之前,建議先在測試環境跑一輪。
給開發者的技術細節
- 版本:
v0.1.464-beta;公告也提到若 DiffusionGemma 先前不能用,請至少更新到 v0.1.462-beta - 本機伺服器對 OpenAI 與 Anthropic 相容 API 的錯誤訊息、token 用量、停止原因都有改善,官方並提到 Claude Code 相容性
- 硬體面:llama.cpp 預編譯檔更新,改善 Windows / WSL 的 AMD 支援、Strix Halo ROCm 與 Blackwell CUDA 的選擇
- 工具權限新增:略過權限、每次核准、總是核准、拒絕
我的看法
自架服務的人最在意兩件事:速度夠不夠用、資料會不會外流。這次剛好兩點都有進展:Gemma 4 變快,文件問答也能在本機做完。
但這是 beta 版,而且 Hub、Chat with Files 都標示實驗性。我會先拿來玩、測速度,不會一更新就拿去客戶案子。另外「約 2 倍」是官方說法,實際會因為硬體與模型大小而不同,建議自己用手邊的機器量一次。
名詞小辭典
- MTP:公告沒有解釋;一般指讓模型一次預測多個字來加速。
- GGUF:一種常見的本機模型檔案格式,可用 llama.cpp 等工具載入。
- RAG:先從你的文件裡找出相關段落,再交給 AI 回答,所以能引用資料來源。
- 張量平行:把一個模型的運算拆給多張顯示卡一起做,以提高速度。
資料來源
常見問題
Unsloth Studio 是什麼?
Unsloth 推出的本機介面,可以下載模型、在自己的電腦上聊天、微調訓練,並提供相容 OpenAI 的 API 給其他程式使用。
MTP 是什麼?
官方沒有在這份公告中解釋;一般指讓模型一次預測多個字,以加快產生速度。公告只說 Gemma 4 搭配它約快 2 倍,且在 Studio 自動啟用。
哪些功能還是實驗性的?
公告明寫 Hub 與下載管理員、Chat with Files(RAG)都標示為實驗性,穩定度請自己評估。
接著讀
全部觀點 →Ollama 0.30.6 上架 Gemma 4 QAT 版本:同樣的模型,吃更少記憶體就能跑Ollama v0.30.6 新增 Gemma 4 全系列的 QAT(量化感知訓練)權重,標籤以 -qat 結尾,從 e2b 到 31b 共五款,目標是降低記憶體需求、讓模型在自己的電腦上跑得更順。閱讀 →Unsloth 0.1.43:CUDA 13.3 解掉「亂碼輸出」問題,Mac、Windows、AMD 的預編譯支援一起補齊Unsloth 在 5 月 31 日釋出 v0.1.43-beta。官方說 CUDA 13.3 解決了 CUDA 13.2 的亂碼輸出問題,並補強 Mac 與 Windows 的 llama.cpp 預編譯檔、AMD ROCm 支援,以及 Studio 的遠端 MCP 與 Gemini 串接。閱讀 →Unsloth Studio 0.1.42 更新:本地 AI 介面也能接 OpenAI、Anthropic,順便補上一批安全加固Unsloth 在 5 月 26 日釋出 v0.1.42-beta,Studio 介面現在能連 OpenAI、Anthropic 等雲端 API,也能接 vLLM、Ollama,並補強登入限流、路徑限制等安全設計。官方說大改版就在這一兩週內。閱讀 →