觀點 · 資訊分享
Ollama 0.30.6 上架 Gemma 4 QAT 版本:同樣的模型,吃更少記憶體就能跑
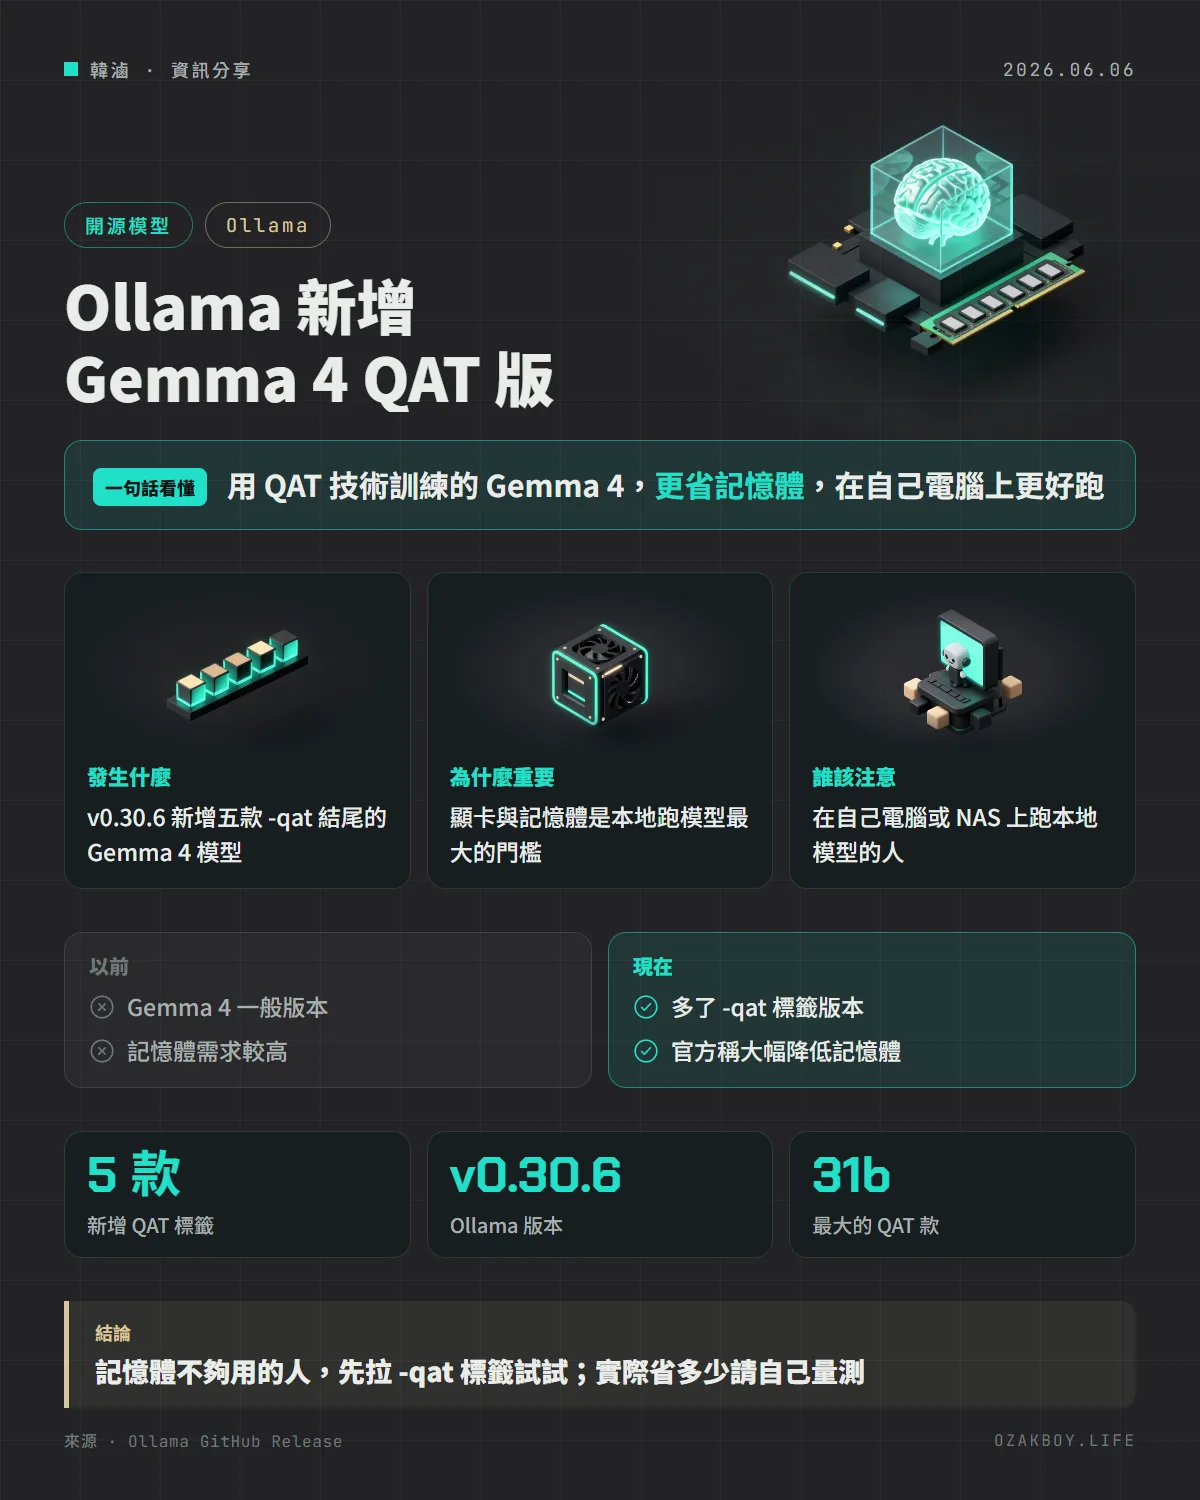
Ollama v0.30.6 新增 Gemma 4 全系列的 QAT(量化感知訓練)權重,標籤以 -qat 結尾,從 e2b 到 31b 共五款,目標是降低記憶體需求、讓模型在自己的電腦上跑得更順。
- 發布
- 2026-06-06
- 篇幅
- 約 3 分鐘 · 1,291 字
- 結構
- 7 節 + 3 題常見問題
- 標籤
一句話看懂:Ollama 0.30.6 新增 Gemma 4 的 QAT 版本,目標是讓同樣的模型吃更少記憶體,在自己的電腦上更好跑。
先用白話講:QAT 是什麼?
想像你要把一本很厚的字典縮印成口袋版。直接縮印,字會糊掉;比較好的做法,是從編字典的時候就想著「這本之後要縮印」,把內容寫得精簡又清楚。
AI 模型也是:模型裡是數十億個數字,要塞進比較小的記憶體,就得把每個數字記得粗略一點,這叫量化。QAT(量化感知訓練)就是在訓練的階段,讓模型提前習慣粗略的記法,縮小之後,表現通常比較不容易掉太多。
發生什麼事
Ollama 在 6 月 5 日釋出 v0.30.6。最值得注意的是新增 Gemma 4 QAT 權重:官方說 Gemma 4 系列現在以 QAT 最佳化,目的是大幅降低記憶體需求、發揮裝置端效能。
要找標籤結尾是 -qat 的版本,共五款:
| 標籤 | 說明 |
|---|---|
| gemma4:e2b-it-qat | 最小款 |
| gemma4:e4b-it-qat | 小型款 |
| gemma4:12b-it-qat | 中型款 |
| gemma4:26b-a4b-it-qat | 大型款 |
| gemma4:31b-it-qat | 最大款 |
同一個版本還有兩項更新:ollama launch omp 可以整合 Oh My Pi(官方形容為帶 IDE 整合的 AI 程式碼代理),以及 Apple Silicon 上 MLX 的嵌入層改用 NVFP4 全域縮放,改善量化表現。
誰會最有感?
- 記憶體或顯示記憶體不夠大,原本只能選比較小的模型的人,有機會改選更大一級的款式
- 想在筆電、迷你主機或 NAS 上跑本地模型的人
- 需要同時載入多個模型、記憶體容易吃緊的人
以上是依 QAT 的設計目的自行推論,官方發行說明沒有保證具體效果。
給開發者的技術細節
ollama pull gemma4:12b-it-qat
ollama run gemma4:12b-it-qat
- 標籤規則:前面是模型大小,
it代表指令調校版,qat代表量化感知訓練版 - 官方沒有在發行說明裡給出具體的記憶體數字或品質比較,要選哪一款,請用自己的資料與機器實測
- 想先確認版本,可以用
ollama --version,確認為 0.30.6 以上
我的看法
我自己在 NAS 和一台普通的桌機上跑本地模型,最常卡關的就是記憶體:模型一大就裝不下,裝得下又慢。如果 QAT 版真的能在差不多的品質下少吃記憶體,對沒有高階顯卡的人是很實在的好消息。
不過這則更新的證據只有官方一句「大幅降低」,我不會因此就直接把正在跑的服務換掉。比較穩妥的做法是另外拉一份來比:同一批問題,各跑一次,看速度、記憶體和答案品質,滿意再切換。
名詞小辭典
- 量化(Quantization):把模型的數字用較粗的精度儲存,換取更小的體積。
- QAT:量化感知訓練,在訓練時就考慮量化的影響,降低縮小後的品質損失。
- Gemma:Google 釋出的開放權重模型系列,可以在自己的電腦上執行。
- 標籤(Tag):Ollama 用來區分模型版本與大小的名稱後綴。